چگونه خروجی AI را راستیآزمایی کنیم؟
چارچوب عملی راستیآزمایی خروجی مدل: بررسی ادعا و منبع، تست کد، و کاهش اتکای بیش از حد — همراستا با OWASP و راهنماهای ارزیابی OpenAI.
بنیانگذار و مهندس محصول
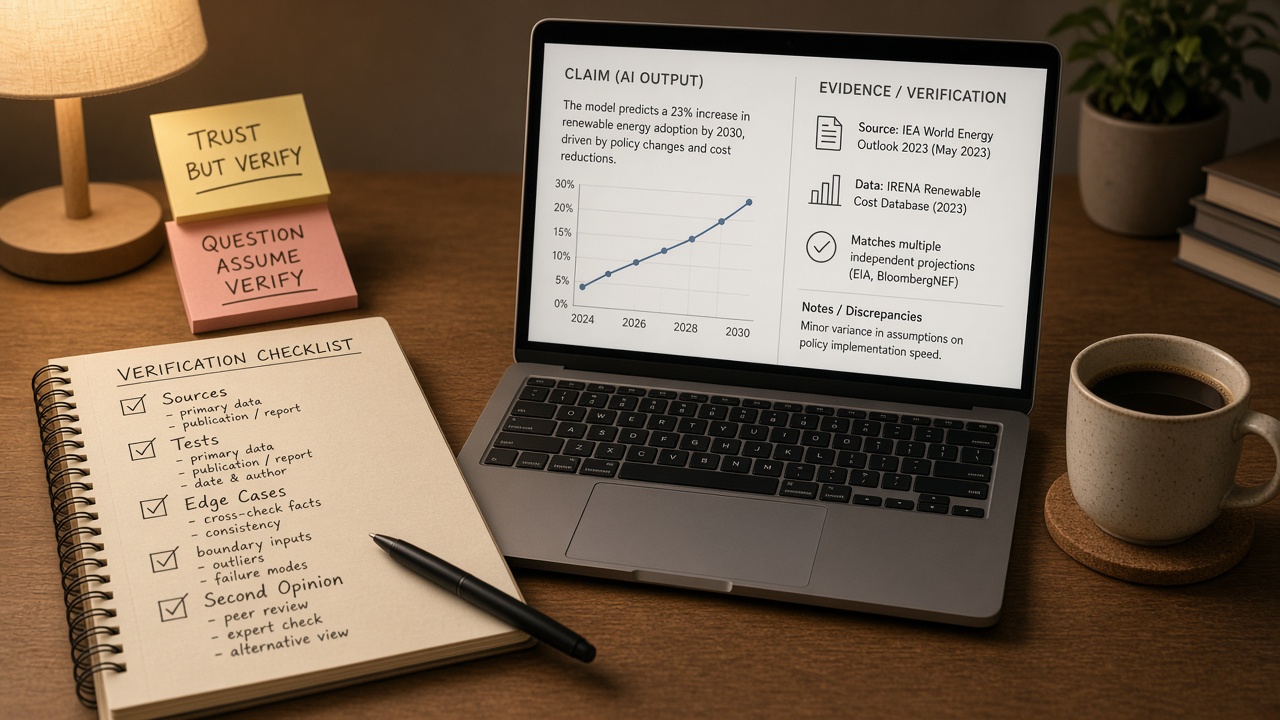
مدل میتواند غلط را با لحن مطمئن بگوید. اگر فقط روان بودن متن را بسنجید، خطا را امضا میکنید. راستیآزمایی یعنی قبل از استفاده در تصمیم، کد، یا پیام به مشتری، ادعاها، منابع و رفتار قابلاجرا را جداگانه چک کنید.
OWASP در ریسکهای مرتبط با اطلاعات نادرست و اتکای بیش از حد هشدار میدهد که نسنجیدن انتقادی خروجی میتواند به تصمیم معیوب، آسیب امنیتی و مسئولیت حقوقی برسد. OpenAI برای کارهای حساس نگهبانهایی مثل منبع، برچسب عدمقطعیت و ارزیابی کوچک توصیه میکند. این مقاله همان اصول را به چکلیست روزمره تبدیل میکند.
پاسخ کوتاه
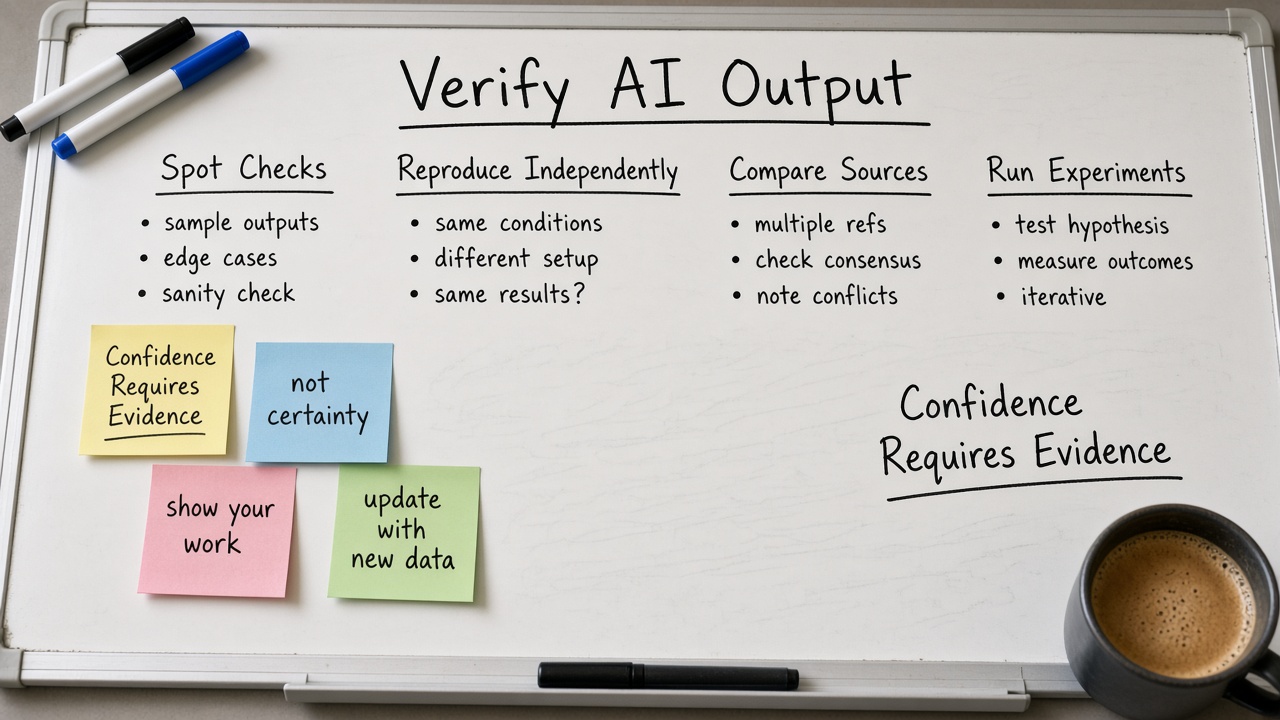
خروجی را در سه لایه بررسی کنید: Fact (آیا ادعا با منبع مستقل میخواند؟)، Code (آیا رفتار با تست و Review تأیید میشود؟)، Source (آیا ارجاع واقعی، در دسترس و همخوان است؟). برای کار کمریسک یک لایه کافی است؛ برای کار پرمخاطره هر سه لایه و تأیید انسان لازم است. اعتماد به لحن مدل جزء روش نیست.
راستیآزمایی جایگزین مدل نیست؛ جایگزین خوشباوری است.
چرا verification جدا از «پرامپت بهتر» است؟
پرامپت خوب احتمال خطا را کم میکند؛ verification خطا را قبل از اثر گرفتن میگیرد. حتی با scoping عالی (مقالهٔ ۱۳۸)، مدل میتواند جزئیات را پر کند، API منسوخشده پیشنهاد دهد، یا منبعی بسازد که وجود ندارد. مقالهٔ ۱۲۵ hallucination را توضیح میدهد؛ اینجا روی عمل بعد از دریافت خروجی تمرکز میکنیم.
NIST در نمایهٔ Generative AI برای AI RMF به ریسکهایی مثل confabulation و یکپارچگی اطلاعات اشاره میکند. سازمانها باید این ریسکها را Map/Measure/Manage کنند — یعنی فقط «کاربر مراقب باشد» کافی نیست؛ فرایند لازم است.
لایهٔ ۱: Fact check ادعاها
چه چیزی ادعا است؟
عدد، تاریخ، نام قانون، نسخهٔ کتابخانه، نقلقول، و رابطهٔ علّی («چون X پس Y») همه ادعایند. توصیهٔ سبکی («لحن را کوتاه کن») ادعا نیست. اول ادعاها را فهرست کنید.
روش عملی
- از مدل بخواهید ادعاهای قابلبررسی را بولت کند و کنار هر کدام منبع یا برچسب needs verification بگذارد.
- برای هر ادعای مهم یک منبع مستقل باز کنید: مستند رسمی، کد مخزن، تیکت، یا دادهٔ داخلی.
- اگر منبع پیدا نشد، ادعا را حذف یا به فرض تبدیل کنید — نه اینکه با اطمینان منتشر کنید.
- اختلافها را ثبت کنید؛ اینها خوراک بهبود پرامپت و eval میشوند.
OpenAI پیشنهاد میکند برای دقت، منبع بخواهید، عدمقطعیت را علامت بزنید، و با ۵ تا ۱۰ سؤال که جوابش را میدانید یک ارزیابی کوچک اجرا کنید. این ارزانترین تور ایمنی قبل از اتکای سازمانی است.
لایهٔ ۲: Code check
برای کد، متن توضیح ملاک نیست؛ رفتار ملاک است.
- تست واحد یا یک smoke test محلی برای مسیر تغییر.
- خواندن Diff مثل خروجی شخص ثالث (مقالهٔ ۱۲۹ و ۱۳۰).
- اجرای linter/typecheck اگر در مخزن هست.
- بررسی وابستگی جدید، مجوزها، و دستورهای مخرب در اسکریپت.
- چک کردن نسخهٔ API با مستند رسمی همان نسخه.
ضدالگو: Accept کردن پیشنهاد IDE چون «کامپایل شد». کامپایل نبودنِ خطاهای منطقی و امنیتی را تضمین نمیکند. اگر تست ندارید، حداقل یک ورودی خوشمسیر و یک ورودی نامعتبر دستی بزنید و نتیجه را یادداشت کنید.
لایهٔ ۳: Source check
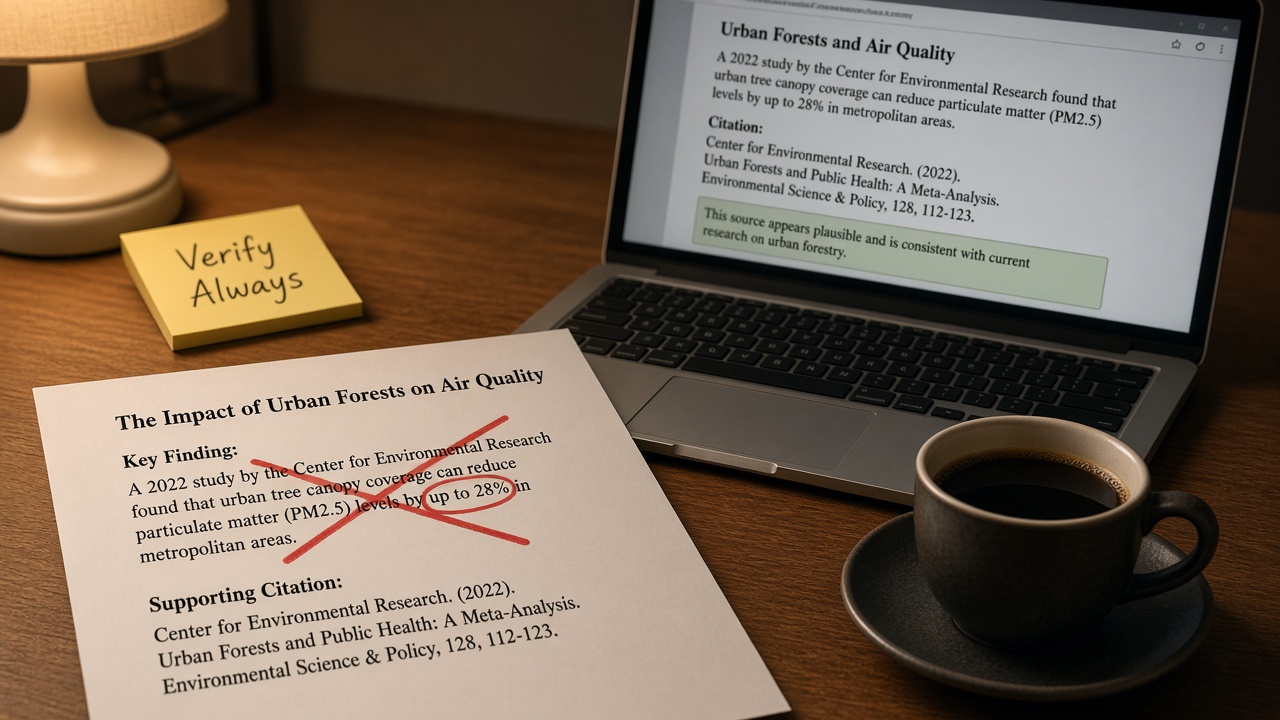
مدل گاهی URL یا عنوان مقاله میسازد. Source check یعنی:
- لینک را باز کنید؛ آیا زنده است؟
- آیا عنوان و نویسنده با ادعا میخواند؟
- آیا تاریخ و نسخه با موضوع شما مرتبط است؟
- آیا نقلقول داخل منبع وجود دارد یا فقط شبیه است؟
برای دانش داخلی شرکت، منبع باید سیستم رسمی باشد (ویکی مالکدار، Runbook، قرارداد)، نه خلاصهٔ چت دیروز. اگر مدل از فایل شما نقل میکند، نقل را با جستوجوی متن در همان فایل تطبیق دهید.
ماتریس ریسک: چقدر سختگیری لازم است؟
| نوع خروجی | حداقل verification | چه کسی امضا میکند |
|---|---|---|
| پیشنویس داخلی کماثر | خواندن سریع + علامت فرضها | نویسنده |
| پیام به مشتری | Fact + Source + لحن برند | صاحب محصول/پشتیبانی |
| کد غیرحیاتی | Diff + تست دود | Reviewer |
| کد پرداخت/هویت/امنیت | تست هدفمند + Review متخصص | مالک فنی + امنیت |
| تصمیم مالی/حقوقی | منبع اولیه + انسان متخصص | نقش مسئول تصمیم |
سختگیری را با اضطراب شخصی تنظیم نکنید؛ با اثر شکست تنظیم کنید. یک خطای کوچک در اسکریپت migration میتواند از ده صفحهٔ وبلاگ پرریسکتر باشد.
الگوی خودآزمایی قبل از پایان پاسخ
میتوانید در انتهای پرامپت یک checklist بخواهید — OpenAI نمونهای شبیه این پیشنهاد میدهد:
Check the output for: - Accuracy: از ساختن واقعیت پرهیز شده؟ - Completeness: نکات اجباری آمده؟ - Format: با قالب خواستهشده میخواند؟ - Tone: مناسب مخاطب است؟ - Assumptions: حدسها برچسب خوردهاند؟
این خودآزمایی جایگزین Fact/Code/Source انسانی نیست؛ فقط خطاهای سطحی را زودتر نشان میدهد. برای تولید، بهتر است grader خودکار و مجموعهٔ طلایی داشته باشید.
از راستیآزمایی دستی تا eval سیستمی
OpenAI evaluation flywheel سه حرکت دارد: Analyze (بفهمید چرا شکست)، Measure (متریک و grader)، Improve (پرامپت/سیستم را عوض کنید و دوباره بسنجید). ترجمهٔ تیمی:
- هفتهای یکبار نمونههای شکست را برچسب بزنید (ادعا غلط، کد شکننده، منبع جعلی).
- ۱۰ تا ۵۰ مورد طلایی بسازید که جواب مورد انتظار دارند.
- قبل از عوض کردن مدل یا پرامپت، همان مجموعه را اجرا کنید.
- اگر متریک افت کرد، انتشار را متوقف کنید — مثل تست رگرسیون نرمافزار.
بدون این حلقه، هر «بهبود پرامپت» فقط سلیقه است.
نشانههای خروجی پرریسک
- اعداد دقیق بدون منبع.
- عبارتهای مطلق: همیشه، هرگز، قطعاً — در حوزهٔ مبهم.
- کد طولانی بدون تست و بدون توضیح ریسک.
- ارجاع به مقاله یا CVE که جستوجو نمیشود.
- ادغام چند درخواست در یک پاسخ با جزئیات زیاد و سطحی.
اشتباههای رایج verification
- فقط از خود مدل پرسیدن «آیا مطمئنی؟» بدون منبع مستقل.
- قبول منبع چون دامنه معروف است، بدون خواندن بخش مرتبط.
- تست نکردن مسیر خطا.
- یکی دانستن «اجرا شد» با «درست است».
- حذف verification وقتی عجلهٔ دمو دارید — درست وقتی خطا گران است.
نمونهٔ گردش کار ۳۰ دقیقهای برای گزارش
- خروجی را بگیرید و ادعاها را هایلایت کنید (۵ دقیقه).
- سه ادعای پراثر را با منبع چک کنید (۱۰ دقیقه).
- فرضها و موارد needs verification را در سند نهایی بگذارید (۵ دقیقه).
- اگر قرار است تصمیم گرفته شود، یک نفر دوم همان سه ادعا را ببیند (۱۰ دقیقه).
این گردش برای گزارش مدیریتی و خلاصهٔ تحقیق خوب است. برای کد، زمان را به Diff و تست منتقل کنید.
راستیآزمایی در IDE و Agent
وقتی Coding Agent چند فایل را عوض میکند، verification باید به اندازهٔ قدرت ابزار سختگیر باشد. اول فهرست فایلهای لمسشده را با واقعیت Diff تطبیق دهید. بعد تست محدوده را اجرا کنید. بعد برای مسیرهای امنیتی، secretها و دسترسی شبکه را جداگانه مرور کنید. Agent سریعتر اشتباه را هم پخش میکند.
قید مفید در پرامپت Agent: «قبل از پایان، فرضها را فهرست کن و بگو کدام بخش را تست کردی». باز هم اجرا را خودتان ببینید.
تفاوت verification با سانسور خلاقیت
هدف خفه کردن ایدهزایی نیست. در مرحلهٔ brainstorm آزاد باشید؛ در مرحلهٔ انتشار قفل کنید. خیلی از تیمها این دو مرحله را قاطی میکنند و یا همهچیز را بیبررسی منتشر میکنند یا از ترس، کلاً از مدل استفاده نمیکنند. مرز را در فرایند بگذارید نه در اضطراب فردی.
ارتباط با مقالات سری
سوالات متداول
آیا مدل دوم میتواند مدل اول را verify کند؟
بهعنوان کمک برای یافتن ناسازگاری مفید است، اما منبع حقیقت مستقل نیست. برای ادعاهای مهم به داده یا مستند بیرونی برگردید.
برای ترجمه یا بازنویسی لحن چه کنیم؟
اگر محتوای معنایی نباید عوض شود، چند جملهٔ کلیدی را با متن مبدأ مقایسه کنید و اعداد/نامها را قفل کنید. Fact check سبکتر است اما صفر نیست.
حداقل eval سازمانی چیست؟
یک مجموعهٔ کوچک از موارد واقعی شکستخورده + چکلیست انسانی + قانون «بدون عبور از checklist، نه به مشتری نه به main». بعداً grader اضافه کنید.
اگر وقت verification نداریم؟
دامنه را کوچک کنید یا انتشار را عقب بیندازید. حذف verification در کار پرریسک صرفهجویی نیست؛ انتقال ریسک به آینده است.
چکلیست ویژهٔ نقلقول و آمار
آمار بدون سال، نمونه، و تعریف متریک تقریباً همیشه مشکوک است. اگر مدل گفت «بیشتر شرکتها»، بپرسید کدام جمعیت و کدام منبع. اگر گفت «مطالعه نشان داد»، نام مطالعه، سال و اندازهٔ نمونه را بخواهید و بعد خودتان پیدا کنید. در مقالهٔ ۱۴۱ میبینید حتی مطالعات معتبر هم محدودهٔ تعمیم دارند؛ پس نقل ناقص خطرناکتر از ندانستن است.
برای نقلقول: متن را در منبع جستوجو کنید. شباهت معنایی کافی نیست. اگر منبع پشت paywall است و نمیتوانید ببینید، ادعا را در متن عمومی بهعنوان تأییدنشده علامت بزنید یا حذف کنید.
راستیآزمایی پاسخهای چندمرحلهای و زنجیرهٔ استدلال
وقتی مدل «قدمبهقدم» استدلال میکند، هر قدم را جدا بسنجید. خطای کوچک در فرض اول میتواند نتیجهگیری نهایی را درستنما کند. تکنیک ساده: از مدل بخواهید فرضها را از نتیجهها جدا بنویسد؛ شما فقط فرضها را verify کنید. اگر فرض غلط بود، نتیجهگیری را دور بریزید حتی اگر لحن منطقی باشد.
در تحلیل ریشهٔ باگ، این جداسازی حیاتی است. فرض «پس مشکل از کش است» باید با یک مشاهده تأیید شود نه با داستان زیبا.
ابزارهای کمکی؛ نه قاضی نهایی
- جستوجوی وب و مستند رسمی برای Fact/Source.
- اجرای تست و sandbox برای Code.
- اسکنر secret برای خروجیهایی که ممکن است کلید داشته باشند.
- LLM-as-judge فقط با rubric صریح و نمونهٔ طلایی — و بازبینی انسانی دورهای.
ابزارهای خودکار مقیاس میدهند؛ مسئولیت را منتقل نمیکنند. اگر grader اشتباه پاداش بدهد، سیستم سریعتر غلط را صنعتی میکند.
ثبت شواهد verification
برای کارهای تکراری، یک قالب کوتاه در PR یا سند بگذارید: چه ادعاهایی چک شد، لینک منبع، نتیجهٔ تست، و موارد باز. این کار onboarding را سریع و حسابرسی را ممکن میکند. وقتی حادثه رخ دهد، میفهمید آیا verification نبود یا ناکافی بود.
تیمهایی که فقط در چت خصوصی verify میکنند، حافظهٔ سازمانی نمیسازند و هر بار از صفر ریسک را کشف میکنند.
حداقل استاندارد شخصی قبل از انتشار
اگر در سازمان هنوز سیاست رسمی ندارید، این کف شخصی را رعایت کنید: هیچ عدد و نام خاصی بدون منبع؛ هیچ Diff بدون اجرای حداقل یک تست مرتبط؛ هیچ پیام مشتری بدون خواندن کامل؛ و هر جا شک دارید برچسب needs verification. این چهار خط جلوی بخش بزرگی از حوادث ناشی از خوشباوری را میگیرد تا سیاست رسمی برسد.
بعداً همین کف را به قالب تیمی و دروازهٔ CI تبدیل کنید. verification وقتی ارزشمند است که پیشفرض باشد نه قهرمانی فردی.
خلاصه
راستیآزمایی خروجی AI سه لایه دارد: Fact، Code، Source — با شدت متناسب با اثر شکست. خودآزمایی داخل پرامپت کمک میکند اما جایگزین شاهد مستقل نیست. برای بلوغ تیمی، شکستها را به eval و دروازهٔ رگرسیون تبدیل کنید. لحن مطمئن مدل هیچگاه سند صحت نیست.
منابع و مراجع
- OWASP GenAI — LLM Top 10 / Misinformation & related risks — https://genai.owasp.org/
- OWASP — Top 10 for Large Language Model Applications (project hub) — https://owasp.org/www-project-top-10-for-large-language-model-applications/
- OpenAI Cookbook — ChatGPT Enterprise Prompting Guide (Improve accuracy) — https://developers.openai.com/cookbook/examples/chatgpt/chatgpt_prompt_guide/chatgpt_prompt_guide
- OpenAI Cookbook — Building resilient prompts using an evaluation flywheel — https://developers.openai.com/cookbook/examples/evaluation/building_resilient_prompts_using_an_evaluation_flywheel
- NIST — AI Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1) — https://doi.org/10.6028/NIST.AI.600-1
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.