چگونه از هوش مصنوعی استفاده کنیم بدون اینکه کیفیت کار پایین بیاید؟
چارچوب عملی برای حفظ کیفیت هنگام کدنویسی با AI: تعریف Done، تست، Review انسانی، محدودیت زمینه، و جلوگیری از بدهی فنی پنهان.
بنیانگذار و مهندس محصول
ابزارهای کدنویسی با هوش مصنوعی سرعت تولید را بالا میبرند؛ کیفیت را خودبهخود تضمین نمیکنند. پیشنهاد مدل میتواند تستنداشته، الگوی ناامن، وابستگی قدیمی، یا راهحلی باشد که فقط در همان پنجرهٔ چت درست به نظر میرسد. افت کیفیت معمولاً ناگهانی نیست: چند PR سطحی، کم شدن Review واقعی، و عادت «اگر اجرا شد یعنی تمام است».
این مقاله یک چارچوب عملی است تا AI را مثل همکار تازهکار قوی اما بیمسئولیت ببینید: خروجی میدهد، شما مالک کیفیت میمانید. مبنای مفهومی با NIST AI RMF همراستاست: اندازهگیری، نظارت انسانی، و مدیریت ریسک قبل از گسترش استفاده.
مخاطب این متن هم برنامهنویس فردی است هم تیمی که میخواهد سرعت بگیرد بدون اینکه Production شکننده شود.
پاسخ کوتاه
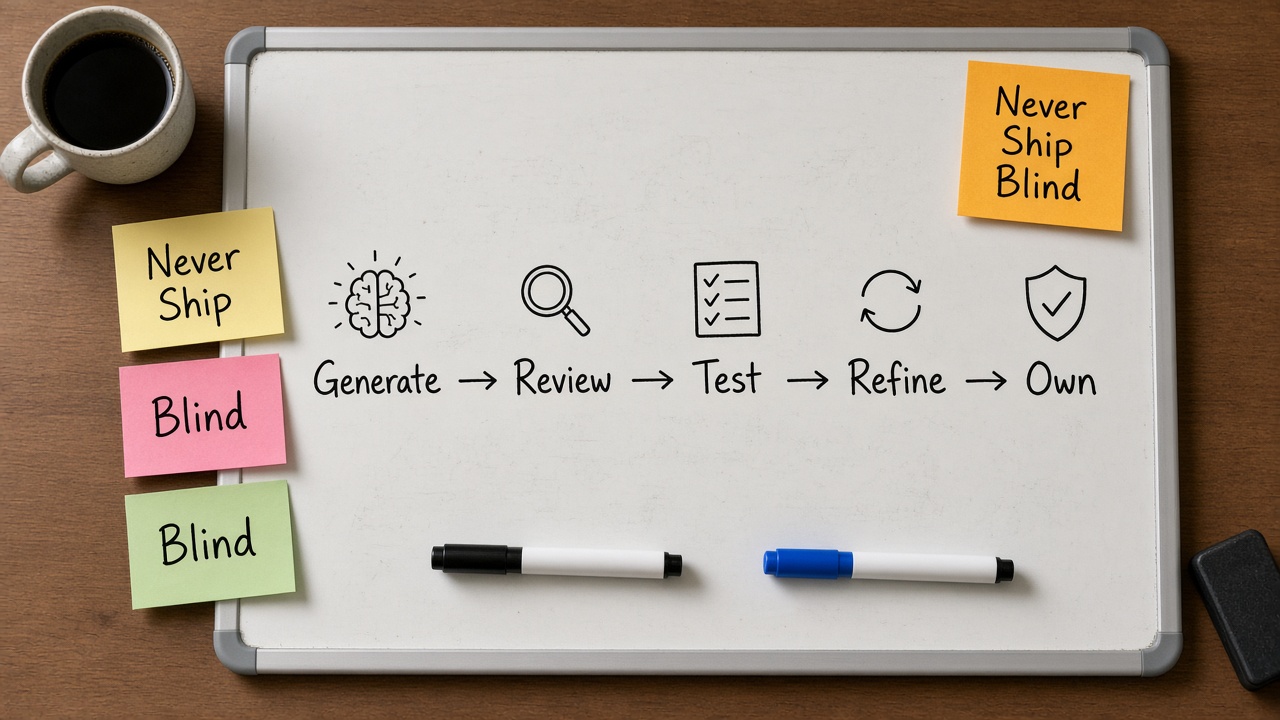
کیفیت را با سه قفل نگه دارید: تعریف روشن Done (Acceptance Criteria و تست)، Review انسانی روی Diff واقعی، و ممنوعیت Merge برای خروجی تاییدنشدهٔ Agent. AI را برای پیشنویس، boilerplate، توضیح کد و پیشنهاد تست به کار ببرید؛ تصمیم معماری، مرز امنیتی و پذیرش ریسک را خودتان بگیرید.
سرعت بدون معیار پذیرش فقط بدهی را زودتر تولید میکند.
چرا کیفیت با AI میتواند پایین بیاید؟
- توهم اعتماد: متن روان مدل باعث میشود باگ منطقی دیده نشود.
- زمینهٔ ناقص: مدل بخشی از سیستم را ندیده و قراردادهای تیم را رعایت نمیکند.
- کپی الگوی ناامن: SQL injection، hard-coded secret، یا وابستگی منسوخ.
- کاهش یادگیری: اگر فقط Accept بزنید، توانایی Debug تیم ضعیف میشود.
- گسترهٔ بیش از حد: یک پرامپت «کل فیچر را بساز» بدون برش به کارهای قابل Review.
OWASP در ریسکهای LLM روی مدیریت نادرست خروجی و اتکای بیش از حد تأکید دارد: خروجی مدل را مثل ورودی نامطمئن به سیستم بعدی بدهید، نه حقیقت نهایی.
چارچوب چهار لایه برای حفظ کیفیت
۱) قبل از پرامپت: مشخص کنید Done چیست
بدون Acceptance Criteria، مدل بهینه میکند برای «چیزی که شبیه کار میکند». قبل از شروع بنویسید: رفتار مورد انتظار، حالت خطا، محدودیت عملکرد، و تستهایی که باید سبز شوند. این همان منطق مقالهٔ ۰۶۴ است؛ AI آن را ضروریتر میکند نه اختیاریتر.
۲) حین تولید: زمینه را کنترل کنید
بهجای Paste کردن کل مخزن در چت عمومی، فایلها و قراردادهای مرتبط را محدود کنید. در ابزارهایی مثل Claude Code از CLAUDE.md برای استاندارد تیم استفاده کنید؛ در Copilot از custom instructions؛ در Cursor از Rules. زمینهٔ درست کیفیت را بالا میبرد و نشت اطلاعات را کم میکند.
۳) بعد از تولید: Review مثل کد شخص ثالث
GitHub در توضیحات رسمی Copilot تأکید میکند این ابزار جایگزین برنامهنویس نیست و باید با همان دقت کد شخص ثالث بررسی شود. Diff را خطبهخط ببینید، نه فقط خلاصهٔ Agent. روی مسیرهای حساس (auth، پرداخت، مهاجرت دیتابیس) Review دوم اجباری کنید.
۴) بعد از Merge: اندازهگیری کنید
NIST AI RMF تابع MEASURE را جدی میگیرد: بدون متریک، نمیفهمید AI کمک کرده یا خسارت زده. متریکهای ساده: نرخ شکست CI بعد از PRهای AI-heavy، تعداد Rollback، زمان رفع باگ، پوشش تست مسیرهای جدید، و تعداد یافتههای امنیتی.
جدول نقش انسان و AI
| کار | نقش مناسب AI | نقش اجباری انسان |
|---|---|---|
| Scaffold و boilerplate | پیشنویس سریع | تأیید ساختار و قرارداد نامگذاری |
| باگ با stack trace واضح | پیشنهاد علت و Patch | بازتولید، تست رگرسیون |
| تصمیم معماری | گزینهها و trade-off | انتخاب نهایی و مستند تصمیم |
| کد امنیتی/پرداخت | مرور اولیه | Review متخصص + تست امنیتی |
| نوشتن تست | پیشنهاد caseها | تأیید اینکه تست رفتار درست را قفل میکند نه پیادهسازی غلط |
عادتهای روزانه که کیفیت را نگه میدارند
- هر جلسهٔ Agent را به یک هدف کوچک محدود کنید؛ بعد تست؛ بعد جلسهٔ بعدی.
- قبل از Accept، از مدل بخواهید Diff را توضیح دهد و ریسکها را لیست کند — بعد خودتان صحت را چک کنید.
- تست را قبل یا همراه فیچر بخواهید؛ تستی که فقط همان خروجی مدل را تأیید میکند کافی نیست.
- اگر چیزی را نفهمیدید Merge نکنید؛ فهم ناقص = مالکیت ناقص.
- الگوی تکرارشونده را به Rule/Skill تیمی تبدیل کنید تا کیفیت وابسته به حافظهٔ فردی نباشد.
ضدالگوها
- Vibe coding بدون تست روی مسیر پول یا هویت کاربر.
- خاموش کردن lint/typecheck چون Agent «گفت درست است».
- PRهای هزارخطی تولیدشده در یک نشست بدون برش Reviewپذیر.
- استفاده از مدل برای بازنویسی کل ماژول حیاتی در یک مرحله.
- سنجش موفقیت فقط با «زمان کدنویسی کمتر» بدون نگاه به Incident.
برای Tech Lead: سیاست حداقلی تیم
یک صفحهٔ کوتاه کافی است: ابزارهای مجاز، وضعیت Privacy، ممنوعیت Secret در پرامپت، چه مسیرهایی Auto-run ندارند، و چه PRهایی نیاز به Review انسانی مضاعف دارند. این سیاست را در onboarding بگذارید. بدون آن، هر فرد استاندارد خودش را اختراع میکند و کیفیت میانگین پایین میآید.
پایلوت دو هفتهای روی یک سرویس کمریسک اجرا کنید. اگر متریکها بدتر شد، ابزار را عوض نکنید — فرآیند را اصلاح کنید. اغلب مشکل از نبود معیار پذیرش است نه از مدل.
جمعبندی برای تصمیم
AI کیفیت را نمیدزدد؛ شما وقتی کیفیت را رها میکنید که Review و تست را با «اعتماد به متن روان» عوض کنید. با تعریف Done، زمینهٔ کنترلشده، Review واقعی و متریک، میتوانید سرعت بگیرید و استاندارد را نگه دارید.
اگر فقط یک تغییر این هفته میدهید: هیچ PR تولیدشده با Agent بدون تست سبز و توضیح Diff ادغام نشود.
تعریف عملی «کیفیت کافی» برای کارهای AI-assisted
کیفیت یک شعار نیست؛ مجموعهای از شرطهای قابل رد شدن است. برای هر کارت بکهالگ که با AI انجام میشود حداقل اینها را بنویسید: رفتار خوشمسیر، رفتار خطا، تأثیر روی دادهٔ موجود، و تستی که شکستش Merge را متوقف کند. اگر شرطی قابل اندازهگیری نیست، مدل و انسان هر دو میتوانند خودشان را قانع کنند که کار تمام شده است.
برای کارهای UI، کیفیت شامل حالتهای خالی، خطا و بارگذاری است — همان موضوع مقالههای ۹۳ و ۹۴. مدل اغلب فقط مسیر خوش را میسازد. صریحاً بخواهید حالتهای شکست را هم پیاده و تست کند.
برای کارهای داده، کیفیت یعنی مهاجرت برگشتپذیر، قفل تراکنش درست، و عدم فرض روی ترتیب نامطمئن. اینجا Review انسانی با تجربهٔ دامنه جایگزینناپذیر است.
جلسهٔ کاری پیشنهادی ۹۰ دقیقهای
- ۱۵ دقیقه: شکستن کار به زیرهدفها و نوشتن AC کوتاه.
- ۲۵ دقیقه: تولید پیشنویس با AI روی زیرهدف اول؛ بدون پرش به کل فیچر.
- ۲۰ دقیقه: اجرای تست/lint و اصلاح توسط خودتان یا با پرامپت محدود.
- ۲۰ دقیقه: Review Diff و بازنویسی بخشهای مبهم به زبان خودتان.
- ۱۰ دقیقه: یادداشت الگوهای تکراری برای Rule تیمی.
اگر جلسه را بدون AC شروع کنید، دقیقههای بعد صرف گفتوگوی بیهدف با مدل میشود. اگر Review را حذف کنید، دقیقههای بعداً در Incident برمیگردد.
متریکهایی که گمراهکنندهاند
- تعداد خط تولیدشده: تشویق به پرگویی و کپی.
- تعداد Acceptها: فقط نشان میدهد سریع دکمه زدهاید.
- زمان تا اولین PR: بدون کیفیت، فقط سرعت بدهی است.
متریکهای بهتر: درصد PRهای AI-assisted که در Review اول بدون تغییر امنیتی/منطقی جدی قبول میشوند؛ تعداد باگهای بازگشتی در مسیرهای AI-touched؛ میانگین زمان بازیابی وقتی پیشنهاد مدل غلط بوده است.
کیفیت در تیم دورکار و چندابزاره
وقتی هر فرد ابزار متفاوتی دارد، استاندارد مشترک مهمتر از برند مدل است. یک قالب PR الزامی کنید: خلاصهٔ تغییر، ریسک، تست انجامشده، و اینکه کدام بخش توسط AI پیشنهاد شده. این شفافیت شرم نیست؛ امکان Review هدفمند است.
برای دانش سازمانی، خروجی مدل را جایگزین مستند نکنید. اگر Agent معماری را «توضیح داد»، نسخهٔ تأییدشده را در README یا ADR بنویسید. در غیر این صورت جلسهٔ بعد مدل دیگری همان را جور دیگر میگوید.
مرز یادگیری و بهرهوری
استفادهٔ سالم از AI یادگیری را میکشد اگر فقط Accept کنید؛ میتواند یادگیری را تندتر کند اگر از مدل بخواهید فرضها را روشن کند، گزینهها را مقایسه کند، و بعد خودتان یکی را پیاده یا حداقل Diff را خطبهخط مالک شوید. قانون سرانگشتی: چیزی را Merge نکنید که نمیتوانید بدون مدل برای همکار توضیح دهید.
برای Juniorها، سیاست دوگانه مفید است: AI برای توضیح و تمرین مجاز؛ برای مسیرهای Production فقط با Pair یا Review ارشد. این از هم افت کیفیت جلوگیری میکند و هم از توهم مهارت.
نمونهٔ Rubric کوتاه برای Review
یک Rubric یکصفحهای روی دیوار تیم بیشتر از یک ابزار جدید کیفیت میآورد. مثال حداقل: آیا تغییر با AC مطابقت دارد؟ آیا تست مسیر خطا هست؟ آیا Secret یا دادهٔ واقعی وارد شده؟ آیا نامگذاری و ساختار با قرارداد مخزن یکی است؟ آیا عملکرد یا مهاجرت ریسک دارد؟ هر «نه» یعنی درخواست تغییر، نه مذاکرهٔ احساسی.
برای PRهای بزرگ تولیدشده با Agent، Review را دو مرحله کنید: اول معماری و مرزها، دوم جزئیات پیادهسازی. یک مرور هزار خط در نیمساعت فقط توهم اطمینان است.
ابزار کیفیت که باید کنار AI روشن بمانند
- Typechecker و linter در pre-commit و CI.
- تست واحد و حداقل یک تست یکپارچه برای مسیر اصلی.
- SCA و اسکن وابستگی برای پیشنهادهای کتابخانهای مدل.
- Secret scanning برای جلوگیری از Commit کلید.
- Preview محیط برای تغییرات UI قبل از Merge.
AI جای اینها را نمیگیرد؛ گاهی آنها را دور میزند اگر اجازه دهید. سیاست تیم باید بگوید شکست این دروازهها Merge را میبندد، حتی اگر مدل اصرار کند «درست است».
جمعبندی اجرایی برای هفتهٔ اول
روز اول: قالب AC و قالب PR را بهروز کنید. روز دوم: روی یک فیچر کمریسک جلسهٔ ۹۰ دقیقهای را تمرین کنید. روز سوم: متریک پایه (نرخ برگشت PR، شکست CI) را ثبت کنید. روز چهارم: Ruleهای تکراری را از گفتوگوهای موفق استخراج کنید. روز پنجم: یک ضدالگو را در جلسهٔ تیم نمایش دهید. بعد از یک اسپرینت، تصمیم بگیرید کجا AI مجاز به پیشنهاد Merge-ready است و کجا فقط پیشنویس.
خط قرمزهای کیفیت که نباید با AI جابهجا شوند
مسیر احراز هویت، پرداخت، حذف داده، و مجوزها را هرگز فقط با اعتماد به خلاصهٔ Agent Merge نکنید. اینجا هزینهٔ اشتباه مستقیم به کاربر و کسبوکار میخورد. AI میتواند پیشنویس بدهد، اما مالکیت تغییر با انسانی است که Diff را فهمیده و تست مرزی نوشته است.
تغییرهای طرحوارهٔ دیتابیس Production نیازمند برنامهٔ برگشت و پنجرهٔ نگهداریاند، نه یک پرامپت عصر جمعه. مدل معمولاً خوشبین است؛ عملیات باید بدبین باشد.
اگر تیم خسته یا زیر فشار موعد است، خطر Accept بیReview بیشتر میشود. سیاست کیفیت مخصوصاً برای همان لحظهها نوشته میشود. اجازه ندهید استثناهای مکرر به عرف تبدیل شوند.
در پایان هر اسپرینت پنج دقیقه صرف مرور «کجا AI کیفیت را بالا برد و کجا پنهان کرد» کنید. این بازخورد کوتاه از خرید ابزار جدید مؤثرتر است.
- AC بدون ابهام قبل از پرامپت بلند.
- تست شکستپذیر نه تست تأیید تعارفآمیز.
- Review روی Diff نه روی داستان Agent.
- متریک بعد از Merge نه فقط حس سرعت.
یک تمرین مفید: ماهانه یک PR را که با AI ساخته شده در جلسهٔ تیم باز کنید و با صدای بلند Diff را بخوانید. این کار استاندارد ذهنی میسازد و جلوی عادیسازی اشتباههای تکراری را میگیرد.
اگر کیفیت افتاد، اول فرآیند را متهم کنید نه مدل را. معمولاً AC نبوده، Review سطحی بوده، یا متریک اشتباه تشویق شده است.
منابع و مراجع
- NIST AI Risk Management Framework (AI RMF 1.0) — NIST — https://www.nist.gov/itl/ai-risk-management-framework
- NIST AI 100-1 PDF — NIST — https://doi.org/10.6028/NIST.AI.100-1
- GitHub Copilot Plans (responsible use / not a replacement) — GitHub — https://github.com/features/copilot/plans
- Claude Code Security (permission review) — Anthropic — https://code.claude.com/docs/en/security
- OWASP Top 10 for LLM Applications / GenAI — OWASP — https://owasp.org/www-project-top-10-for-large-language-model-applications/
- OWASP GenAI LLM Top 10 hub — OWASP GenAI — https://genai.owasp.org/llm-top-10/
استاندارد تیم را بنویسید و همان را معیار کیفیت قرار دهید؛ ابزار فقط شتابدهنده است.
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.