چرا نباید خروجی AI را بدون Review وارد Production کنیم؟
دلایل فنی ممنوعیت Ship کردن خروجی مدل بدون Review: باگ منطقی، امنیت، رگرسیون، و ارجاع به OWASP LLM10 و NIST AI RMF.
بنیانگذار و مهندس محصول
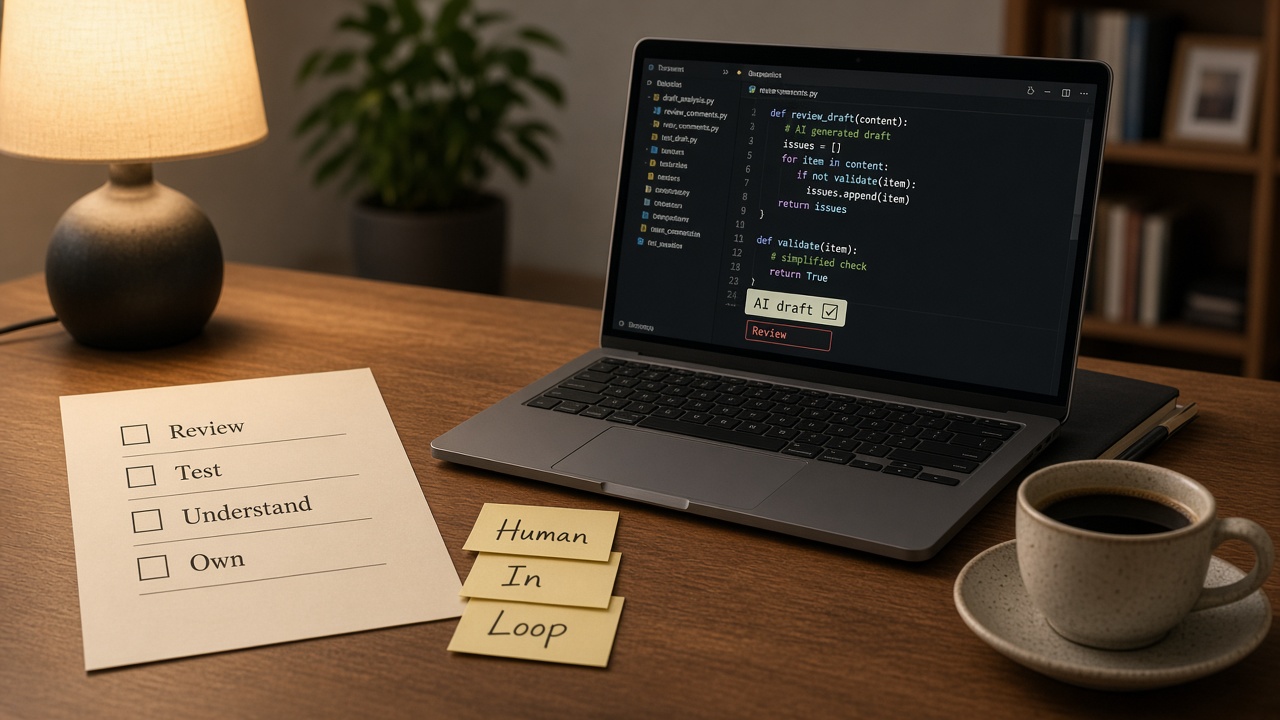
جملهای که بعد از یک نشست طولانی با Agent وسوسهانگیز است: «تست سبز شد، Deploy کنیم.» متن روان، Diff تمیزبهنظر، و فشار موعد دست به دست هم میدهند تا Review را «تشریفات» ببینید. هزینهٔ این میانبر معمولاً ساعتها بعد در Production ظاهر میشود: باگ منطقی، حفرهٔ امنیتی، یا رگرسیونی که تستهای موجود نمیدیدند.
OWASP در سناریوی LLM10:2026 Improper Output Handling صریحاً به کاربردهایی اشاره میکند که کد تولیدشده توسط مدل را بدون بازبینی انسانی یا تست امنیتی بهطور خودکار کامپایل و Deploy میکنند و در نتیجه کد ناامن به Production میرسد. این مقاله همان هشدار را به زبان تیم نرمافزار ترجمه میکند: باگ، امنیت، رگرسیون، منطق.
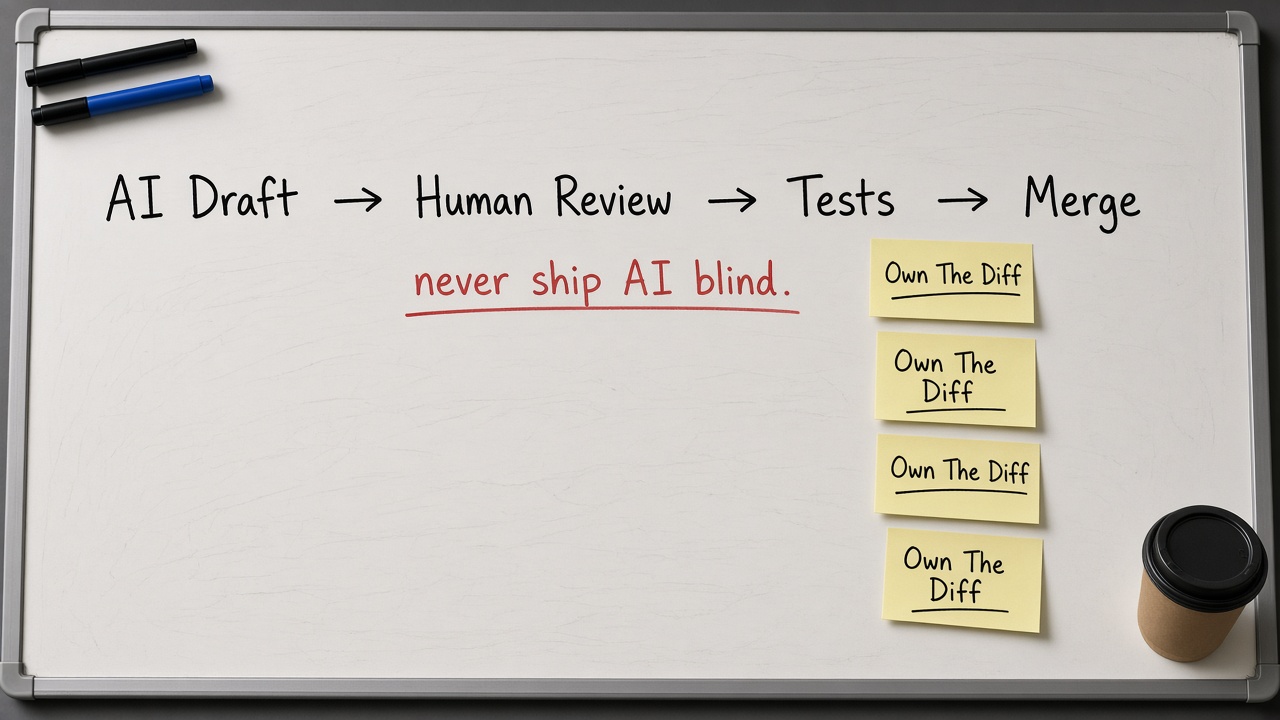
پاسخ کوتاه
خروجی مدل ورودی نامطمئن است—حتی وقتی زیبا و «مطمئن» به نظر میرسد. بدون Review انسانی روی Diff، بدون تست متناسب با رفتار جدید، و بدون دروازهٔ CI، خطر باگ منطقی، تزریق/سوءاستفاده، رگرسیون پنهان و تصمیم تجاری غلط را به کاربران منتقل میکنید. AI را برای پیشنویس نگه دارید؛ مجوز ورود به Production را به انسان و کنترلهای فنی بدهید.
اعتماد به لحن مدل جایگزین مالکیت تغییر نمیشود.
چرا مغز ما گول میخورد؟
- روان بودن متن ≠ درست بودن ادعا (Misinformation / confabulation در ادبیات OWASP و NIST).
- سبز شدن تستهای قدیمی ≠ پوشش رفتار جدید.
- خلاصهٔ Agent از Diff ≠ دیدن همهٔ خطوط حساس.
- فشار زمان باعث میشود Accept به عادت تبدیل شود.
NIST AI 600-1 ریسکهای ویژهٔ Generative AI از جمله confabulation را در چارچوب GOVERN/MAP/MEASURE/MANAGE میگذارد. یعنی سازمان باید بداند کجا خروجی مدل به تصمیم یا سیستم پاییندستی وصل میشود و آنجا کنترل بگذارد—نه اینکه به «احساس درستی» تکیه کند.
۱) باگها و خطاهای منطقی
مدل در تکمیل الگوهای رایج قوی است؛ در قیدهای دامنهٔ شما ضعیف. مثالهای تکراری:
- شرط مرزی off-by-one در محاسبهٔ سقف تخفیف.
- ترتیب اشتباه بررسی مجوز و بارگذاری داده (IDOR پنهان).
- Retry بدون idempotency روی پرداخت.
- فرض timzone یا locale که فقط در محیط توسعهدهنده درست کار میکند.
- تغییر نام فیلد در یک سرویس و جا ماندن مصرفکننده.
اینها اغلب lint را رد میکنند و حتی unit test خوشمسیر را سبز میگذارند. Review انسانی با سؤال «اگر ورودی خالی/منفی/تکراری باشد چه؟» همان لایهای است که مدل از قلم میاندازد.
۲) امنیت
LLM10 میگوید خروجی مدل را مثل ورودی کاربر با رویکرد zero-trust به اجزای پاییندستی بدهید: اعتبارسنجی، parameterization برای SQL، encoding متناسب زمینه، و جلوگیری از اجرای مستقیم در shell/eval. اگر Agent تکهای SQL، مسیر فایل، یا فرمان ساخت پیشنهاد داد و شما بدون بررسی در pipeline گذاشتید، سطح حمله را باز کردهاید.
ریسکهای همخانواده:
- Secret یا توکنی که مدل از زمینهٔ چت یا فایل env نمونه «کامل» کرده و Commit میشود.
- وابستگی ناامن یا نسخهٔ منسوخ که در پیشنهاد import آمده.
- کاهش ناخواستهٔ کنترل دسترسی در «سادهسازی» کد.
- Prompt injection غیرمستقیم اگر Agent به محتوای خارجی (Issue، ایمیل، صفحه) اعتماد کند و دستور مهاجم را اجرا کند—در کنار LLM01 و Excess Agency.
حتی وقتی از Copilot code review استفاده میکنید، GitHub میگوید همهٔ مسائل را پیدا نمیکند و باید بازخورد را اعتبارسنجی و با Review انسانی تکمیل کنید. ابزار امنیتی کمکی است نه گواهی بینقصی.
۳) رگرسیون
Agent معمولاً روی فایلهای مرتبط با پرامپت تمرکز میکند و اثر جانبی روی مسیرهای کمتردیدهشده را کمبرآورد میکند. رگرسیون یعنی رفتار درست قبلی میشکند:
- تغییر قرارداد JSON که کلاینت موبایل قدیمی را میشکند.
- عوض کردن ترتیب middleware و از بین رفتن لاگ یا rate limit.
- بهینهسازی query که در دادهٔ کوچک سریع و در Production قفل میسازد.
- حذف «کد مرده»ای که در واقع feature flag خاموش بوده.
Review و تست رگرسیون—بهویژه integration روی قراردادهای منتشرشده—جلوی این کلاس را میگیرد. اگر فقط به واحدهای جدید تولیدشده توسط همان Agent اعتماد کنید، کوررنگی دو طرفه دارید: نویسنده و داور یکی است.
۴) منطق کسبوکار و انطباق
مدل نمیداند مگر شما بگویید: سقف برداشت روزانه، قوانین مالیات، نگهداری داده، یا تفاوت رفتار کاربر VIP. انتشار بدون Review یعنی تصمیم محصول را به تخمین آماری مدل سپردهاید. برای حوزههای دارای الزام قانونی، این نه فقط باگ فنی که ریسک سازمانی است—دقیقاً جایی که NIST روی حاکمیت و نقش AI Actorها تأکید دارد.
جدول: نشانه → پیامد → کنترل
| نشانهٔ خطر | پیامد احتمالی | کنترل حداقلی |
|---|---|---|
| PR هزارخطی یکنشسته | Review سطحی، باگ پنهان | شکستن به PRهای کوچک |
| بدون تست برای مسیر جدید | رگرسیون دیرهنگام | تست شکستپذیر قبل از Merge |
| اجرای مستقیم خروجی در shell/DB | RCE / فساد داده | ممنوعیت؛ parameterization و Approval |
| خلاصهٔ Agent بهجای Diff | از دست رفتن خطوط حساس | الزام Review روی Diff |
| Deploy از چت | Incident بدون ردپا | فقط از pipeline با gate |
| Approve فقط توسط AI | حفرهٔ امنیتی باقیمانده | Reviewer انسان برای مسیرهای حساس |
سیاست عملی «بدون Review نمیرود»
- هر تغییر AI-assisted مثل کد شخص ثالث است: مالک انسان دارد.
- قالب PR: خلاصه، ریسک، تست، بخشهای تولیدشده با AI.
- Branch protection: Review اجباری + CI سبز؛ استثنا فقط با ثبت دلیل.
- مسیرهای قرمز (auth، پرداخت، حذف داده، مهاجرت): Review دوم یا تخصص امنیت.
- ممنوعیت Auto-merge برای PRهایی که نویسنده Bot/Agent است مگر سیاست جدا و محدود.
- Secret scanning و SCA روشن بماند.
این سیاست با کاهش Excessive Agency همراستاست: خودمختاری مدل را در نقطهٔ Merge قطع میکنید.
چکلیست Review پانزدهدقیقهای برای خروجی AI
- آیا AC و رفتار خطا پوشش داده شده؟
- آیا Diff فقط همان شعاع اعلامشده را لمس میکند؟
- آیا ورودیها اعتبارسنجی شدهاند (مخصوصاً اگر از مدل به SQL/shell/HTML میروند)؟
- آیا تستی هست که با شکستن عمدی رفتار قرمز شود؟
- آیا Secret، کلید، یا دادهٔ واقعی در کد/لاگ نیست؟
- آیا قرارداد API/رویداد برای مصرفکنندگان قدیمی سازگار است؟
- آیا میتوانم بدون مدل برای همکار توضیحش بدهم؟ اگر نه، Merge نکن.
ضدالگوها
- «مدل از من بهتر کد مینویسد پس Review اتلاف است.»
- خاموش کردن typecheck چون Agent قول اصلاح داده.
- Ship در جمعه عصر با پرامپت «هرچه لازم است را درست کن».
- اتکا به یک ابزار Review خودکار بهعنوان تنها Approve.
- Paste کردن خروجی مدل مستقیم در پنل Production DB.
وقتی سرعت مهم است چه کنیم؟
Review را حذف نکنید؛ دامنه را کوچک کنید. PR بیستخطی با تست مشخص سریعتر از PR دوهزارخطی «تمامشده» Review میشود. از Plan Mode و شاخهٔ جدا استفاده کنید تا قبل از کد، رویکرد تأیید شود. برای کارهای فوقاضطراری، Pair Review همزمان با نویسنده—نه حذف Review.
سوالات متداول
اگر CI کامل داریم باز هم Review لازم است؟
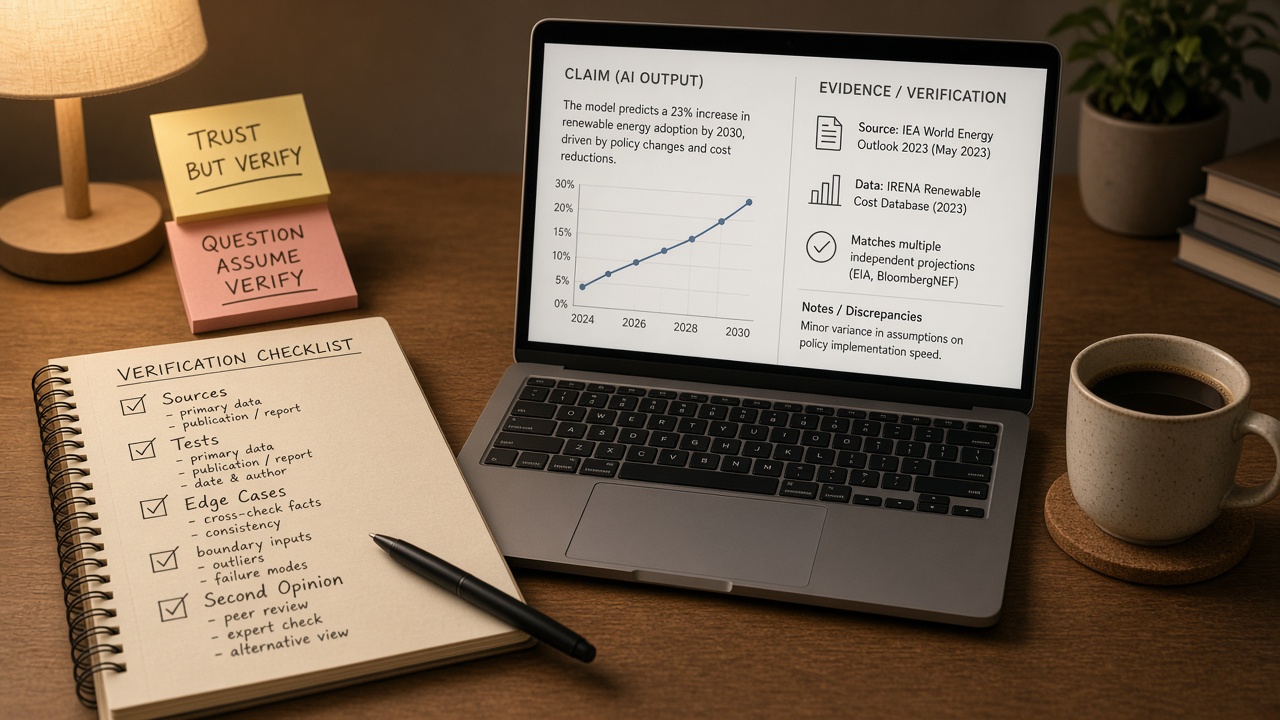
بله. CI آنچه را که نوشتهاید اندازه میگیرد؛ منطق کسبوکار نانوشته و اثر جانبی را تضمین نمیکند. CI لازم است اما کافی نیست.
آیا Review فقط برای کد است؟
خیر. پرامپتهای سیستم، Rules، و تنظیمات Agent هم «کد سیاست»اند؛ تغییرشان را هم Review کنید تا Excessive Agency بیصدا رشد نکند.
مدل گاهی مشکل امنیتی را خودش میگوید؛ کافی نیست؟
مفید است بهعنوان سرنخ. تصمیم و تأیید نهایی با انسان و ابزارهای تخصصی (SCA، SAST، تست نفوذ محدود) است.
خلاصه
بدون Review، باگ منطقی، حفرهٔ امنیتی، رگرسیون و خطای کسبوکار با بستهبندی متن مطمئن وارد Production میشوند. OWASP خروجی مدل را نامطمئن میداند؛ NIST نظارت و اندازهگیری میخواهد؛ فروشندگان جدی Review انسانی را مکمل میدانند. سرعت را با PR کوچک و دروازهٔ روشن نگه دارید—نه با حذف ناظر.
سناریوهای واقعی شکست بدون Review
سناریو A: پرداخت با retry دوبل
Agent برای کاهش timeout، retry اضافه میکند بدون کلید idempotency. Unit سبز است چون mock همیشه یک بار صدا میخورد. در Production، دو شارژ ثبت میشود. Review انسانی روی مسیر پول معمولاً سؤال idempotency را میپرسد؛ خلاصهٔ Agent آن را جا میاندازد.
سناریو B: «پاکسازی» کد مجوز
مدل شرط پیچیدهای را ساده میکند و یک نقش را حذف میکند. UI هنوز درست به نظر میرسد چون کاربر تست admin است. کاربر عادی هفتهٔ بعد به دادهٔ دیگران میرسد. بدون Review دسترسی و تست نقش، CI معمولی کافی نیست.
سناریو C: Deploy اسکریپت از چت
خروجی مدل یک فرمان migrate با drop ستون پیشنهاد میدهد. اگر مستقیم در ترمینال Production اجرا شود، Improper Output Handling کلاسیک است. حتی اگر «در staging کار کرد»، بدون برنامهٔ برگشت و Review عملیات خطرناک است.
لایههای دفاع بهجای یک قهرمان
Review انسان یک لایه است کنار: تست خودکار، SAST/SCA، secret scanning، Branch protection، محیطهای جدا، و نظارت پس از انتشار. حذف Review با این استدلال که «ابزار امنیتی داریم» مثل حذف ترمز چون کیسهٔ هوا دارید است. NIST هم کنترل را چندلایه و چرخهای میبیند نه تکنقطهای.
بعد از Merge هم MEASURE کنید: نرخ خطای مسیرهای AI-touched، زمان تشخیص، و تعداد Rollback. اگر بدتر شد، خودمختاری را کم کنید.
فرهنگ شرم صفر برای «نفهمیدم»
بزرگترین دشمن Review، شرم از اعتراف به نفهمیدن Diff تولیدشده است. سیاست صریح بگذارید: Merge بدون فهم ممنوع است و درخواست توضیح از نویسنده—انسان یا با کمک Ask—نشانهٔ حرفهایگری است. نویسنده موظف است Diff را طوری کوچک و مستند کند که Review ممکن باشد.
در PRهای Agent-heavy، نویسنده باید بخشهای تولیدشده را علامت بزند تا Reviewer بداند کجا عمیقتر ببیند.
حداقل سند سیاست یکصفحهای
- تعریف خروجی AI که شامل کد، کانفیگ، اسکریپت، و Rules میشود.
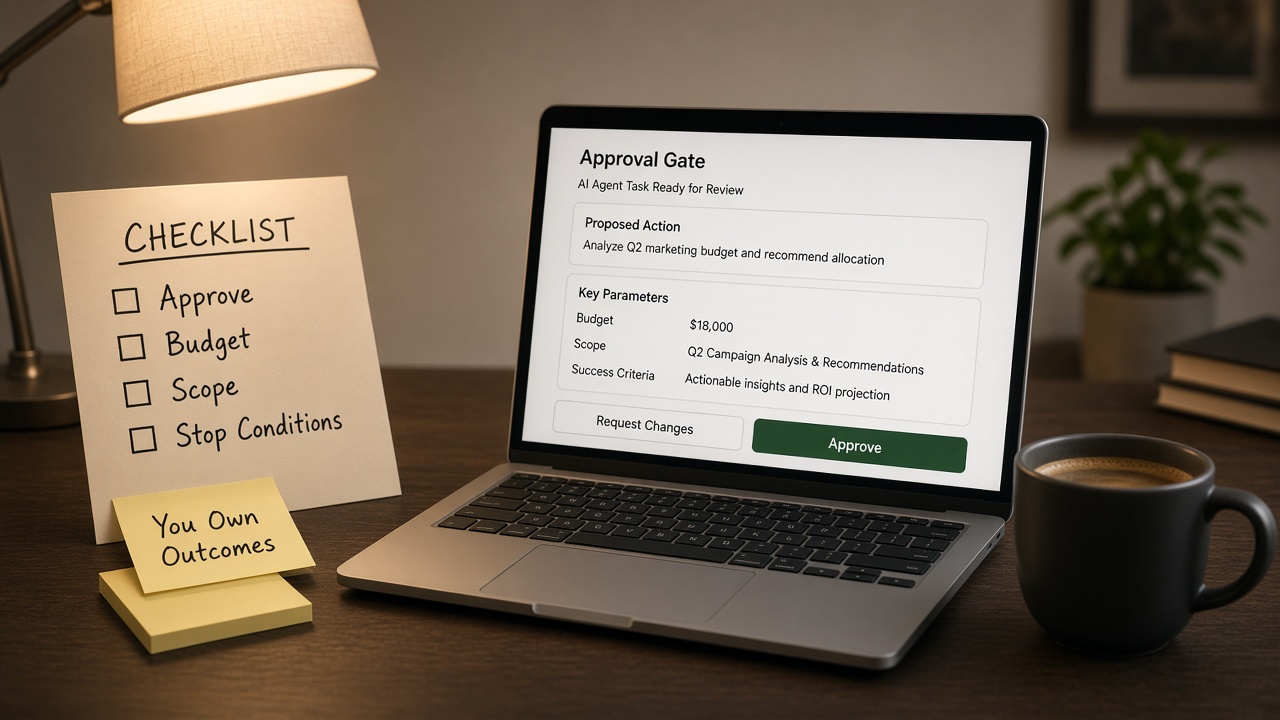
- الزام Review انسانی قبل از Merge به شاخهٔ محافظتشده.
- فهرست مسیرهای قرمز با Review دوم.
- ممنوعیت اجرای مستقیم خروجی مدل روی Production.
- الزام CI سبز و اسکن اسرار.
- مالک حادثه و کانال اعلام.
این صفحه را در onboarding بگذارید و هر فصل یک بار با متریکها بازبینی کنید.
چکلیست پیش از فشردن Deploy
- Diff توسط انسان خوانده شده و مالک دارد.
- حداقل یک Reviewer غیرنویسنده Approve کرده (برای مسیر قرمز: دوم).
- CI شامل تست مسیر جدید سبز است.
- Secret scan و وابستگیها بدون یافتهٔ باز اجباریاند.
- برنامهٔ rollback یا flag خاموشسازی مشخص است.
- خروجی مدل عیناً در shell/DB Production paste نشده است.
- تغییر Rules/Agent با همان دقت کد Review شده است.
اگر یکی از اینها نیست، Deploy را عقب بیندازید—نه اینکه «بعداً درست میکنیم». هزینهٔ تأخیر معمولاً کمتر از Incident عمومی است.
تفاوت Review کد و Review تصمیم
گاهی کد از نظر سبکی تمیز است اما تصمیم غلط است: افزودن endpoint عمومی بدون rate limit، یا لاگ کردن بدنهٔ درخواست شامل PII. Review تصمیم میپرسد «اصلاً باید این را Ship کنیم؟» مدل در تولید کد قویتر از رد کردن ایدهٔ خطرناک است؛ انسان باید نقش ردکننده را نگه دارد.
در جلسات برنامهریزی، صریحاً از Agent نخواهید «هرچه لازم است را پیاده کن»؛ دامنه را محدود کنید تا Review تصمیم ممکن بماند.
پیامد حقوقی و اعتباری—بدون اغراق
این مقاله مشاوره حقوقی نیست؛ اما از نظر مهندسی روشن است که نشت داده یا شارژ اشتباه ناشی از کد بدون Review میتواند تعهد قراردادی و اعتماد کاربر را بشکند. چارچوبهای داوطلبانه مثل NIST به سازمانها کمک میکنند ریسک را نقشهبرداری کنند قبل از اینکه حادثه آن را نقشهبرداری کند. حداقل مهندسی: مسیرهای دادهٔ حساس را در فهرست قرمز سیاست بگذارید.
جمعبندی اجرایی برای Tech Lead
این هفته: Branch protection را برای required review روشن کنید اگر نیست. قالب PR را با فیلد «AI-assisted؟» بهروز کنید. یک ضدالگو را در کانال تیم با Diff واقعی (بدون شرم) بررسی کنید. ماه بعد: متریک نقص پس از Merge مسیرهای AI-touched را با مسیرهای دستی مقایسه کنید و سیاست را تنظیم کنید—نه بر اساس ترس، بر اساس داده.
منابع و مراجع
- OWASP GenAI LLM Top 10 2026 — LLM10 Improper Output Handling — https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
- OWASP LLM03 Excessive Agency / LLM07 Misinformation (same release) — https://github.com/GenAI-Security-Project/GenAI-LLM-Top10/tree/main/2026
- NIST AI Risk Management Framework — https://www.nist.gov/itl/ai-risk-management-framework
- NIST AI 600-1 Generative AI Profile — https://doi.org/10.6028/NIST.AI.600-1
- GitHub Copilot code review — validating reviews — https://docs.github.com/en/copilot/concepts/agents/code-review
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.