چه وقت RAG لازم است؟
7 دقیقه مطالعه
چه زمانی بهجای RAG از SQL یا جستوجوی متنی استفاده کنیم؟ جدول تصمیم بر اساس نوع پرسش و هزینهٔ پیچیدگی با مثال.
«RAG بسازیم» جذاب است، اما همیشه پاسخ درست مسئله نیست. گاهی کاربر فقط میخواهد سفارشش را با شمارهٔ سفارش پیدا کند؛ گاهی چند صفحه دانش دارید که در یک prompt جا میشود؛ گاهی جستوجوی متنی خوب از قبل مشکل را حل میکند. این مقاله معیار تصمیم میدهد: چه پرسشهایی با فیلتر SQL، چههایی با جستوجوی متنی و چههایی واقعاً به RAG نیاز دارند، و هزینهٔ پیچیدگی هر کدام چیست.
مرجع: مستندات جستوجوی تماممتن PostgreSQL (نسخهٔ ۱۸)، مقالهٔ Contextual Retrieval از Anthropic، صفحهٔ RAG در Google Cloud و راهنمای SageMaker، همه در ۱۹ اکتبر ۲۰۲۶ خوانده شد. تصمیمهای «اگر… آنگاه» در جدول توصیهٔ نویسندهاند و بر دادهها یا آزمون ما تکیه ندارند؛ آنها را با مجموعه پرسش واقعی خودتان بسنجید. ما ابزار یا پایگاه برداری خاصی را معرفی نمیکنیم. برای انتخاب فناوری در کل انتخاب تکنولوژی را ببینید.
اول نوع پرسش را بشناسید
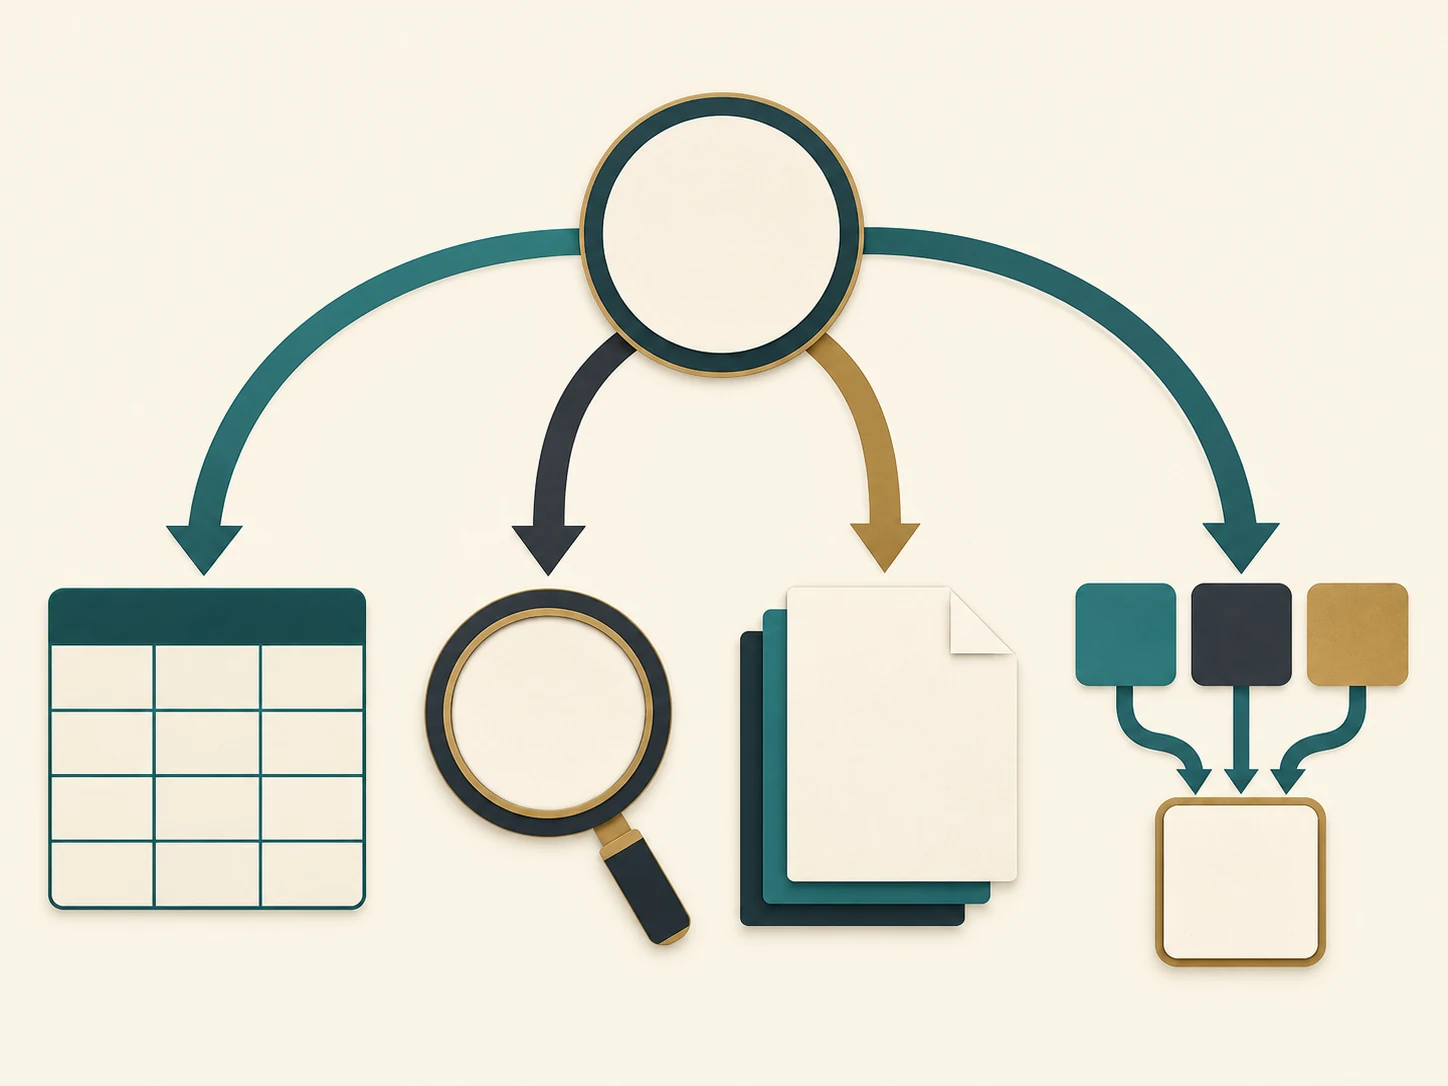
چهار گروه پرسش در محصولها دیده میشود:
- پرسش ساختیافته: «سفارشهای باز مشتری ۱۲۳» یا «فاکتورهای بالای یک مبلغ در ماه گذشته». جواب در جدول و ستون است.
- جستوجوی واژهای: «کد خطا TS-999» یا «نام محصول X». کاربر کلیدواژهٔ دقیق دارد.
- جستوجوی متنی در اسناد: «روش بازگشت وجه». سند مرتبط را میخواهد و خودش میخواند.
- پرسش مفهومی با ترکیب چند سند: «اگر کالا باز شده و مهلت تمام شده، چه کنم؟». پاسخ باید از چند بند ساخته شود.
فیلتر SQL و پرسش ساختیافته
اگر پاسخ در ستونهای داده هست، SQL دقیق، قابلحسابرسی و ارزان است؛ در LLM «حدس محتمل» جای «حساب دقیق» نمینشیند. LLM میتواند لایه زبان طبیعی روی SQL باشد (مثلاً تبدیل پرسش به فیلتر) اما اجرا و ارقام را پایگاه داده میدهد. این الگو بهجای RAG است، نه شکلی از آن. AWS هم میگوید منبع RAG میتواند پایگاه داده یا API باشد، اما مسئله این است که برای ارقام باید همان پرسوجوی دقیق اجرا شود و فقط نتیجه به مدل داده شود (توصیهٔ نویسنده).
جستوجوی متنی (واژهای)
مستندات PostgreSQL توضیح میدهد چرا ~، LIKE و ILIKE برای جستوجوی متن کافی نیستند: پشتیبانی زبانی ندارند (مثلاً satisfies و satisfy را یکی نمیدانند)، نتیجه را رتبهبندی نمیکنند و بدون ایندکس برای هر جستوجو همهٔ سندها را میخوانند. جستوجوی تماممتن اسناد را به توکن و lexeme تبدیل، stop wordها را حذف و ایندکس را ذخیره میکند و میتواند نتایج را بر پایهٔ شباهت به پرسش مرتب کند. سادهترین شباهت، فراوانی واژههای پرسش در سند است.
این روش برای کد خطا و نام دقیق عالی است. Anthropic هم نشان میدهد جستوجوی معنایی ممکن است «Error code TS-999» را از دست بدهد و BM25، که تطبیق واژگانی است، آن را پیدا کند. نکتهٔ مهم برای ما: این منابع تأیید نمیکنند جستوجوی تماممتن آماده برای فارسی (ریشهیابی، نیمفاصله، ی و ک عربی و فارسی) چگونه رفتار میکند؛ پیش از تصمیم، با نمونهٔ واقعی فارسی خودتان آزمون کنید.
قرار دادن همهچیز در prompt
Anthropic میگوید اگر پایگاه دانش کمتر از ۲۰۰٬۰۰۰ توکن (حدود ۵۰۰ صفحه) است، میتوان همهٔ آن را در prompt گذاشت و به RAG نیاز نیست. Google Cloud هم پنجرهٔ زمینهٔ بلند را راه خوب دادن منبع به مدل میداند و RAG را برای حجم بیشتر یا برای کاهش توکن، زمان و هزینه میشناسد. حد ۲۰۰ هزار توکن مربوط به ۲۰۲۴ است؛ ظرفیت و قیمت فعلی را از مستندات روز ارائهدهنده بخوانید و دقت مدل را روی زمینهٔ بلند جداگانه بسنجید، چون Anthropic در مستندات پنجرهٔ زمینه هشدار میدهد که زمینه بزرگتر لزوماً دقیقتر نیست (افت دقت و یادآوری).
چه زمانی RAG لازم میشود؟
- دانش از حد prompt بزرگتر است یا هزینه و تأخیر ارسال همهچیز در هر درخواست زیاد است.
- پرسشها مفهومیاند و کاربر با کلیدواژهٔ دقیق پرسش نمیکند.
- پاسخ باید از چند بخش ساخته و با منبع ارجاع شود.
- دانش مدام تغییر میکند و میخواهید بدون آموزش دوباره نمایه را بهروز کنید.
RAG یعنی هر بار قطعهبندی، embedding، نمایه، بازیابی، prompt و ارزیابی؛ هزینهٔ مهندسی و نگهداری آن واقعی است و هر مرحله میتواند خطا کند.
جدول تصمیم
| پرسش کاربر | راه سادهتر | چه زمانی RAG؟ |
|---|---|---|
| سفارشهای باز، مبلغ، تاریخ | SQL / API | تقریباً هرگز برای ارقام |
| کد خطا، نام محصول، شناسه | جستوجوی واژهای (BM25 یا تماممتن) | فقط بهصورت ترکیبی |
| یافتن سند مرتبط | جستوجوی متنی + فیلتر | اگر کاربر ناچار به خواندن زیاد است |
| دانش کوچک و ثابت | کل متن در prompt | وقتی حجم یا هزینه رشد کرد |
| پرسش مفهومی روی اسناد زیاد | — | بله، با ارزیابی |
| ترکیب ارقام و متن | SQL برای رقم + RAG برای توضیح | در بخش متن |
ترکیب: بهترین نقطه شروع
Anthropic ترکیب جستوجوی معنایی و BM25 با rank fusion را پیشنهاد میدهد تا هم شباهت معنایی و هم تطبیق دقیق را داشته باشید. در عمل (نویسنده): اگر جستوجوی متنی فعلی شما بخش بزرگی از نیاز را پوشش میدهد، با یک مجموعه پرسش واقعی بسنجید که کدام پرسشها شکست میخورند و فقط برای همانها لایهٔ معنایی اضافه کنید. این از ساخت یک سیستم کامل RAG که شاید لازم نبود جلوگیری میکند.
هزینهٔ پیچیدگی
- مهندسی: پایپلاین ingest، بهروزرسانی، ارزیابی و پایش.
- داده: مجوز دسترسی، نسخهبندی، تازگی.
- اجرا: embedding، پایگاه برداری، توکن و تأخیر (قیمت را از صفحهٔ رسمی تاریخدار بخوانید).
- ریسک: پاسخ غلط با ظاهر مستند.
- تجربهٔ کاربر: گاهی لیست نتایج روشنتر از پاسخ تولیدی است (UX).
مثال ساختگی: فروشگاه آنلاین
- «سفارش من کجاست؟» به SQL/API وضعیت سفارش و پاسخ قالبی میرود؛ LLM لازم نیست.
- «کد خطای پرداخت ۴۰۱ یعنی چه؟» با جستوجوی واژهای در راهنما حل میشود.
- «اگر کالا را باز کردم و ۱۰ روز گذشته، چه کنم؟» ترکیبی از سیاست بازگشت و شرایط کالا لازم دارد؛ اینجا RAG ارزش پیدا میکند، با ارجاع به سند.
- راهنمای ۳۰ صفحهای ثابت ابتدا میتواند کامل در prompt برود و تنها با رشد حجم به RAG مهاجرت کند.
اشتباهات رایج
- استفاده از RAG برای رقم و محاسبه بهجای پرسوجوی دقیق.
- جستوجوی صرفاً معنایی برای کد و شناسه.
- ساخت RAG بدون آزمودن جستوجوی ساده روی پرسشهای واقعی.
- فرض اینکه جستوجوی تماممتن آماده فارسی را درست پشتیبانی میکند.
- نداشتن معیار ارزیابی برای مقایسهٔ راهها.
چکلیست تصمیم
- نوع پرسشهای واقعی کاربران دستهبندی شده است.
- برای پرسش ساختیافته SQL یا API بهکار میرود.
- جستوجوی متنی ساده روی پرسشهای واقعی (از جمله فارسی) آزموده شده است.
- حجم دانش با پنجرهٔ زمینه و هزینه مقایسه شده است.
- اگر RAG لازم است، ترکیب واژهای و معنایی در نظر گرفته شده است.
- مجموعهسؤال برای مقایسهٔ راهها وجود دارد.
- هزینهٔ نگهداری و مالک سیستم مشخص است.
برای شروع هر پروژهٔ هوش مصنوعی هم برنامهریزی پروژه نرمافزاری مفید است.
منابع و مراجع
- Full Text Search: Introduction (PostgreSQL 18 documentation) — PostgreSQL Global Development Group.
- Introducing Contextual Retrieval — Anthropic Engineering، 2024-09-19.
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud.
- Retrieval Augmented Generation — Amazon SageMaker AI Developer Guide.
- Context windows — Anthropic (Claude Platform Docs)، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.