LLM چیست؟ مدل زبانی بزرگ با مثال محصول
7 دقیقه مطالعه
LLM چیست؟ توکن، پیشبینی، پنجرهٔ زمینه، hallucination و اهرمهای prompt، fine-tuning و distillation با مثال تیکت پشتیبانی.
برای تیم محصول، «LLM» اغلب با یک دموی خیرهکننده شروع میشود و با یک سؤال بد ادامه پیدا میکند: «پس چرا گاهی غلط میگوید؟». پاسخ در سازوکار اصلی مدل است. این مقاله LLM را با زبان ساده و با مثال یک قابلیت محصول (دستهبندی و خلاصهسازی تیکت پشتیبانی) توضیح میدهد، جزئیات فنی را جدا نگه میدارد و نشان میدهد در طراحی محصول چه چیزی از آن نتیجه میشود.
مرجع: آموزش «Machine Learning Crash Course» گوگل (صفحههای مدلهای زبانی بزرگ، ترنسفورمر و تنظیم مدل؛ آخرین بهروزرسانی ۲۰۲۶-۰۱-۰۹ و ۲۰۲۶-۰۱-۰۲) و مستندات پنجرهٔ زمینه در Anthropic؛ همهٔ آنها در ۱۹ اکتبر ۲۰۲۶ خوانده شد. ما نام مدل یا قیمت خاصی را مطرح نمیکنیم؛ توانایی مدلها زود تغییر میکند و عددهای ظرفیت را باید از مستندات همان روز ارائهدهنده گرفت. اصطلاحهای انگلیسی (token، prompt، context) در متن میآیند چون در مستندات هم همیناند.
به زبان ساده
مدل زبانی، طبق تعریف گوگل، احتمال یک «توکن» یا دنبالهای از توکنها را در یک دنبالهٔ بلندتر برآورد میکند. جملهای را ببینید که ناقص است: «وقتی صدای باران روی بام را میشنوم، در آشپزخانه ... ». مدل به هر ادامهٔ ممکن احتمالی میدهد و برنامه میتواند محتملترین را بردارد یا از میان گزینههای بالاتر از یک آستانه تصادفی انتخاب کند. LLM همین کار را در مقیاس بسیار بزرگ میکند؛ گوگل آن را «اساساً سازوکار تکمیل خودکار» توصیف میکند که میتواند هزاران توکن را پیشبینی کند. سؤال شما برای مدل مثل جملهٔ «دادهشده» است و پاسخ، ادامهای که باید حدس زده شود.
پیامد مهم برای محصول: مدل «حقیقت را پیدا نمیکند»، «ادامهٔ محتمل» میسازد. گوگل صریحاً میگوید LLMها hallucinate میکنند، یعنی پیشبینیهایشان اغلب اشتباه دارد. ما درصد خطا را نمیدانیم و برای هر قابلیت باید آن را با داده خودتان اندازه بگیرید.
توکن و پنجرهٔ زمینه
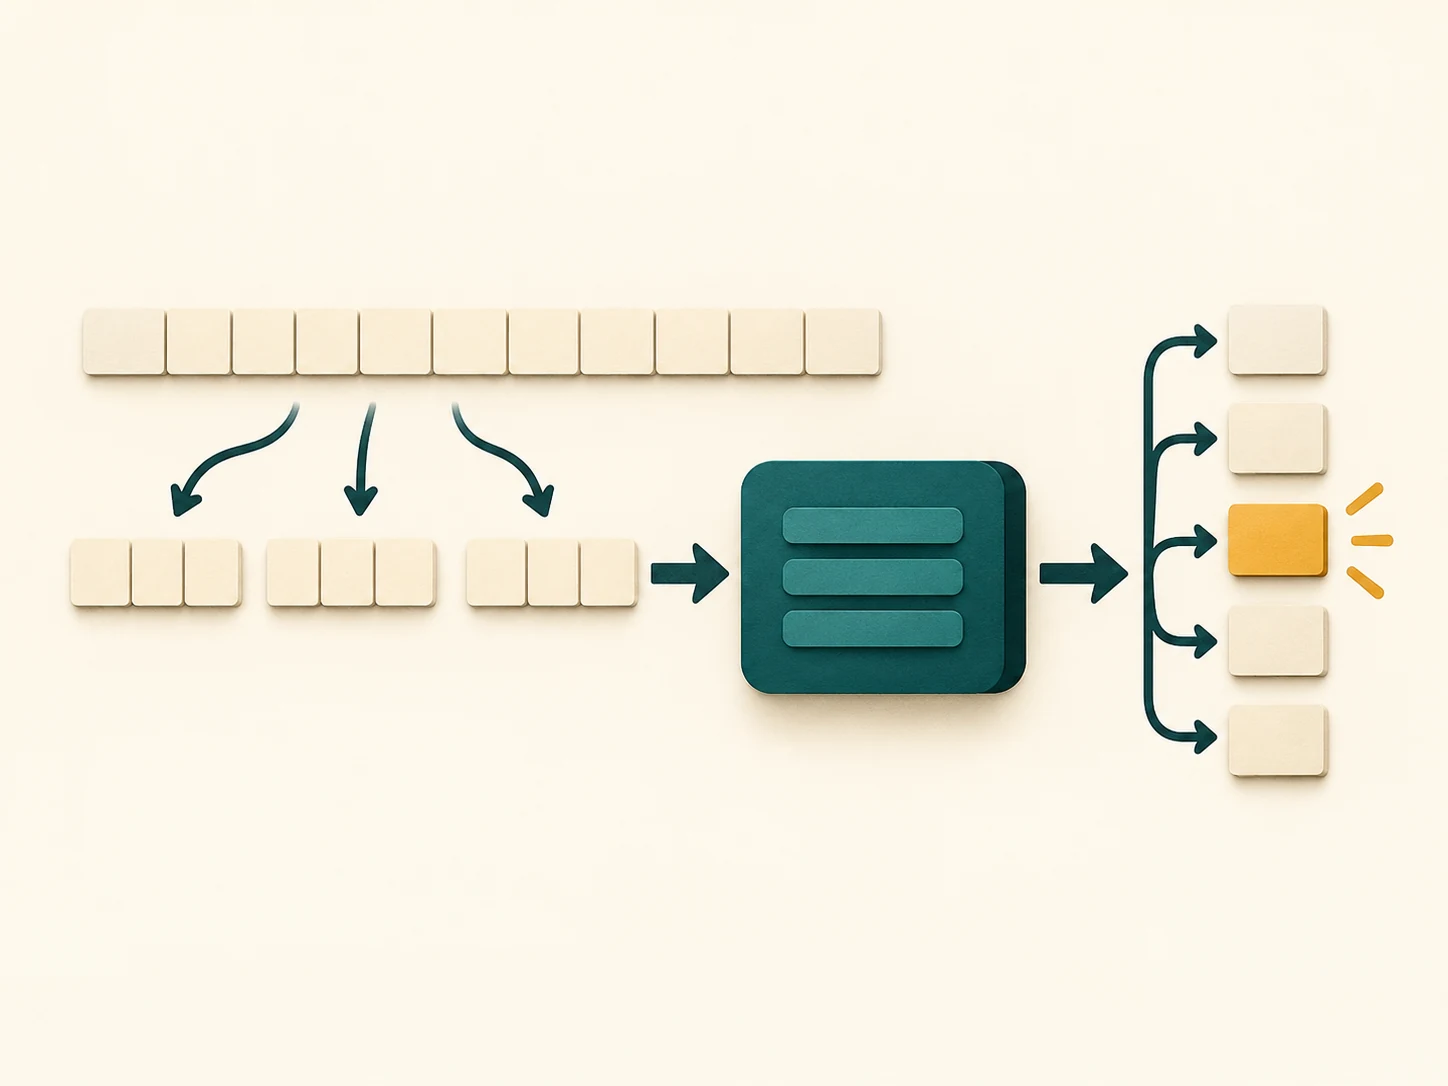
توکن واحد کوچک مدل است: ممکن است کلمه، زیرکلمه (مثلاً «un + watch + ed») یا نویسه باشد. توکنبندی به زبان وابسته است و تعداد نویسه به ازای هر توکن بین زبانها فرق دارد؛ گوگل برای انگلیسی حدود ۴ نویسه یا سهچهارم کلمه به ازای هر توکن میگوید. ما عددی رسمی برای فارسی در این منابع نداریم، پس هزینه و محدودیت فارسی را با آزمون روی متن واقعی خودتان بسنجید، نه با تبدیل ریاضی.
«پنجرهٔ زمینه» در مستندات Anthropic یعنی همهٔ متنی که مدل هنگام تولید پاسخ میتواند ببیند، شامل خود پاسخ؛ نوعی «حافظهٔ کاری» که با دادهٔ آموزش فرق دارد. همان مستندات هشدار میدهد پنجرهٔ بزرگتر خودبهخود بهتر نیست: با رشد تعداد توکنها دقت و یادآوری افت میکند (context rot). نتیجه: بهجای ریختن همهٔ سندها در prompt، محتوای مرتبط را انتخاب کنید.
در عمل چطور ساخته میشود (جزئیات فنی)
ماشینلرنینگ کراشکورس گوگل این خط را میکشد: مدلهای قدیمیتر مثل N-gram فقط چند کلمهٔ قبل را میبینند و RNN توکنها را یکییکی پردازش میکند؛ LLMهای مبتنی بر ترنسفورمر کل زمینه را با self-attention میسنجند. برای هر توکن میپرسد «هر توکن دیگر ورودی چقدر در معنای این توکن اثر دارد؟». مثال گوگل: در «The animal didn't cross the street because it was too tired» ضمیر it به animal اشاره دارد و اگر آخر جمله «wide» شود، به street. هر لایه چند «سر» توجه دارد و لایهها روی هم چیده میشوند.
آموزش: فاز اول معمولاً یادگیری بدون برچسب با حدس توکنهای پنهانشده در حجم عظیم متن است، و گام اختیاری «instruction tuning» پیروی از دستور را بهتر میکند. گوگل مینویسد معمولاً هرگز یک LLM را از صفر آموزش نمیدهید؛ مصرفکنندهٔ مدل آمادهاید.
اهرمهای شما بهعنوان تیم محصول
| اهرم | چه تغییری میدهد؟ | نکتهٔ منبع |
|---|---|---|
| Prompt engineering | رفتار مدل با دستور و مثال (zero/one/few-shot) | پارامترهای مدل تغییر نمیکند |
| Fine-tuning | مدل را برای کار شما بهتر میکند | تعداد پارامترها همان میماند؛ نیاز به داده و هزینه |
| Distillation | مدل کوچکتر و سریعتر | معمولاً کمی ضعیفتر از مدل بزرگ |
| Offline inference | پیشمحاسبه و کش نتایج | مناسب کارهای تکرارشونده و بدون نیاز به پاسخ زنده |
| انتخاب محتوای زمینه | کیفیت ورودی مدل | context rot را در نظر بگیرید |
مثال محصول: تیکت پشتیبانی
فرض کنید ۲۰۰ تیکت در روز دارید و میخواهید اولویت و دستهٔ پیشنهادی بدهید. مثال ساختگی prompt برای few-shot: «تیکت ۱: "پرداخت انجام شد ولی سفارش ثبت نشد" → دسته: پرداخت، اولویت: بالا. تیکت ۲: "رنگ لوگو را عوض کنید" → دسته: درخواست طراحی، اولویت: کم. تیکت جدید: ...». نکات طراحی:
- مدل فقط پیشنهاد میدهد؛ انسان تأیید میکند. دلیل: hallucination و ناآگاهی ما از نرخ خطا.
- نمونههای واقعی و متنوع (از جمله موارد مبهم) را در مجموعه ارزیابی نگه دارید و دقت را اندازه بگیرید.
- داده شخصی مشتری را بدون تصمیم دربارهٔ حریم خصوصی و قرارداد ارائهدهنده به مدل نفرستید؛ این مقاله دربارهٔ مقررات ایران ادعایی ندارد.
- برای دستهبندی شبانهٔ تیکتهای قدیمی، offline inference و کش ممکن است از پاسخ زنده ارزانتر و کمریسکتر باشد.
محدودیتها و ریسکها
- اشتباه (hallucination): منبع رسمی صریح است؛ خروجی را راستیآزمایی کنید.
- هزینه محاسباتی: LLMها منابع و برق زیادی مصرف میکنند؛ قیمت واقعی را از صفحهٔ رسمی تاریخدار ارائهدهنده بخوانید.
- سوگیری: مدل سوگیری دادهٔ آموزش (و دادهٔ distillation) را به ارث میبرد.
- زمینه محدود: همهچیز در پنجره جا نمیشود و بزرگتر لزوماً دقیقتر نیست.
- تغییر مدل: نسخهٔ مدل عوض میشود؛ ارزیابی را تکرارپذیر نگه دارید.
چه زمانی LLM مناسب است؟
- خروجی «پیشنهاد» باشد و خطای گاهی قابلتحمل یا قابلبازبینی باشد؟ اگر بله، مناسب است.
- ورودی متن آزاد و متنوع است و قانونهای ساده جواب نمیدهند؟ مناسبتر.
- باید جواب دقیق و قابلحسابرسی بدهد (محاسبه مالی، قانون)؟ با احتیاط و با منبع و بازبینی.
- مسئله با فیلتر، جستوجو یا قانون ساده حل میشود؟ همان را بگیرید.
اشتباهات رایج
- فرض اینکه LLM پایگاه دانش است و حقیقت را «میداند».
- ریختن همهٔ اسناد در prompt بهجای انتخاب محتوای مرتبط.
- نداشتن مجموعهٔ ارزیابی و ادعای «دقت خوب» از روی چند دمو.
- خودکار کردن تصمیم پرریسک بدون بازبینی انسان.
- قفلشدن روی یک مدل بدون راه خروج و بدون ثبت نسخه.
چکلیست پیش از ساخت
- کار مدل (پیشنهاد/خلاصه/دستهبندی) و هزینهٔ خطا تعریف شده است.
- مجموعهای از نمونههای واقعی برای ارزیابی داریم.
- مسیر بازبینی انسانی و راه برگشت وجود دارد.
- سیاست داده شخصی و قرارداد ارائهدهنده روشن است.
- هزینه و تأخیر با آزمون روی داده خودمان سنجیده شده، نه از روی عددهای عمومی.
- ورودی پنجره انتخابشده است نه انباشته.
- نسخهٔ مدل و تاریخ مستندات ثبت میشود.
برای چارچوب برنامهریزی پروژه برنامهریزی پروژه نرمافزاری، برای معیار آمادگی تولید نرمافزار آمادهٔ تولید و برای انتخاب فناوری انتخاب تکنولوژی را ببینید.
منابع و مراجع
- Introduction to Large Language Models — Google for Developers (Machine Learning Crash Course)، 2026-01-09.
- Large Language Models (Transformers) — Google for Developers (Machine Learning Crash Course)، 2026-01-02.
- LLMs: Fine-tuning, distillation, and prompt engineering — Google for Developers (Machine Learning Crash Course).
- Context windows — Anthropic (Claude Platform Docs)، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.