انتخاب مدل هوش مصنوعی
7 دقیقه مطالعه
چطور مدل هوش مصنوعی مناسب محصول را انتخاب کنیم؟ جدول معیار، آزمون روی داده خودتان، مسیریابی، ریسک بازنشستگی و چکلیست.
«کدام مدل را انتخاب کنیم؟» سؤالی است که هر چند ماه جواب متفاوتی دارد. بنابراین جواب پایدار یک نام نیست؛ یک روش است: معیارهای روشن، آزمون روی داده خودتان و ثبت تاریخ تصمیم. این مقاله جدول معیار و روش آزمون میدهد و عرضهٔ روز و قیمت را فقط از منبع رسمی تاریخدار نقل میکند.
مرجع و تاریخ: صفحهٔ «Models overview» و «Pricing» مستندات Anthropic و راهنماهای eval در OpenAI و Anthropic، خواندهشده در ۱۹ اکتبر ۲۰۲۶؛ صفحهٔ قیمت OpenAI هم معرفی میشود بدون نقل عدد. ما در این مقاله «بهترین مدل» معرفی نمیکنیم و رتبهبندی بنچمارک بیمنبع نمیآوریم؛ ارائهدهندگان و مدلهای دیگر (از جمله متنباز و ایرانی) را نسنجیدهایم و دسترسی/پرداخت از ایران را بررسی نکردهایم. نام مدلهایی که میآید فقط «نمونهٔ خواندن جدول در این تاریخ» است. برای انتخاب فناوری انتخاب تکنولوژی را ببینید.
معیارها
| معیار | پرسش | از کجا بسنجیم؟ |
|---|---|---|
| کیفیت روی کار شما | روی دیتاست ارزیابی ما چند درصد گذر میکند؟ | eval خودمان |
| تأخیر | زمان تا اولین توکن و کل پاسخ در بار واقعی؟ | آزمون بار + جدول رسمی |
| هزینه | هزینهٔ هر وظیفه، نه هر توکن؟ | صفحهٔ قیمت رسمی + توکن واقعی |
| پنجرهٔ زمینه و سقف خروجی | ورودی و خروجی ما جا میشود؟ | جدول مدلها / Models API |
| قابلیتها | ابزار، خروجی ساختاریافته، تصویر، تفکر؟ | مستندات و Models API |
| دسترسپذیری و منطقه | از کجا و روی کدام پلتفرم؟ منطقهٔ داده؟ | صفحهٔ مدل و قرارداد |
| پایداری و بازنشستگی | تا کی نسخه پشتیبانی میشود؟ | تاریخ بازنشستگی منبع |
| حریم خصوصی و قرارداد | نگهداری، ZDR، منطقه؟ | سیاست ارائهدهنده |
آنچه جدول رسمی نشان میدهد (نمونه)
در تاریخ ۱۹ اکتبر ۲۰۲۶ صفحهٔ «Models overview» برای چهار مدل فعلی Anthropic یک جدول مقایسه داشت: برچسب تأخیر نسبی (از «کندتر» تا «سریعترین»)، قیمت ورودی و خروجی هر میلیون توکن، شناسهٔ API، پنجرهٔ زمینه (در آن نمونه ۱ میلیون توکن برای هر چهار مدل)، سقف خروجی، تاریخ کاتآف دانش و «زمان بازنشستگی نه زودتر از» (از سپتامبر تا اکتبر ۲۰۲۷ برای مدلهای آن جدول). پیشنهاد ارائهدهنده این بود که اگر مطمئن نیستید با مدل پیشنهادی شروع کنید و اگر evalهای شما با آن (حتی در سطح تلاش بالاتر) کافی نبود به مدل قویتر بروید؛ و مدل سبکتر را برای کارهای حجیم و حساس به تأخیر مثل دستهبندی، استخراج و مسیریابی معرفی کرده بود. این دقیقاً الگوی «از ارزان شروع کن، با eval ارتقا بده» است، اما اعداد و نامها را از صفحه روز بخوانید؛ ما برای تصمیم شما عددی نقل نمیکنیم.
دو نکتهٔ فنی از همان منابع: (۱) Models API قابلیتها و حدود توکن را برنامهای میدهد و مستندات میگوید «خط مدل» را از روی شناسه حدس نزنید؛ (۲) مدلهای ۴٫۷ به بعد توکنایزر جدید دارند و برای همان متن ≈۳۰٪ توکن بیشتر میشمارند، پس مقایسهٔ هزینهٔ دو نسل را با «قیمت هر توکن» تنها انجام ندهید و توکن واقعی را روی هر مدل بشمارید. نقطههای پایانی منطقهای در Bedrock و Google Cloud هم ۱۰٪ گرانترند (طبق صفحهٔ قیمت).
روش آزمون روی داده خودتان
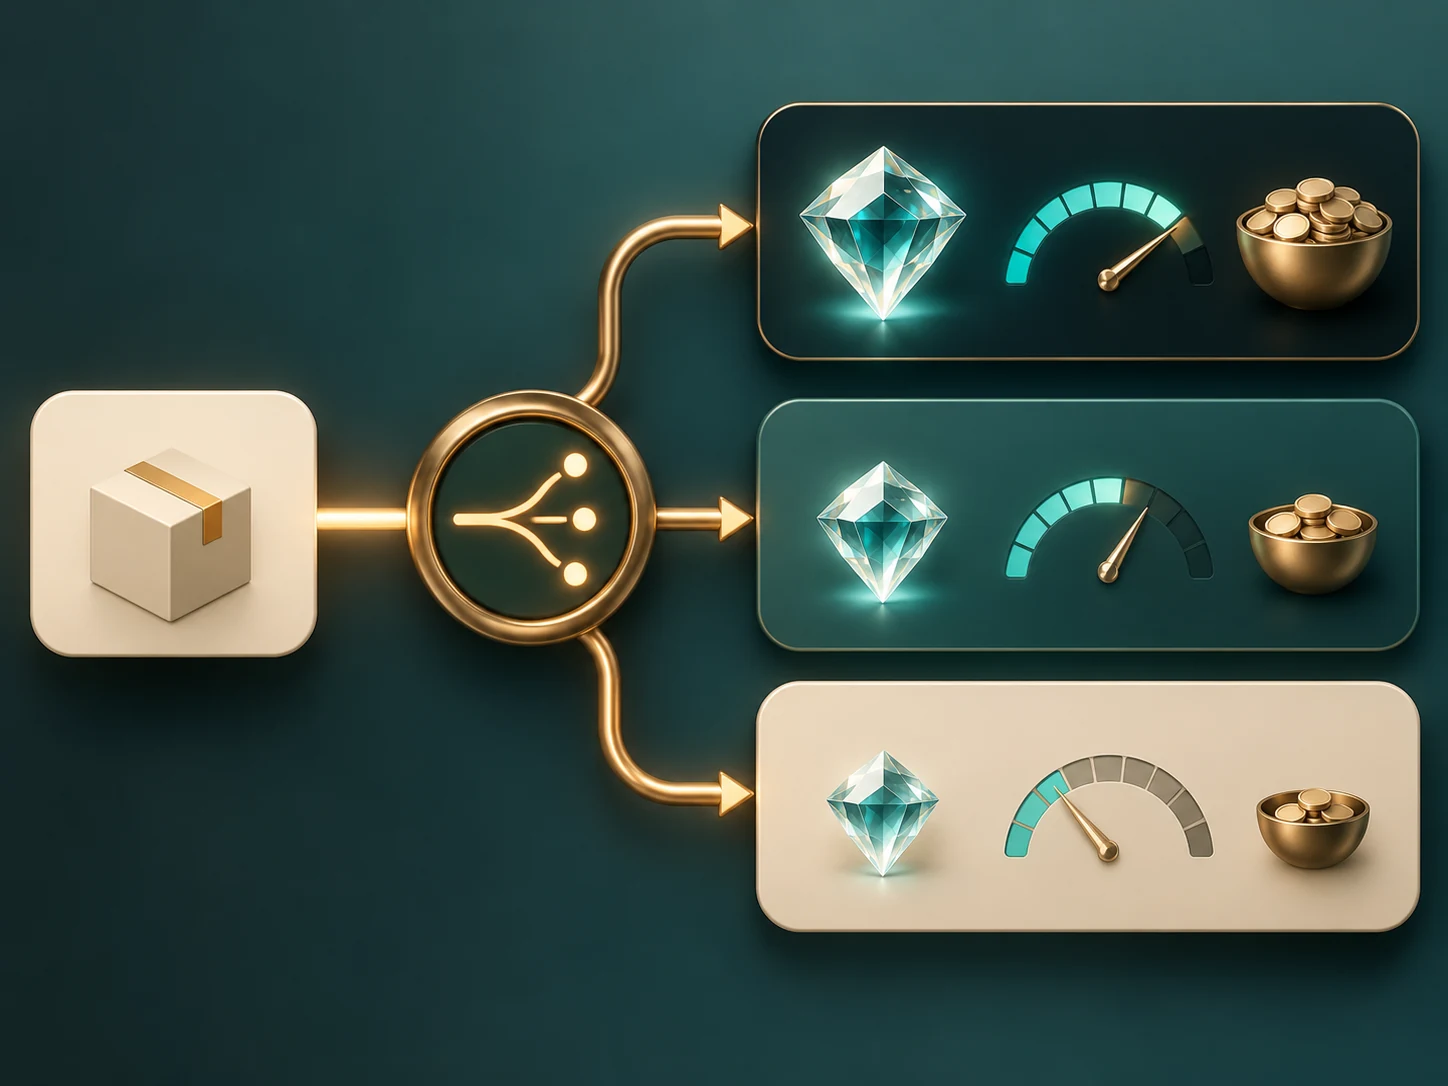
- دیتاست: ۵۰ تا ۲۰۰ مورد واقعی و مرزی (عدد پیشنهادی نویسنده) با معیار گذر؛ OpenAI و Anthropic هر دو تأکید میکنند evalها باید شبیه ترافیک تولید باشند و چندبعدی (دقت، تأخیر، هزینه، حریم خصوصی).
- نامزدها: ۲ تا ۴ مدل از ردههای مختلف (سبک، میانه، قوی) و در صورت نیاز از ارائهدهندگان مختلف.
- اجرای یکسان: همان prompt (و در صورت نیاز prompt بهینهشده برای هر مدل، جدا ثبت شود)، چند بار تکرار برای سنجش نوسان.
- اندازهگیری: درصد گذر در گروهها، تأخیر p50/p95، هزینهٔ هر وظیفه با توکن شمارششده روی همان مدل.
- تحلیل خطا: مدل ارزانتر کجا شکست میخورد؟ آیا با prompt بهتر یا RAG جبران میشود؟
- تصمیم: ارزانترین مدلی که آستانهها را برآورده کند؛ مدل قویتر فقط برای مسیرهای سخت (مسیریابی).
مسیریابی و پشتیبان
الگوی رایج (توصیهٔ نویسنده): مدل سبک برای کار حجیم و ساده، مدل قویتر برای مواردی که سبک با اطمینان پایین یا اعتبارسنجی ناموفق رد میشود. پشتیبان هم لازم است: مدلی دوم برای وقتی ارائهدهنده در دسترس نیست یا مدل بازنشسته میشود؛ با eval سنجیده و در پیکربندی نگهداشته شود، نه در کد.
ریسک وابستگی
- بازنشستگی و تغییر نسخه: تاریخ بازنشستگی منبع را در تقویم بگذارید و پس از هر تغییر مدل eval را تکرار کنید.
- قیمت: قیمتها تغییر میکنند؛ هزینهٔ هر وظیفه را ماهانه از لاگ بسنجید.
- قفلشدن: لایهٔ انتزاع برای فراخوانی مدل، prompt و schema نسخهبندیشده، و دیتاست ارزیابی مستقل از ارائهدهنده.
- دسترسی و پرداخت: از ایران وضعیت دسترسی، پرداخت و تحریمها را جدا بررسی کنید؛ ما بررسی نکردهایم.
مثال ساختگی
یک محصول پشتیبانی فرضی سه مدل از سه رده را روی ۱۲۰ مورد آزمود. مدل سبک ۸۲٪ گذشت و ۹۰٪ موارد ساده را درست داد، مدل میانه ۹۱٪، و مدل قوی ۹۴٪ با تأخیر و هزینهٔ چند برابر (اعداد فرضی). تصمیم: مدل سبک برای دستهبندی و پاسخهای ساده، مدل میانه برای پاسخهای مبتنی بر RAG، مدل قوی فقط برای مواردی که اعتبارسنجی رد کند؛ بازبینی تصمیم هر سه ماه یا هنگام اعلام بازنشستگی. هیچکدام از عددها از آزمون واقعی نیست.
مدیریت تصمیم در طول زمان
انتخاب مدل یک بار انجام نمیشود. یک «رکورد تصمیم» کوتاه نگه دارید: تاریخ، مدل و نسخهٔ انتخابشده، نتیجهٔ eval، هزینهٔ هر وظیفه، منبع قیمت و پنجره، مالک تصمیم و تاریخ بازبینی بعدی. هر بار ارائهدهنده مدل جدید یا اعلام بازنشستگی منتشر کرد، همان دیتاست را روی نامزد جدید اجرا کنید و نتیجه را کنار رکورد قبلی بگذارید. اگر مدل جدید ارزانتر یا سریعتر است ولی در یک گروه حساس افت دارد، همان گروه را در گزارش نشان دهید تا تصمیم آگاهانه باشد.
در سطح کد، نام مدل را در پیکربندی نگه دارید، نه در منطق برنامه، و برای هر مسیر (دستهبندی، پاسخدهی، استخراج) یک پیکربندی جدا داشته باشید تا تعویض یک مسیر بقیه را نشکند. لاگ هر درخواست باید نام مدل، تعداد توکن ورودی و خروجی، تأخیر و نتیجهٔ اعتبارسنجی را ثبت کند تا گزارش هزینهٔ ماهانه از داده واقعی ساخته شود و با برآورد اولیه مقایسه شود. با حجم کم هم میتوانید این کار را با یک جدول ساده شروع کنید و بعداً به داشبورد برسید.
اشتباهات رایج
- انتخاب بر اساس رتبهبندی عمومی یا تبلیغات بدون آزمون روی داده خود.
- مقایسهٔ هزینه با قیمت هر توکن و نادیدهگرفتن تفاوت توکنایزر و طول پاسخ.
- مقایسهٔ تأخیر با یک درخواست بهجای p95 و بار واقعی.
- نداشتن پشتیبان و راه خروج.
- ثبتنکردن تاریخ و منبع تصمیم، و فراموشی بازنشستگی مدل.
چکلیست
- معیارها و آستانهها (کیفیت، تأخیر، هزینه، حریم خصوصی) نوشته شده است.
- دیتاست واقعی و مرزی با معیار گذر داریم.
- ۲ تا ۴ نامزد از ردههای مختلف با یک روش آزموده شدهاند.
- هزینهٔ هر وظیفه با توکن شمارششده روی هر مدل محاسبه شده است.
- قیمت، پنجرهٔ زمینه و تاریخ بازنشستگی از صفحهٔ رسمی تاریخدار ثبت شده است.
- مسیریابی و مدل پشتیبان تعریف شده است.
- سیاست داده، منطقه و دسترسی/پرداخت بررسی شده است.
- تاریخ بازبینی تصمیم مشخص است.
برای برنامهریزی برنامهریزی پروژه نرمافزاری و آمادگی نرمافزار آمادهٔ تولید را ببینید.
منابع و مراجع
- Models overview — Anthropic (Claude Platform Docs)، 2026-10-19.
- Pricing — Anthropic (Claude Platform Docs)، 2026-10-19.
- Evaluation best practices — OpenAI API Docs، 2026-10-19.
- Define success criteria and build evaluations — Anthropic (Claude Platform Docs)، 2026-10-19.
- Pricing — OpenAI API Docs، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.