تست prompt و مدل هوش مصنوعی
چطور رگرسیون prompt و مدل را تست کنیم؟ golden set، داور LLM محدود، آستانهٔ تغییر و بازبینی انسانی با مثال و چکلیست.
سا
6 دقیقه مطالعهسهیل ابراهیمپور
بنیانگذار و مهندس محصول
کد معمولی با یک تست شکستخورده نشان میدهد چه چیزی خراب شده. در قابلیتهای LLM، تغییر یک جمله در prompt یا تعویض نسخهٔ مدل میتواند ده رفتار را همزمان تغییر دهد، بعضی بهتر و بعضی بدتر، و بدون تست رگرسیون کسی نمیفهمد. این مقاله نشان میدهد چطور برای prompt و مدل یک «golden set»، داور محدود، معیار تغییر و بازبینی انسانی بسازید و در جریان تحویل محصول اجرا کنید.
مرجع: راهنمای «Evaluation best practices» از OpenAI و «Define success criteria and build evaluations» از Anthropic، خواندهشده در ۱۹ اکتبر ۲۰۲۶. پلتفرم Evals در OpenAI طبق همان صفحه در حال توقف است (فقطخواندنی از ۳۱ اکتبر و خاموشی ۳۰ نوامبر ۲۰۲۶)، پس مقاله به ابزار خاصی وابسته نیست و میتوانید با اسکریپت خودتان اجرا کنید. آستانهها، تعداد تکرار و قالب گزارش توصیهٔ نویسنده و فرضیاند. فرض میکنیم دیتاست ارزیابی از قبل دارید. برای معیار پذیرش user story را ببینید.
چرا تست معمولی کافی نیست؟
OpenAI میگوید مدلها ممکن است برای یک ورودی خروجی متفاوت بدهند و روشهای سنتی تست برای معماریهای هوش مصنوعی کافی نیست؛ evalها راه آزمون با وجود این تغییرپذیریاند. بنابراین «یک بار اجرا و مقایسهٔ دقیق رشتهها» شکننده است. بهجای آن: چند معیار قابلاندازهگیری، چند بار تکرار روی مواردی که حساساند، و مقایسه بهصورت توزیع، نه یک نمونه.
golden set
golden set زیرمجموعهٔ کوچک و تثبیتشدهٔ دیتاست است که هر تغییر باید از آن بگذرد (اصطلاح و ساختار توصیهٔ نویسنده). ویژگیهایش: (۱) موارد مهم کسبوکار و موارد شکستهای قبلی را دارد، (۲) برای هر مورد معیار گذر روشن دارد (باید/نباید)، (۳) تغییر آن نیاز به بازبینی دارد، و (۴) از مجموعهٔ بزرگتر ارزیابی جداست که برای کاوش و کشف مورد جدید است. هر شکست تولید پس از ناشناسسازی اول به مجموعهٔ بزرگ و سپس، اگر اهمیت دارد، به golden set میرود.
| لایه | اندازه (فرضی) | کی اجرا میشود؟ |
|---|---|---|
| golden set | ۳۰ تا ۶۰ مورد | هر تغییر prompt، مدل یا پارامتر |
| مجموعهٔ ارزیابی کامل | صدها مورد | پیش از انتشار و هفتگی |
| نمونهٔ تولید | نمونهگیری | پس از انتشار با بازبینی انسانی |
نوع معیارها
Anthropic روشهای درجهبندی را به چند دسته میبرد: تطبیق دقیق (برای برچسبهای مشخص)، شباهت (مثل کسینوسی برای سازگاری)، کدمحور (مثل اعتبارسنجی JSON) و LLM-محور (برای کیفیتهای ظریف)، و میگوید تا حد ممکن خودکار باشد. پیشنهاد (نویسنده): برای هر مورد از ارزانترین معیار معتبر استفاده کنید: اگر خروجی JSON است، با schema بسنجید؛ اگر برچسب است، تطبیق دقیق؛ فقط برای کیفیت متن آزاد به داور LLM بروید.
داور LLM محدود
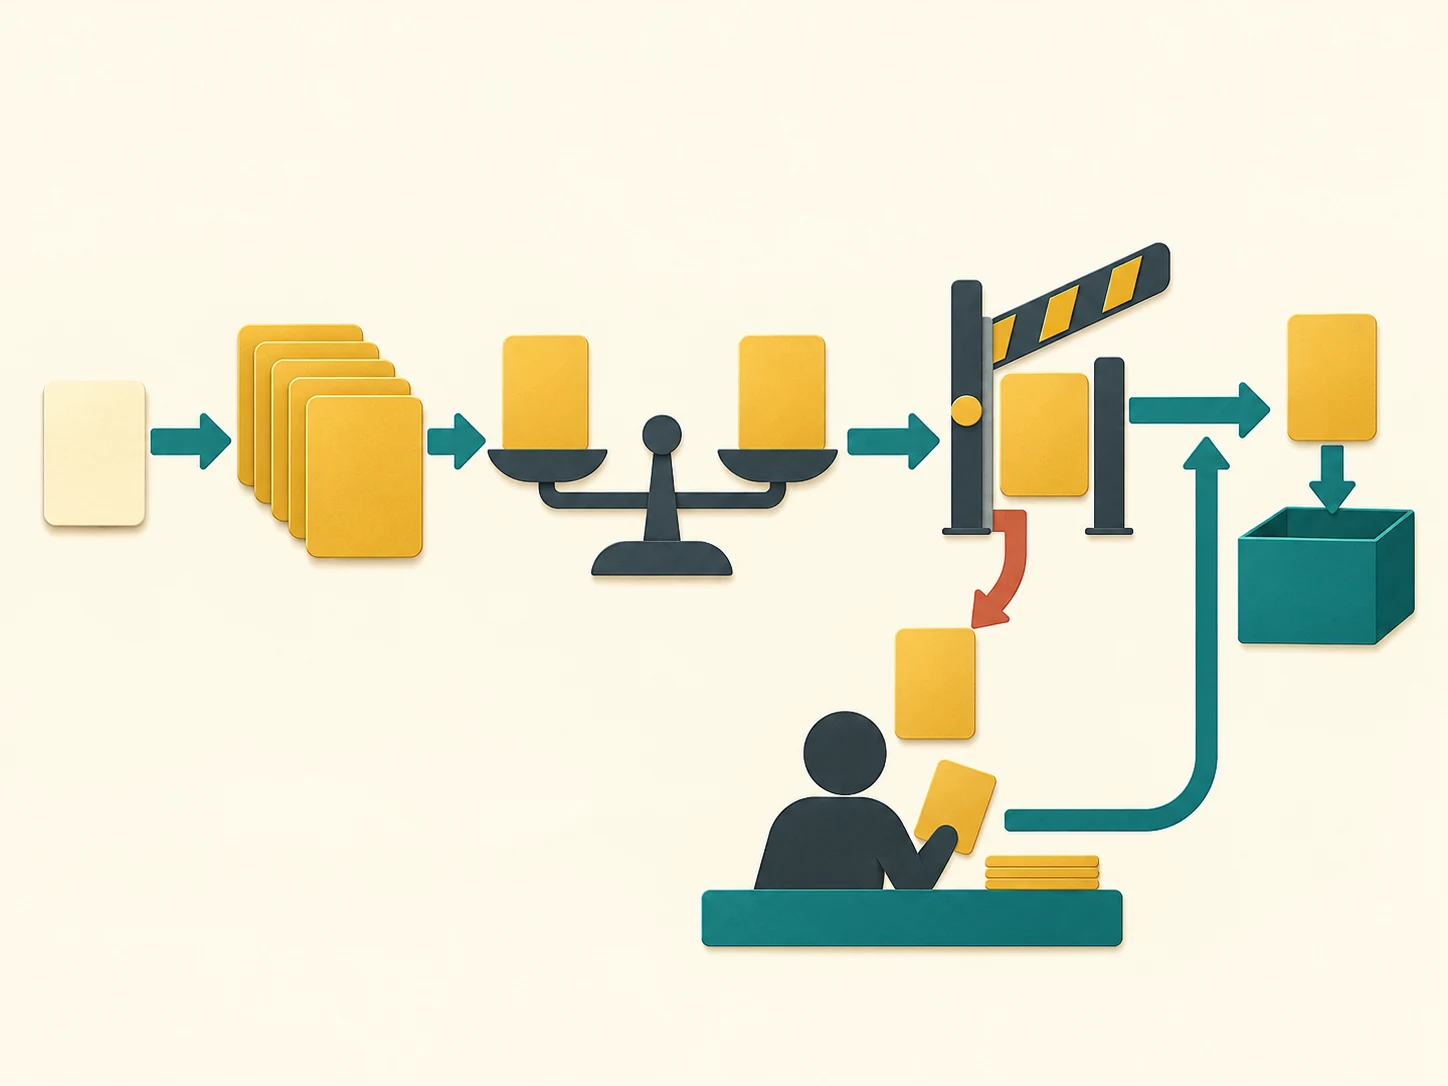
راهنمای Anthropic برای نمرهدهی با LLM سه نکته دارد: rubric دقیق و روشن، خروجی مشخص و تجربی (مثلاً فقط correct/incorrect یا مقیاس ۱ تا ۵) و استدلال پیش از امتیاز. OpenAI هم میگوید LLMها در تمایز بین گزینهها بهترند و ارزیابی باید بر مقایسهٔ دوبهدو، دستهبندی یا امتیازدهی طبق معیار مشخص تمرکز کند نه قضاوت باز، و امتیاز خودکار باید با انسان همراستا شود. «محدود» کردن داور یعنی:
- هر داور یک سؤال بسته دارد («آیا پاسخ مهلت ۷ روز را ذکر کرده؟»).
- rubric همراه نمونهٔ گذر و رد است.
- بخشی از نمونهها (مثلاً ۱۰ تا ۲۰٪، عدد فرضی) را انسان هم امتیاز میدهد تا توافق داور و انسان سنجیده شود.
- مدل داور را ثابت نگه دارید و تغییر آن را مثل تغییر ابزار تست ثبت کنید، وگرنه تغییر امتیاز را به تغییر محصول نسبت میدهید.
- داور نباید همان مدل و prompt محصول باشد بدون بازبینی؛ خطای مشترک ممکن است پنهان بماند (احتیاط نویسنده، منبع رسمی نیاوردهایم).
معیار تغییر: چه چیزی «رگرسیون» است؟
آستانهها را پیش از اجرا بنویسید (اصل «معیار قابلاندازهگیری» در Anthropic). پیشنهاد نویسنده:
- موارد حیاتی: هر شکست در موارد حیاتی (ایمنی، مبلغ، حقوق) انتشار را متوقف میکند، صرفنظر از میانگین.
- میانگین گروه: افت بیش از آستانهٔ تعیینشده (مثلاً چند درصد) در یک گروه نیاز به بررسی دارد.
- بهبود جابهجا شده: اگر تغییر ۵ مورد را درست و ۴ مورد را غلط کرد، فهرست موارد را ببینید، میانگین کافی نیست.
- تغییرپذیری: اگر دو اجرای متوالی همان نسخه تفاوت دارند، آستانه باید بزرگتر از آن نوسان باشد.
- هزینه و تأخیر: Anthropic قیمت و تأخیر را از معیارهای موفقیت میشمارد؛ آنها را هم در گزارش بیاورید.
بازبینی انسانی
OpenAI «تطبیق» امتیاز خودکار با قضاوت انسان را لازم میداند و «حسی» ارزیابیکردن را ضدالگو. بازبینی انسانی در سه جا: (۱) موارد جدید یا مبهم، (۲) نمونهای از موارد گذشته توسط داور برای کنترل داور، (۳) نمونهای از پاسخهای تولید پس از انتشار. نتایج بازبینی به دیتاست برمیگردد. زمان بازبینی را محدود کنید: ۲۰ مورد با دقت بهتر از ۲۰۰ مورد با عجله.
اجرا در جریان تحویل
- prompt، پارامترهای مدل و نسخهٔ مدل در مخزن نسخهبندی میشوند (مثل کد).
- در هر درخواست ادغام (PR) golden set با اسکریپت اجرا میشود و گزارش بهصورت جدول گروهها در PR میآید.
- شکست در موارد حیاتی یا افت از آستانه، ادغام را متوقف میکند.
- قبل از انتشار مجموعهٔ کامل و بازبینی انسانی اجرا میشود.
- پس از انتشار، نمونهای از تولید بازبینی و شکستها به دیتاست اضافه میشود.
- هر تغییر نسخهٔ مدل از سوی ارائهدهنده یا ما یک اجرای کامل و مقایسهٔ گزارش میطلبد.
این همان «ارزیابی پیوسته» OpenAI است: اجرای eval در هر تغییر، پایش موارد جدید نامعینی و رشد دیتاست.
مثال ساختگی گزارش
| گروه | قبل | بعد | نتیجه |
|---|---|---|---|
| حیاتی (۱۰) | ۱۰/۱۰ | ۹/۱۰ | توقف؛ مورد ۷ بررسی شود |
| معمول (۲۰) | ۱۸/۲۰ | ۱۹/۲۰ | بهبود |
| بیربط (۸) | ۷/۸ | ۷/۸ | بدون تغییر |
عددها فرضیاند. حتی با بهبود در گروه معمول، یک شکست در گروه حیاتی تغییر را متوقف میکند.
اشتباهات رایج
- مقایسهٔ رشتهای دقیق خروجی آزاد.
- پذیرش تغییر فقط با میانگین کلی.
- داور LLM بدون rubric و بدون کنترل انسانی.
- تغییر مدل داور بیثبت.
- تکرار نکردن اجرا و نادیدهگرفتن نوسان.
- نسخهبندی نکردن prompt.
چکلیست
- golden set با معیار گذر روشن داریم.
- ارزانترین معیار معتبر برای هر مورد انتخاب شده است.
- داور LLM rubric، خروجی بسته و نمونهای انسانی دارد.
- آستانهٔ توقف و موارد حیاتی پیش از اجرا نوشته شده است.
- نوسان اجرا سنجیده شده است.
- prompt و مدل نسخهبندی و اجرا در PR خودکار است.
- بازبینی انسانی نمونهای پس از انتشار انجام میشود.
برای چارچوب کلی آمادگی انتشار نرمافزار آمادهٔ تولید و برای پایش پایش سیستم را ببینید.
منابع و مراجع
- Evaluation best practices — OpenAI API Docs، 2026-10-19.
- Define success criteria and build evaluations — Anthropic (Claude Platform Docs)، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.