چرا هوش مصنوعی گاهی با اطمینان کامل پاسخ اشتباه میدهد؟
توضیح اطمینان ظاهری مدل در برابر صحت واقعی، پیوند با confabulation در NIST و بیشاتکایی در OWASP، با راهکارهای عملی برای برنامهنویس.
بنیانگذار و مهندس محصول
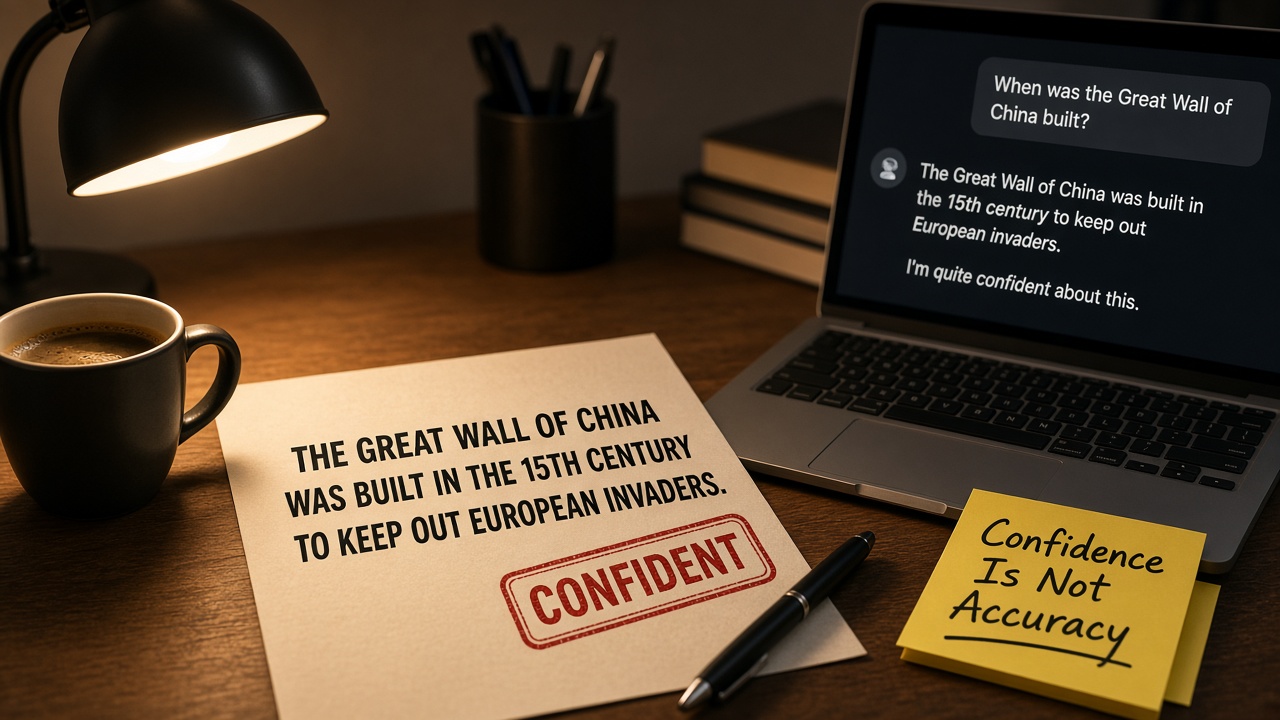
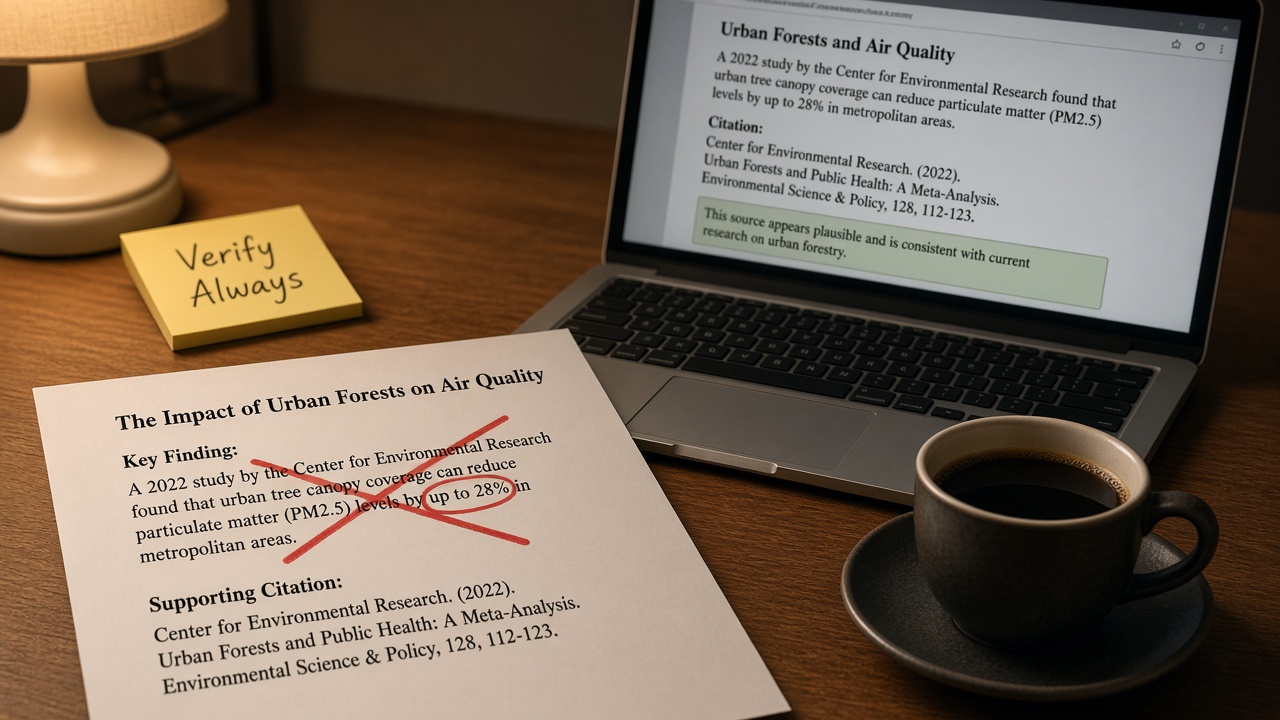
لحن مدل میتواند قاطع، مؤدب و پر از جزئیات باشد — در حالی که اصل ادعا نادرست است. این شکاف بین اطمینان ظاهری (apparent confidence) و صحت (correctness) همان چیزی است که برنامهنویس را به قبول almost-right یا کاملاً غلط میکشاند.
NIST در تعریف Confabulation تأکید میکند محتوا «با اطمینان بیان میشود» ولی نادرست است؛ و هشدار میدهد کاربران ممکن است بهخاطر همین لحن مطمئن گمراه شوند. در ریسک Human-AI Configuration نیز به automation bias و بیشاتکایی به سیستمهای خودکار اشاره میکند. OWASP در خانوادهٔ LLM Top 10، بیشاتکایی (overreliance) و اطلاعات نادرست را ریسک میداند چون خروجی معتبر بهنظر میرسد.
Stack Overflow در سالهای اخیر شکاف استفادهٔ بالا و اعتماد پایین به دقت را ثبت کرده؛ یعنی جامعهٔ برنامهنویس این پدیده را لمس کرده، حتی اگر همیشه نامش را confabulation نگذارد.
پاسخ کوتاه
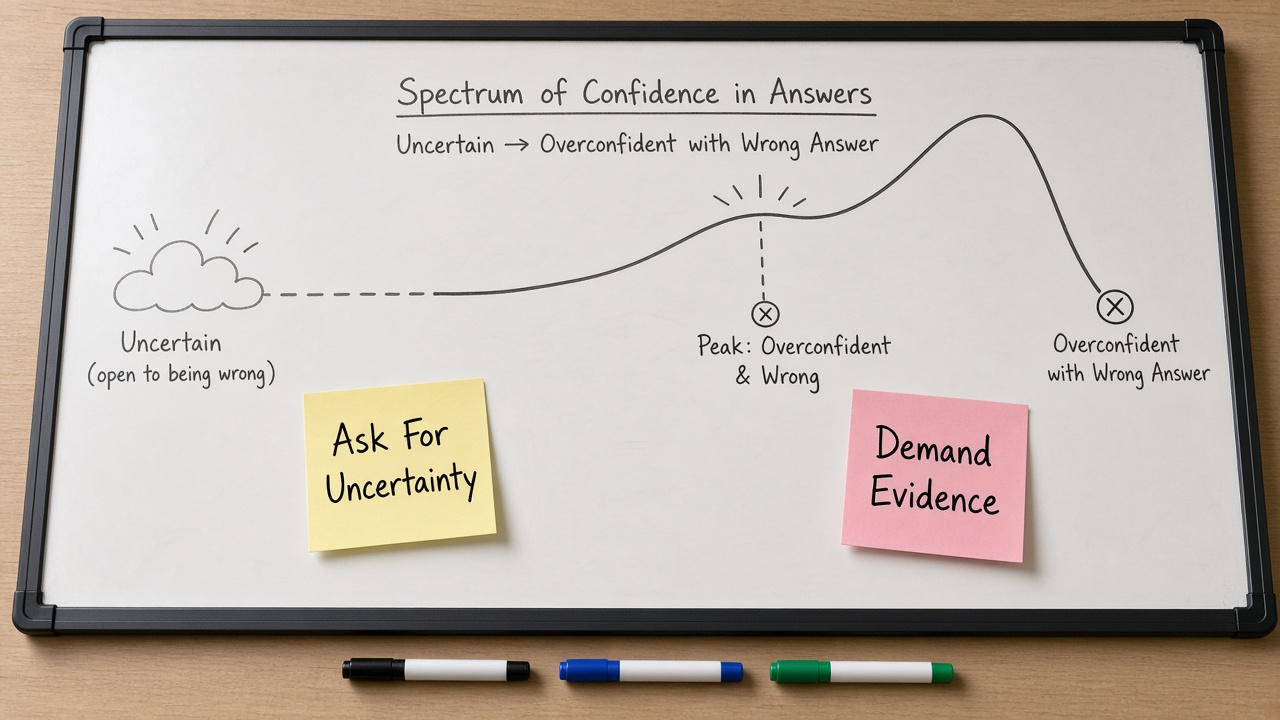
مدل برای «درست بودن» به معنای پایگاهدادهٔ حقیقت بهینهسازی نشده؛ برای تولید ادامهٔ محتمل و مفید بهینهسازی شده است. لحن مطمئن بخشی از الگوی زبان است، نه گزارش کالیبرهشده از احتمال صحت. بنابراین باید اطمینان متن را از شاهد خارجی جدا کنید: تست، مستند نسخه، و کد مخزن.
وقتی پاسخ خیلی مطمئن است، اول شاهد بخواهید نه احساس آرامش.
اطمینان ظاهری از کجا میآید؟
چند لایه همزمان کار میکنند:
- آموزش روی متنهایی که انسانها در آنها قاطع مینویسند (مستند، پست، پاسخ)
- هدف تولید پاسخ مفید و روان؛ تردید بیش از حد اغلب تنبیه ضمنی میشود
- توانایی ساخت توضیح زنجیرهای حتی وقتی نتیجه غلط است (confabulated logic)
- نبود کانال جداگانهٔ «احتمال صحت» که به کاربر نشان داده شود
نتیجه: جملههایی مثل «قطعاً باید از X استفاده کنید» ممکن است فقط الگوی زبانی باشد. در کدنویسی، این الگو به importهای ساختگی، فلگهای خیالی و معماریهای کلیشهای منجر میشود که «درست به گوش میرسند».
چرا مغز ما فریب میخورد؟
انسانها به سیگنالهای اجتماعی اطمینان — جزئیات، واژگان تخصصی، ساختار منطقی — واکنش نشان میدهند. NIST این را در چارچوب پیکربندی انسان-AI و automation bias میگنجاند: با گذشت زمان ممکن است محتوای تولیدشده را باکیفیتتر از منابع دیگر فرض کنیم. وقتی خستهاید یا عجله دارید، هزینهٔ شک کردن بالا به نظر میرسد و هزینهٔ قبول کردن پایین — تا وقتی در production بترکد.
نمونههای برنامهنویسی
| صحنه | لحن مدل | واقعیت |
|---|---|---|
| انتخاب API | «بهترین روش رسمی همین است» | برای نسخهٔ شما منسوخ است |
| دیباگ | «علت ۱۰۰٪ این race است» | فرضیه بدون بازتولید |
| امنیت | «این کافی و امن است» | کنترل دسترسی جا افتاده |
| وابستگی | «این پکیج استاندارد است» | نام در رجیستری نیست |
الگوی مشترک: قطعیت زبانی بدون ارجاع قابلتأیید به فایل، نسخه، یا تست.
اطمینان در برابر کالیبراسیون
در یادگیری ماشین، مدل کالیبرهشده وقتی میگوید «۷۰٪ مطمئنم» تقریباً در ۷۰٪ موارد درست است. LLMهای چت معمولاً چنین عدد قابلاعتمادی به کاربر نهایی نمیدهند؛ حتی اگر داخل سیستم امتیازهایی داشته باشند، متن خروجی میتواند همچنان قاطع باشد. بنابراین خواندن «مطمئنم» در پاسخ را معادل احتمال بالا ندانید.
در عمل دو سیگنال مفیدتر از لحناند: (۱) آیا مدل به مسیر فایل و نقلقول مشخص ارجاع داد؟ (۲) آیا ادعایش با اجرای تست/دستور تأیید شد؟
پیوند با almost-right
در نظرسنجی Stack Overflow ۲۰۲۵، بزرگترین ناامیدی کاربران راهحلهایی بود که تقریباً درستاند ولی کامل نیستند. almost-right خطرناکتر از غلط آشکار است چون Review سطحی را عبور میدهد. اطمینان ظاهری همین درِ ورود است: «به نظر میرسد نویسنده میداند.»
چه زمانی ریسک بیشاتکایی بالاتر است؟
- حوزهٔ ناآشنا برای شما (زبان/فریمورک جدید)
- مسیرهای امنیتی، مالی، حریم خصوصی
- تغییرات چندفایلی بزرگ با Agent
- فشار زمانی و خستگی Review
- پاسخهای طولانی با جزئیات زیاد بدون شاهد
راهکارهای عملی
- از مدل بخواهید عدمقطعیت و فرضها را صریح بنویسد؛ اگر ننوشت خودتان فرضها را استخراج کنید.
- بخواهید قبل از توصیه، از فایل مشخص نقلقول بیاورد؛ بعد همان خطوط را باز کنید.
- یک آزمایش کوچک طراحی کنید: دستور، تست، یا reproduction — مشاهده بر بحث مقدم است.
- برای ادعاهای کتابخانه/فلگ، صفحهٔ رسمی همان نسخه را باز کنید.
- در تیم: Merge بدون Review انسان برای خروجی AI ممنوع؛ مخصوصاً وقتی لحن خیلی قاطع است.
- اگر دو بار پاسخ متناقض داد، منبع حقیقت را خارج از چت قفل کنید (ADR، تست، مستند).
تمرین ذهنی یکدقیقهای قبل از Accept
- اگر این را یک همکار تازهکار گفته بود، چه سوالی میپرسیدم؟
- کدام فایل/تست همین الان ادعایش را رد یا تأیید میکند؟
- اگر غلط باشد، بدترین خسارت چیست؟
اگر جواب سوال دوم خالی است، هنوز زمان Accept نیست.
اشتباههای رایج
- معادل دانستن فصاحت با تخصص
- پرسیدن «مطمئنی؟» از خود مدل بهعنوان راستیآزمایی
- قبول کردن زنجیرهٔ استدلال طولانی بدون نقطهٔ مشاهده
- خاموش کردن شک فقط چون مهلت اسپرینت نزدیک است
سوالات متداول
آیا میتوان پرامپت نوشت که همیشه تردید نشان دهد؟
میتوان لحن را محتاطتر کرد؛ کالیبراسیون واقعی جایگزین نمیشود. شاهد خارجی لازم است.
مدلهای reasoning مطمئنترند؟
گاهی در مسائل خاص بهتر عمل میکنند، اما همچنان میتوانند استدلال غلط را با جزئیات بسازند. تست و Review حذف نمیشود.
تفاوت این مقاله با hallucination چیست؟
مقالهٔ ۱۲۵ روی چیستی و تشخیص محتوای ساختگی تمرکز دارد؛ اینجا روی روانشناسی اطمینان ظاهری و بیشاتکایی — حتی وقتی محتوا فقط کمی غلط است.
خلاصه
AI چون «میخواهد بفریبد» مطمئن حرف نمیزند؛ چون زبان مطمئن را یاد گرفته و کانال جداگانهٔ احتمال صحت به شما نمیدهد. NIST این را در confabulation و automation bias صورتبندی میکند؛ OWASP بیشاتکایی را ریسک میداند. پادزهر برنامهنویس: جدا کردن لحن از شاهد، طراحی آزمایش کوچک، و حفظ Review انسانی — مخصوصاً وقتی پاسخ خیلی قاطع است.
منابع و مراجع
- NIST AI 600-1 — Generative AI Profile (Confabulation; Human-AI Configuration): https://doi.org/10.6028/NIST.AI.600-1
- NIST PDF: https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
- OWASP — Top 10 for LLM Applications: https://owasp.org/www-project-top-10-for-large-language-model-applications/
- OWASP GenAI — LLM Top 10: https://genai.owasp.org/llm-top-10/
- Stack Overflow — 2025 Developer Survey AI: https://survey.stackoverflow.co/2025/ai
- Stack Overflow Press — 2024 use/trust gap: https://stackoverflow.co/company/press/archive/stack-overflow-2024-developer-survey-gap-between-ai-use-trust/
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.