هوش مصنوعی در توسعه نرمافزار دقیقاً چه چیزهایی را تغییر داده است؟
پوشش واقعی AI روی تحلیل، طراحی، کدنویسی، تست، دیباگ، مستند و نگهداری — با تفکیک واقعیت از بازاریابی و ارجاع به Stack Overflow Survey و پژوهش GitHub Copilot.
بنیانگذار و مهندس محصول
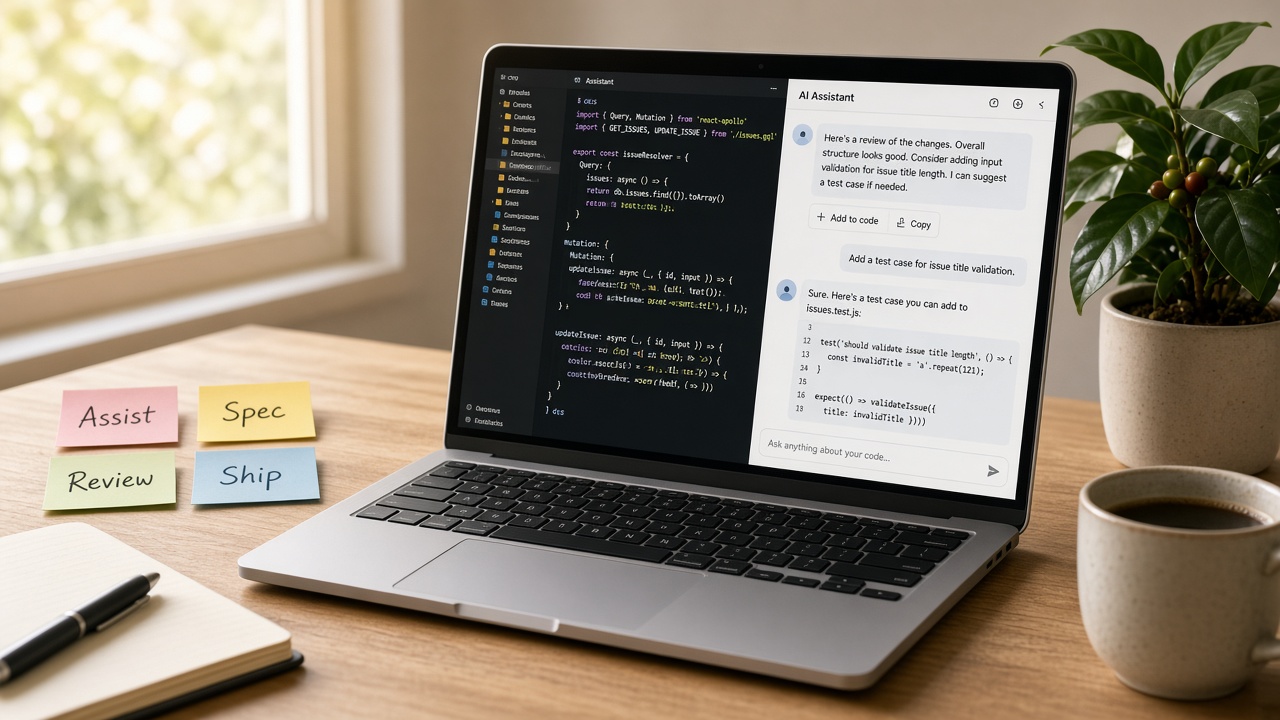
وقتی فروشنده میگوید «با AI ده برابر سریعتر کدنویسی کنید»، معمولاً یک مرحله از چرخهٔ عمر نرمافزار (Software Development Lifecycle) را بزرگنمایی میکند: نوشتن کد. واقعیت تیمها پیچیدهتر است. AI روی چند لایه اثر گذاشته — تحلیل، طراحی، پیادهسازی، تست، دیباگ، مستندسازی و نگهداری — اما شدت و کیفیت این اثر یکسان نیست، و اعتماد به خروجی هنوز پایین است.
طبق Stack Overflow Developer Survey ۲۰۲۵، حدود ۸۴٪ پاسخدهندگان از ابزارهای AI در فرایند توسعه استفاده میکنند یا برنامهای برای استفاده دارند؛ در میان حرفهایها حدود ۵۱٪ روزانه از این ابزارها بهره میبرند. همزمان، اعتماد به دقت خروجی پایین مانده: بیشتر از کسانی که اعتماد دارند، کسانی هستند که به دقت بیاعتمادند. این شکاف — استفادهٔ بالا، اعتماد پایین — نقطهٔ شروع فهم درست است.
این مقاله مرحلهبهمرحله نشان میدهد AI کجا واقعاً کار را عوض کرده، کجا فقط سرعت تایپ را بالا برده، و کجا بازاریابی از شواهد جلو زده است.
پاسخ کوتاه
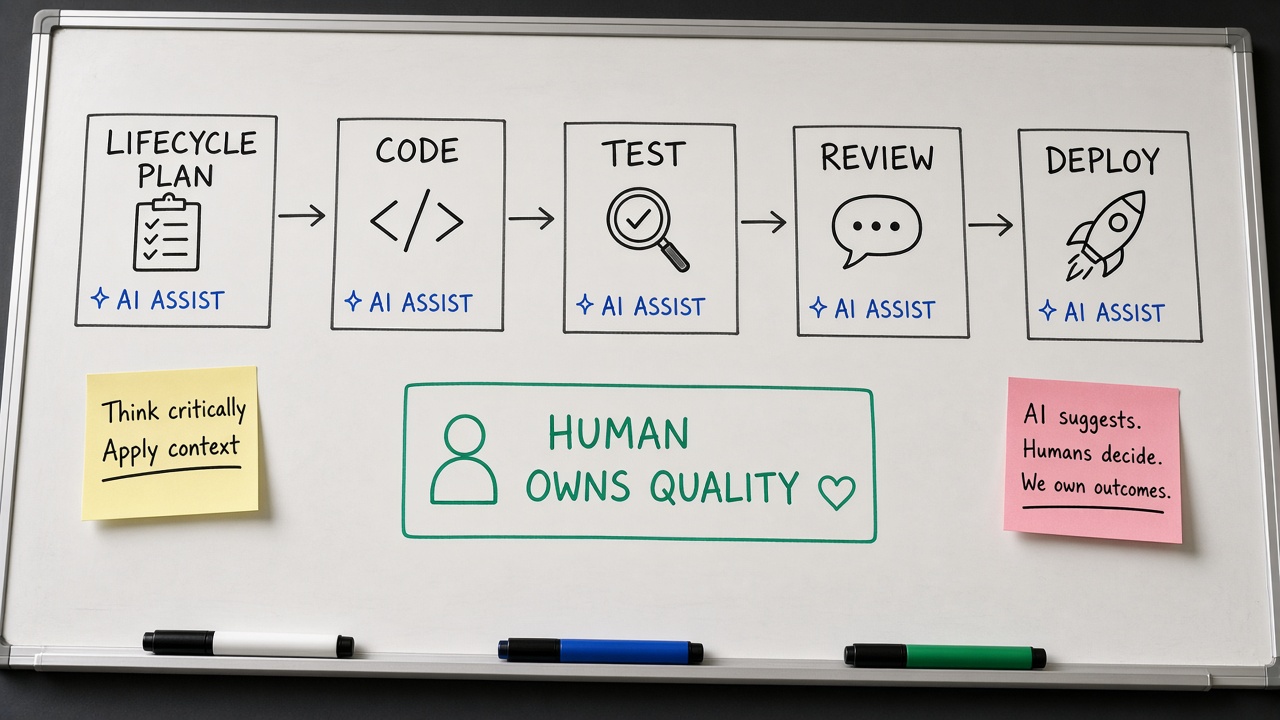
AI بیشترین ارزش را در کارهای تکراری و محلی نشان داده: تکمیل کد، پیشنویس تست و مستند، توضیح کد ناآشنا، و جستجوی سریعتر برای پاسخ. در کارهای سیستمی — معماری، اولویت محصول، استقرار و مانیتورینگ حساس — مقاومت تیمها بالاست و شواهد بهرهوری محدودتر است. پژوهش کنترلشدهٔ GitHub نشان داد گروهی که از Copilot استفاده کردند یک وظیفهٔ مشخص را حدود ۵۵٪ سریعتر تمام کردند؛ این عدد دربارهٔ یک سناریوی آزمایشگاهی است، نه حکم کلی برای کل پروژه.
تغییر واقعی یعنی جابهجایی زمان از تایپ تکراری به قضاوت مهندسی — نه حذف قضاوت.
نقشهٔ تغییر در چرخهٔ توسعه
| مرحله | تغییر مشاهدهشده | مرز واقعی |
|---|---|---|
| تحلیل و نیازمندی | خلاصهسازی تیکت، استخراج معیار پذیرش پیشنهادی | مالک محصول و ذینفع جایگزین نمیشود |
| طراحی / معماری | گزینهسازی و نقد طرح، نمودار اولیه | تصمیم مرز سرویس و داده با انسان میماند |
| کدنویسی | تکمیل، داربست، چندفایلی با Agent | بازبینی Diff و قرارداد API ضروری است |
| تست | تولید تست واحد/یکپارچهٔ پیشنویس | پوشش مسیرهای حیاتی را تضمین نمیکند |
| دیباگ | فرضیه، ردیابی لاگ، پیشنهاد وصله | باگهای زمانی/توزیعی سختترند |
| مستند | README، docstring، توضیح PR | مستند زنده بدون صاحب میمیرد |
| نگهداری | توضیح بدهی فنی، پیشنهاد ریفکتور | اولویت بدهی همچنان تصمیم مدیریتی است |
تحلیل و کشف نیاز
قبل از AI، بخش زیادی از زمان تحلیل صرف خواندن تیکتهای نیمهکاره، ایمیلها و یادداشت جلسات میشد. امروز میتوانید متن خام را به مدل بدهید و بخواهید فرضها، سوالات باز و پیشنویس Acceptance Criteria را جدا کند. این کار اصطکاک شروع را کم میکند.
اما AI نمیتواند تعارض منافع ذینفعان را حل کند یا بگوید کدام Won't Have سیاسی است. اگر معیار موفقیت نسخهٔ اول را انسان ننویسد، خروجی مدل فقط فهرست قشنگی از «بایدها» است. اشتباه رایج: قبول کردن User Story تولیدشده بدون جلسهٔ کوتاه با صاحب محصول.
طراحی و معماری
مدلها در پیشنهاد الگوهای شناختهشده (لایهٔ سرویس، صف، کش، Circuit Breaker) خوباند، بهویژه وقتی زمینهٔ پشته و محدودیت تیم را بدهید. میتوانند چند گزینه با مزایا/معایب فهرست کنند و حتی ADR پیشنویس بنویسند.
آنچه عوض نشده: هزینهٔ پیچیدگی توزیعشده، Bus Factor، و تناسب معماری با اندازهٔ تیم. نظرسنجی Stack Overflow نشان میدهد برنامهریزان و استقرار/مانیتورینگ جزو حوزههاییاند که بسیاری اصلاً قصد استفاده از AI برایشان ندارند — چون مسئولیت سیستمی و ریسک بالاست. اگر مدل گفت «از روز صفر میکروسرویس کنید» و تیم شش نفره دارید، این پیشنهاد را بهعنوان فرض قابلرد بخوانید نه حکم.
کدنویسی و تولید پیادهسازی
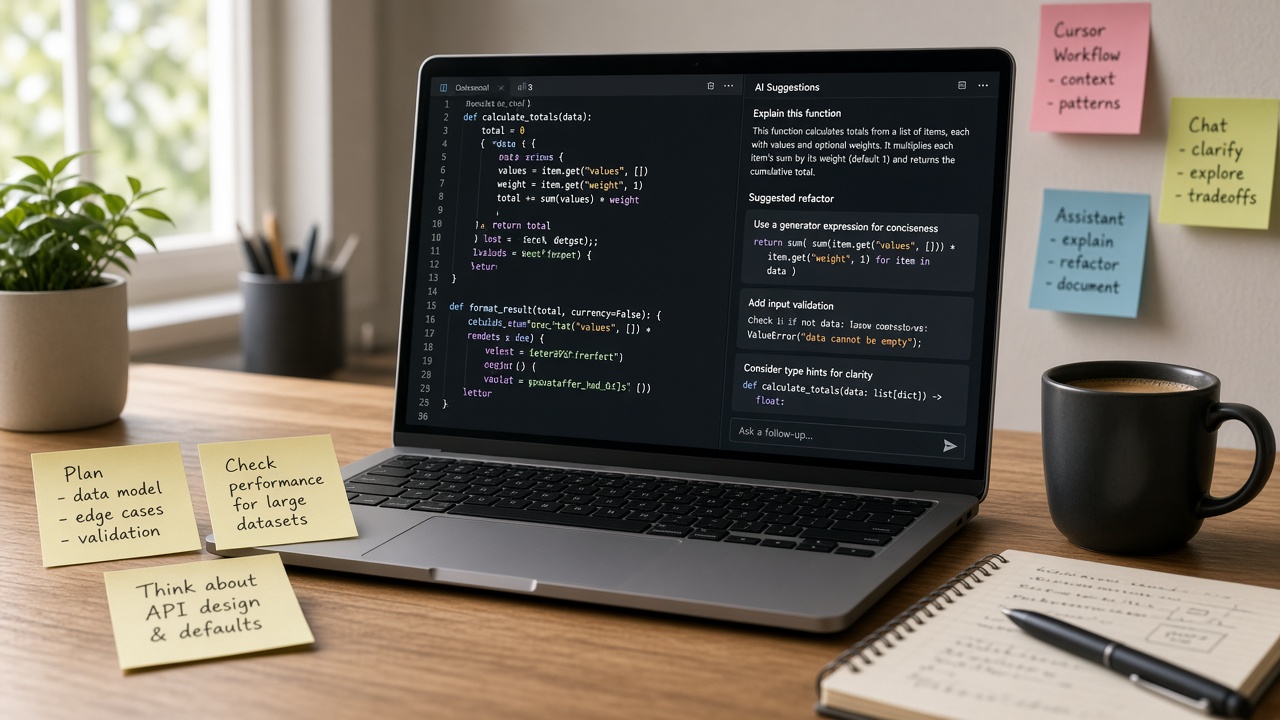
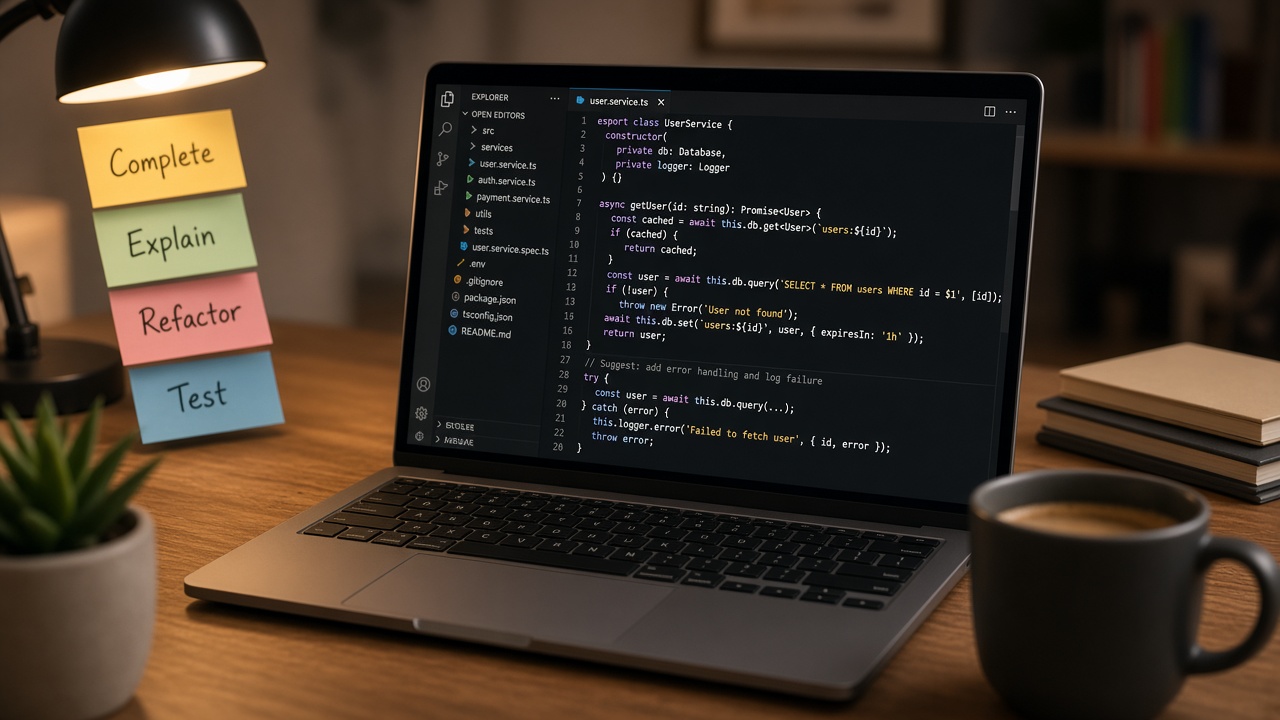
اینجا بیشترین تغییر ملموس رخ داده. تکمیلکنندههایی مثل GitHub Copilot در IDE پیشنهاد خط و تابع میدهند؛ ویرایشگرهای AI-native مثل Cursor با ایندکس مخزن و Agent چندفایلی کار میکنند. مستندات رسمی Copilot آن را «دستیار کدنویسی» مینامد که پیشنهاد کد، چت، کمک خط فرمان و حتی تحقیق/برنامه/تغییر و ساخت PR را پوشش میدهد.
پژوهش GitHub (و مقالهٔ آکادمیک همراه) در یک آزمایش کنترلشده با ۹۵ توسعهدهندهٔ حرفهای نشان داد گروه دارای Copilot وظیفهٔ پیادهسازی HTTP server در JavaScript را حدود ۵۵٪ سریعتر تمام کرد (بازهٔ اطمینان ۹۵٪ تقریباً ۲۱٪ تا ۸۹٪). نرخ تکمیل وظیفه هم کمی بالاتر بود (۷۸٪ در برابر ۷۰٪). این شواهد قوی برای «سرعت روی وظیفهٔ محدود و آشنا» است — نه برای «کیفیت معماری کل سیستم» یا «کاهش باگ production».
در نظرسنجی ۲۰۲۵، بزرگترین ناامیدی کاربران این بود که راهحل AI «تقریباً درست اما نه کاملاً» است (حدود ۶۶٪)، و دیباگ کد تولیدشده گاهی وقتگیرتر میشود (حدود ۴۵٪). یعنی سرعت تایپ میتواند با هزینهٔ بازبینی و اصلاح جبران شود اگر فرآیند Review نداشته باشید.
تست
تولید تست واحد از روی تابع، ساخت جدول ورودی/خروجی، و پیشنهاد edge case از نقاط قوت مدل است. تیمها اغلب برای boilerplate تست و دادهٔ مصنوعی از AI استفاده میکنند یا قصد استفاده دارند.
محدودیت: مدل تمایل دارد تستی بنویسد که کد فعلی را «تأیید» کند، نه رفتار مطلوب را. اگر پیادهسازی اشتباه باشد، تست تولیدشده میتواند اشتباه را قفل کند. مسیر پول، احراز هویت و همزمانی را بدون معیار پذیرش انسانی به مدل نسپارید. تست خصمانه و تست امنیت هنوز عمدتاً کار انسان و ابزار تخصصی است.
دیباگ و رفع اشکال
چسباندن stack trace، لاگ و قطعهٔ مشکوک به چت، فرضیهسازی سریع میدهد. Agentهایی که تست را اجرا میکنند و خروجی را میبینند، حلقهٔ observe را کوتاه میکنند. این برای باگهای محلی و تکرارپذیر مفید است.
برای race condition، مشکل شبکه، و باگهایی که فقط در production با دادهٔ واقعی ظاهر میشوند، مدل بدون مشاهدهپذیری کافی حدس میزند. اگر لاگ ساختیافته و بازتولید ندارید، AI فقط داستان قانعکننده میسازد — همان پدیدهٔ confabulation که NIST در پروفایل GenAI تعریف میکند.
مستندسازی
پیشنویس README، توضیح تابع، خلاصهٔ PR و راهنمای onboarding از حوزههایی است که پذیرش AI در آنها بالاست؛ چون هزینهٔ اشتباه معمولاً پایینتر از کد production است و بازبینی سریعتر انجام میشود.
خطر: مستند زیبا که با کد واقعی همخوان نیست. قانون ساده: مستند تولیدشده را فقط وقتی Merge کنید که نویسندهٔ انسانی مسیر اصلی را یکبار اجرا یا خوانده باشد. مستند بدون صاحب در اسپرینت بعدی میمیرد — با یا بدون AI.
نگهداری و تکامل سیستم
توضیح ماژول قدیمی، پیشنهاد ریفکتور تدریجی، و یافتن فراخوانهای یک API در مخزن بزرگ، زمان ورود به کد میراثی را کم میکند. این برای تیمهایی که Bus Factor پایین دارند ارزشمند است.
آنچه AI عوض نکرده: اولویت بدهی فنی در برابر فیچر، بودجهٔ مهاجرت، و تصمیم بازنویسی در برابر ترمیم. بازنویسی کامل با شعار «مدل همهچیز را از نو مینویسد» بدون معیار اندازهگیریشده، فرار است نه استراتژی.
واقعیت در برابر بازاریابی
| ادعا | شواهد / واقعیت | نتیجهٔ عملی |
|---|---|---|
| ۱۰× بهرهوری همهٔ کارها | شواهد قوی روی وظایف محدود و تکراری؛ نه همهٔ SDLC | متریک وظیفه تعریف کنید |
| جایگزین برنامهنویس | استفاده بالاست؛ اعتماد و تمایل به کمک انسانی بالاست | نقش به داور کیفیت تغییر میکند |
| کد بدون باگ | ناامیدی از almost-right رایج است | CI و Review اجباری |
| معماری خودکار کامل | مقاومت روی کار سیستمی بالاست | AI مشاور گزینه است نه امضاکننده |
| مستند مجانی و همیشه درست | پیشنویس سریع؛ همگامی با کد دستی است | صاحب مستند تعیین کنید |
در ۲۰۲۴ شکاف استفاده و اعتماد برجسته شد؛ در ۲۰۲۵ استفاده حتی بالاتر رفته اما بیاعتمادی به دقت همچنان غالب است. این داده با شعار «فقط به مدل تکیه کنید» سازگار نیست.
چه زمانی AI واقعاً کمک میکند؟
- کار تکراری با الگوی روشن و تست قابل اجرا
- کدناآشنا که باید سریع درک شود
- پیشنویس تست/مستند با بازبینی کوتاه
- جستجوی پاسخ و یادگیری مفهوم جدید
چه زمانی سود کمتر یا زیانبار است؟
- تصمیم معماری برگشتناپذیر بدون Spike
- مسیر امنیت، پرداخت و حریم خصوصی بدون معیار
- تغییر بزرگ بدون شاخهٔ جدا و بدون Review
- تیم تازهکار که فقط کپی میکند و نمیفهمد
اشتباههای رایج تیمها
- اندازهگیری فقط با «خطوط تولیدشده» بهجای리드 time و نرخ برگشت
- خاموش کردن تأیید انسانی برای سرعت کاذب
- دادن Secret و دسترسی کامل سرور به ابزار (موضوع مقالات امنیتی سری)
- قبول آمار فروشنده بدون تکرار آزمایش روی مخزن خودتان
- نادیده گرفتن almost-right: خطرناکتر از غلط آشکار است
سوالات متداول
آیا باید همهٔ تیم یک ابزار AI داشته باشند؟
نه لزوماً یکسان. مهمتر از برند، قواعد تیمی است: شاخهٔ محافظتشده، Review، ممنوعیت Secret در پرامپت، و تعریف کارهایی که اصلاً به Agent سپرده نمیشوند.
آیا پژوهش ۵۵٪ سریعتر یعنی اسپرینت ما نصف میشود؟
خیر. آن عدد مربوط به یک وظیفهٔ کنترلشده است. در کار واقعی، جلسات، انتظار CI، ابهام نیازمندی و بازبینی سهم بزرگی دارند. انتظار واقعبینانه: کاهش زمان boilerplate و افزایش ظرفیت برای کار سختتر — اگر Review حفظ شود.
از کجا بفهمیم بازاریابی است؟
بپرسید: شاهد روی چه وظیفهای است؟ بازهٔ اطمینان چیست؟ روی مخزن ما تکرار شده؟ چه چیزی اندازهگیری نشده (کیفیت، امنیت، نگهداری)؟
نقش مدیر فنی و معیارهای اندازهگیری
اگر فقط خطوط کد تولیدشده را متریک کنید، تیم به سمت Generate بیشتر بدون فهم میرود. معیارهای مفیدتر: زمان چرخهٔ تیکتهای boilerplate، نرخ برگشت PR، نرخ شکست CI روی تغییرات AI-assisted، و سهم زمانی Review. پژوهش Copilot روی وظیفهٔ کنترلشده سرعت را نشان داد؛ شما باید همان منطق آزمایش را روی دو اسپرینت از مخزن خودتان تکرار کنید تا عدد بومی داشته باشید.
مدیر فنی باید مرز کارها را روشن کند: چه کارهایی با تکمیلکننده، چه کارهایی با Agent، و چه کارهایی اصلاً بدون AI. این مرز را در README تیمی بنویسید تا هر فرد سلیقهای عمل نکند.
تأثیر روی یادگیری و Juniorها
AI میتواند منحنی ورود به کدناآشنا را کوتاه کند، اما اگر Junior فقط Accept کند، بدهی مهارتی میسازد. الگوی سالم: مدل پیشنویس بدهد، Junior Diff را توضیح دهد، و Reviewer سوال مفهومی بپرسد. نظرسنجیها نشان میدهد بخشی از کاربران نگران کاهش اعتمادبهنفس حل مسئله خودشان هستند؛ این سیگنال را جدی بگیرید.
امنیت و حریم در کنار بهرهوری
شتاب کدنویسی بدون مرز Secret و دسترسی، ریسک را جابهجا میکند نه حذف. پرامپت نباید کلید، توکن، و دادهٔ مشتری داشته باشد؛ Agent نباید بهصورت پیشفرض به production دسترسی داشته باشد. مقالات ۰۹۹ و ۱۰۰ سری همین لایه را باز میکنند؛ اینجا فقط یادآوری میشود که «تغییر SDLC» شامل تغییر سطح حمله هم هست.
جمعبندی عملی برای هفتهٔ آینده
- یک نوع کار تکراری را انتخاب کنید و قبل/بعد زمان را اندازه بگیرید.
- برای همان کار، قالب پرامپت و فایلهای زمینهٔ اجباری بنویسید.
- یک قاعدهٔ Review برای خروجی AI در PR template بگذارید.
- یک قرمز امنیتی تعریف کنید: مسیرهایی که Agent بدون تأیید دوم حق لمس ندارد.
بدون این چهار قدم، بحث AI در توسعه در حد شعار میماند.
خلاصه
هوش مصنوعی توسعه را از تحلیل تا نگهداری لمس کرده، اما شدت اثر روی کدنویسی و مستند/تست پیشنویس بیشتر از معماری و عملیات حساس است. شواهد رسمی استفادهٔ بالا و اعتماد محدود را همزمان نشان میدهند؛ پژوهش Copilot سرعت روی وظیفهٔ مشخص را تأیید میکند، نه جادوی کل SDLC را. تغییر پایدار وقتی رخ میدهد که AI را به داوری مهندسی، تست و مرز دسترسی قفل کنید — نه وقتی فقط دکمهٔ Generate را فشار میدهید.
منابع و مراجع
- Stack Overflow — 2025 Developer Survey, AI section: https://survey.stackoverflow.co/2025/ai
- Stack Overflow — 2024 Developer Survey: https://survey.stackoverflow.co/2024
- Stack Overflow Press — Gap between AI use and trust (2024): https://stackoverflow.co/company/press/archive/stack-overflow-2024-developer-survey-gap-between-ai-use-trust/
- GitHub Blog — Quantifying Copilot’s impact on productivity and happiness: https://github.blog/news-insights/research/research-quantifying-github-copilots-impact-on-developer-productivity-and-happiness/
- arXiv — The Impact of AI on Developer Productivity: Evidence from GitHub Copilot: https://arxiv.org/abs/2302.06590
- GitHub Docs — What is GitHub Copilot?: https://docs.github.com/en/copilot/about-github-copilot/what-is-github-copilot
- NIST AI 600-1 — Generative AI Profile (confabulation): https://doi.org/10.6028/NIST.AI.600-1
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.