چرا AI در پروژههای بزرگ بیشتر به Context نیاز دارد؟
پنجرهٔ زمینه، بازیابی مخزن، priming و RAG برای codebaseهای بزرگ: چرا مدل بدون زمینهٔ درست توهم میسازد و چگونه Context مهندسی کنید.
بنیانگذار و مهندس محصول
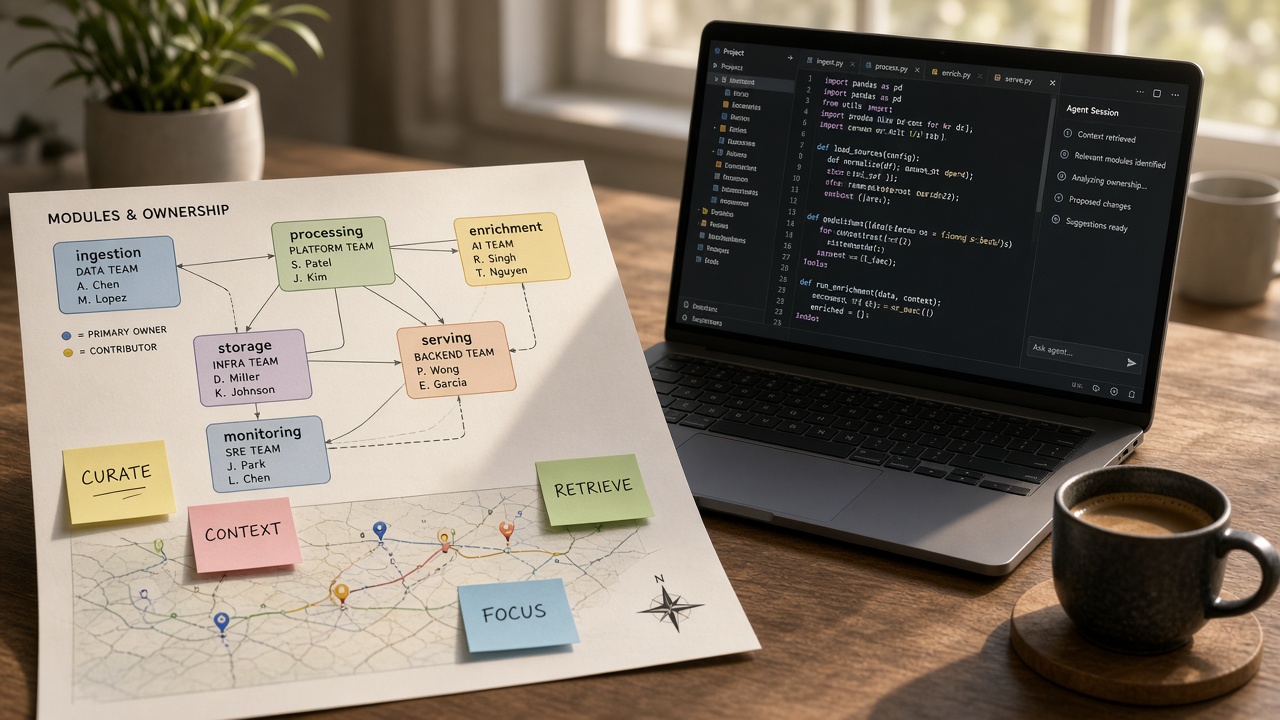
در یک مخزن صدخطی، مدل با چند فایل مرتبط اغلب «درست بهنظر میرسد». در monorepo چندصدهزار خطی با دهها سرویس، قرارداد تاریخی، و استثناهای دامنه، همان مدل بدون Context دقیق پیشنهادهایی میدهد که با نامگذاری محلی، لایهٔ دسترسی داده، یا قوانین امنیتی شما نمیخواند. مشکل هوش نیست؛ کمبود زمینهٔ قابل استفاده است.
Context اینجا فقط «چسباندن کد بیشتر در پرامپت» نیست. یعنی انتخاب آگاهانهٔ چه چیزی مدل باید بداند: قراردادها، ADRها، نمونههای الگوی مطلوب، فایلهای وابسته، و قیود عملیات. هرچه پروژه بزرگتر شود، هزینهٔ زمینهٔ غلط بالاتر میرود.
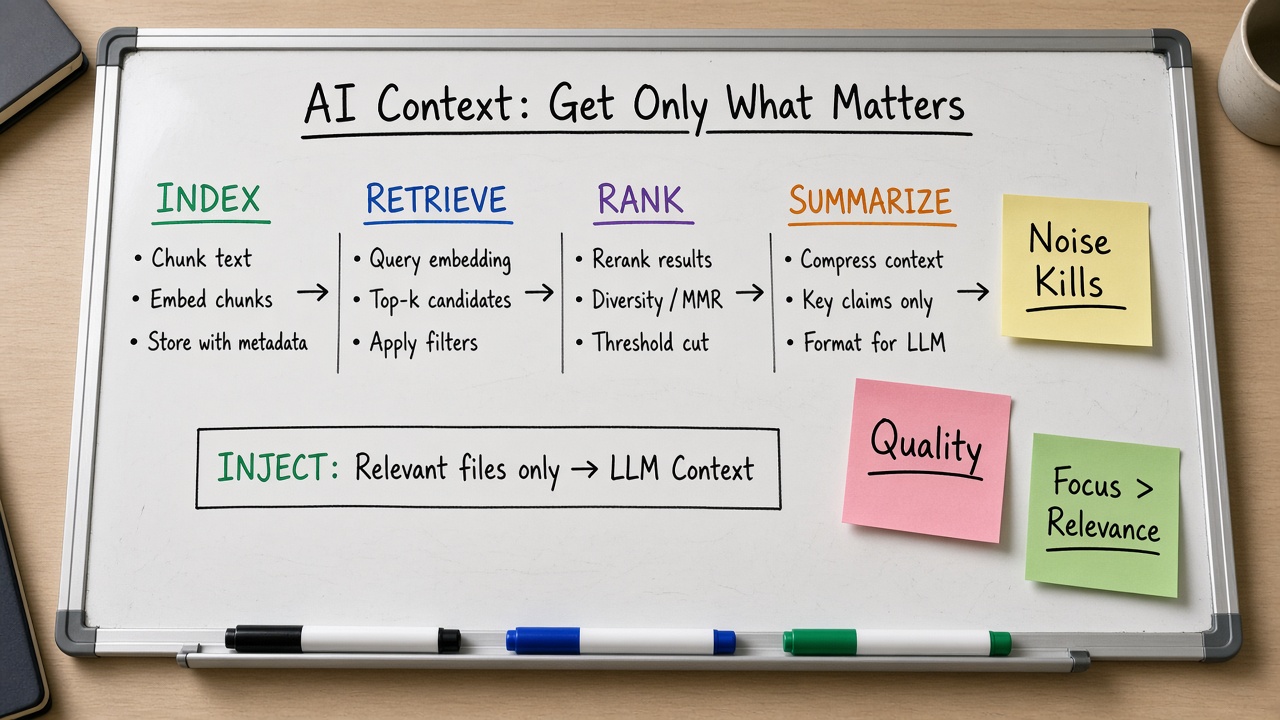
پاسخ کوتاه
چون فضای مسئله از ظرفیت مفید پنجرهٔ زمینه و از دانش آموزش عمومی مدل بزرگتر است. مدل میانگین اینترنت را میداند، نه تاریخچهٔ تصمیمهای تیم شما را. در پروژهٔ بزرگ باید Context را مهندسی کنید: priming، بازیابی هدفمند (RAG/repo map)، قوانین مخزن، و برش کار به واحدهایی که در یک نشست قابل فهماند.
مدل بدون زمینهٔ پروژه، همکار باهوشی است که دیروز onboard نشده است.
Context Window کافی نیست
حتی با پنجرههای خیلی بزرگ، پر کردن کورکورانه با هزاران فایل دو مشکل میسازد: نویز و هزینه. اطلاعات نامرتبط توجه مدل را منحرف میکند و سیگنال قرارداد مهم گم میشود. Fowler در الگوی Knowledge Priming میگوید زمینهٔ گزینششدهٔ باکیفیت (stack با نسخه، ساختار، قرارداد نام، نمونهٔ الگو) بهتر از انبوه خام است — در واقع RAG دستی.
Anthropic در Contextual Retrieval نشان میدهد تکه belبدون توضیح موقعیت، بازیابی را ضعیف میکند؛ افزودن زمینهٔ کوتاه به هر chunk کیفیت retrieval را بالا میبرد. درس برای codebase: مسیر فایل، نقش ماژول، و وابستگی را همراه قطعه نگه دارید.
چرا پروژههای بزرگ Context بیشتری میطلبند؟
- تعداد مرز دامنه و استثناهای تاریخی بیشتر است
- چند سبک کد همزمان در یک مخزن زندگی میکنند
- قراردادهای بین تیمی نانوشتهاند مگر ADR داشته باشید
- مسیرهای حیاتی (پرداخت، هویت) قوانین سختگیرانهتری دارند
- وابستگیهای نسخه و ابزار داخلی با «بهترین روش عمومی» فرق دارند
در پروژهٔ کوچک، حدس مدل از روی نام تابع اغلب کافی است. در پروژهٔ بزرگ، دو تابع همنام در دو bounded context معنای متفاوت دارند. بدون بازیابی درست، مدل یکی را با دیگری قاطی میکند.
لایههای Context عملی
۱) Context پایدار تیم (Priming)
یک بستهٔ کوتاه و بهروز: نسخهٔ زبان/فریمورک، ساختار پوشه، قواعد نامگذاری، الگوهای ممنوع، لینک ADRهای کلیدی. در Cursor Rules، CLAUDE.md، Copilot instructions یا معادلشان قرار دهید. این لایه باید کوچک و مراقبتشده بماند؛ سند ۵۰ صفحهای که کسی نمیخواند، مدل را هم گیج میکند.
۲) Context وظیفه (Task)
برای هر کار، فایلهای مستقیم، تستهای مرتبط، و قرارداد API لمسشونده را ضمیمه کنید. بهجای «کل سرویس را ببین»، بگویید کدام نمادها و مسیرها مجازند.
۳) Context بازیابیشده (Retrieval)
برای جستجوی معنایی یا ساختاری در مخزن از repo map، جستجوی نماد، و hybrid retrieval استفاده کنید. هدف: قبل از تولید، فایلهای درست را پیدا کردن — همان مشکلی که بنچمارکهای بازیابی مخزن روی آن تمرکز دارند.
۴) Context منفی (آنچه نباید)
صریحاً بگویید چه الگوهایی ممنوعاند، کدام پوشهها را نباید لمس کرد، و چه Secretهایی نباید در خروجی بیاید. Context منفی جلوی پیشنهادهای «عمومی اما خطرناک» را میگیرد.
جدول علائم کمبود Context
| نشانه در خروجی | علت محتمل | اقدام |
|---|---|---|
| وارد کردن کتابخانهٔ جدید بدون نیاز | ندیدن الگوی داخلی | نمونهٔ مجاز در priming |
| نامگذاری ناسازگار | ندیدن قرارداد | Rule نامگذاری + مثال |
| دور زدن لایهٔ سرویس | ندیدن معماری | ADR مرز لایهها |
| تستی که پیادهسازی غلط را قفل میکند | ندیدن AC | معیار پذیرش قبل از پرامپت |
| تغییر فایل نامرتبط | retrieval پهن | allowlist مسیر |
استراتژی کار روی مخزن بزرگ
- کار را به واحدهای ماژولمرزدار بشکنید؛ Fowler یادآوری میکند ماژولار بودن، Context لازم برای تغییر را کم میکند.
- قبل از تولید، از مدل بخواهید نقشهٔ وابستگی همان واحد را خلاصه کند و شما صحتش را تأیید کنید.
- تولید را به فایلهای allowlist محدود کنید؛ گسترش تدریجی پس از سبز شدن تست.
- پس از هر نشست موفق، درس را به Rule پایدار منتقل کنید تا جلسهٔ بعد از صفر شروع نشود.
- برای کارهای چندماژوله، اول قرارداد بین مرزها را ثابت کنید بعد پیادهسازی بخواهید.
RAG برای کد: مفید اما کافی نیست
بردار روی تکه کد بهتنهایی نماد و ساختار را خوب نمیفهمد. ترکیب جستجوی واژگانی، نمادین، و معنایی معمولاً بهتر است. Contextual embeddings با توضیح موقعیت chunk میتواند شکست بازیابی را کم کند، اما هنوز به curation انسان برای اسناد معماری نیاز دارید. RAG جایگزین ADR و onboarding نیست؛ مکمل است.
اگر بازیابی فایل اشتباه را به مدل بدهید، مدل با اعتماد همان اشتباه را بسط میدهد. بنابراین کیفیت retrieval را جدا از کیفیت تولید اندازه بگیرید.
Context و اعتماد؛ دادهٔ میدانی
در Stack Overflow Developer Survey 2025، پذیرش ابزارهای AI بالاست اما اعتماد به دقت پایینتر آمده و ناامیدی از راهحل تقریباً درست رایج است. در پروژهٔ بزرگ این شکاف عمیقتر میشود چون هزینهٔ «تقریباً درست» روی یک سرویس حیاتی بالاست. GitHub در تحلیل هویت توسعهدهنده در عصر AI تأکید میکند مهارتهای فهم کار، هدایت، و تأیید مرکز ثقل جدیدند — هر سه به Context وابستهاند.
ضدالگوهای تأمین Context
- Paste کردن کل لاگ و کل پوشه در هر پیام
- Priming که شش ماه بهروز نشده و نسخهها غلطاند
- اتکا به حافظهٔ چت طولانی بدون فشردهسازی تصمیمها
- دادن Secret و دادهٔ واقعی بهجای نمونهٔ مصنوعی
- فرض اینکه agent «خودش مخزن را میفهمد» بدون ارزیابی localization
چکلیست قبل از پرامپت در پروژهٔ بزرگ
- هدف یکجملهای و معیار Done نوشته شده است
- فایلها/نمادهای مرتبط فهرست شدهاند
- قیود و ممنوعیتها در Rule یا پیام آمدهاند
- تست یا روش تأیید مشخص است
- مرز نوشتن agent محدود شده است
اگر یکی از اینها نیست، ابتدا Context را کامل کنید؛ تولید زودهنگام فقط سرعت بدهی است.
نقش مستندسازی زنده
هرچه دانش فقط در ذهن افراد باشد، مدل و نیروی جدید هر دو کورند. ADR کوتاه، مثال الگوی طلایی در مخزن، و دیاگرام مرز سرویسها سرمایهگذاری Context است. AI میتواند پیشنویس این اسناد را از کد استخراج کند؛ انسان صحت و اولویت را تأیید میکند. بدون این حلقه، هر نشست AI از صفر حدس میزند.
مثال: باگ در سرویس نرخگذاری
توسعهدهنده میگوید «محاسبهٔ تخفیف غلط است». بدون Context، مدل یک فرمول عمومی تخفیف مینویسد. با Context درست: فایل سیاست قیمت، تستهای مشخصه، ADR «تخفیف بعد از مالیات اعمال میشود»، و نمونهٔ سفارش واقعی مصنوعی. حالا پیشنهاد با قاعدهٔ دامنه همخوان میشود. تفاوت خروجی، تفاوت مدل نیست؛ تفاوت زمینه است.
چه وقت Context کمتر هم کافی است؟
اسکریپت یکبارمصرف، آزمایش محلی، و یادگیری مفهوم عمومی. حتی آنجا هم اگر نتیجه قرار است وارد مسیر مشترک شود، Context پروژه را قبل از Merge اضافه کنید. مرز را با مقصد کد مشخص کنید نه با حس راحتی چت.
مدیریت نشستهای بلند و فشردهسازی تصمیم
چتهای طولانی پر از راه غلط و اصلاحیهاند. اگر همان تاریخچه را به نشست بعد بکشید، نویز Context میشود. در پایان کار، سه چیز را فشرده کنید: تصمیم گرفتهشده، فرضهای باقی، و فایلهای لمسشده. این خلاصه را به ADR یا یادداشت PR ببرید و نشست بعد را با همان شروع کنید، نه با کل transcript.
ابزارهایی که حافظهٔ پروژه دارند مفیدند فقط اگر محتوای حافظه curation شود. حافظهٔ غلط پایدار، بدتر از فراموشی است.
امنیت Context: چه چیزی را هرگز به مدل ندهید
کلیدها، توکنها، دادهٔ واقعی مشتری، و جزئیات آسیبپذیری افشانشده نباید وارد پرامپت شوند. برای بازتولید باگ از دادهٔ مصنوعی همشکل استفاده کنید. اگر ابزار cloud است، سیاست شرکت دربارهٔ کد اختصاصی را رعایت کنید. کمبود Context بهانهٔ نشت Secret نیست؛ باید Context ایمن بسازید نه Context کاملِ خطرناک.
اندازهگیری کیفیت Context
قبل از بحث مدل بهتر، بپرسید localization درست بود؟ چند درصد نشستها با فایل اشتباه شروع شد؟ چند بار Rule تیمی نقض شد چون priming نبود؟ این متریکها نشان میدهند مشکل از مدل است یا از مهندسی زمینه. تیمهایی که فقط «قبول پیشنهاد» را میشمارند، علت ریشهای را نمیبینند.
- نرخ شروع با فایل/نماد صحیح
- تعداد دور اصلاح بهخاطر قرارداد فراموششده
- زمان تا اولین Diff قابل Review
- نرخ نقض Rule پس از افزودن priming
هماهنگی چندنفره روی یک مخزن
وقتی چند توسعهدهنده agentهای موازی روی حوزههای همپوشان اجرا کنند، Context محلی هر کدام ناقص است و تداخل قرارداد پیش میآید. نقشهٔ مالکیت ماژول، قفل کوتاه روی ناحیه، و بهروزرسانی مشترک Rule بعد از تغییر قرارداد، اصطکاک را کم میکند. Context تیمی باید از Context فردی جلو بزند.
خلاصه
پروژههای بزرگ به Context بیشتر نیاز دارند چون حقیقت سیستم در مخزن و تاریخچهٔ تصمیمهاست، نه در وزنهای مدل. پنجرهٔ بزرگ جایگزین گزینش نیست. با priming پایدار، بازیابی هدفمند، برش ماژولار، و قفل تأیید، AI مفید میماند. بدون آنها، سرعت تولید فقط سریعتر شما را از مسیر تیم دور میکند.
در عمل، تیمهای موفق Context را مثل وابستگی نرمافزاری نسخه میکنند: تغییر قرارداد نام یا نسخهٔ فریمورک، همان روز در priming منعکس میشود. اگر Rule با واقعیت مخزن فاصله بگیرد، مدل قانون مرده را جدی میگیرد و خروجی شبیه مستند کهنه میشود.
یک تمرین ماهانه: یک باگ واقعی را دوبار حل کنید — یکبار با Context حداقلی و یکبار با بستهٔ کامل priming و بازیابی. تفاوت کیفیت و زمان را ثبت کنید تا سرمایهگذاری روی زمینه برای مدیریت قابل دفاع باشد.
سوالات متداول
آیا مدل با context window یکمیلیونتوکنی همهٔ مخزن را میفهمد؟
خیر بهمعنای عملی. ظرفیت فنی با توجه مفید یکی نیست؛ نویز و هزینه مانع میشوند. گزینش همچنان لازم است.
Rule تیمی را چقدر بلند بنویسیم؟
به اندازهٔ قراردادهایی که اگر نباشند مدل اشتباه تکراری میکند. جزئیات نادر را به ADR و مثال کد بسپارید.
آیا فقط RAG کافی است؟
برای یافتن فایل کمک میکند؛ برای تصمیم معماری و قیود سازمانی به اسناد و تأیید انسانی نیاز دارید.
منابع و مراجع
- Anthropic — Contextual Retrieval in AI Systems: https://www.anthropic.com/engineering/contextual-retrieval
- Martin Fowler — Patterns for Reducing Friction in AI-Assisted Development (Knowledge Priming): https://martinfowler.com/articles/reduce-friction-ai/
- Martin Fowler — How far can we push AI autonomy in code generation?: https://martinfowler.com/articles/pushing-ai-autonomy.html
- Stack Overflow Developer Survey 2025 — AI: https://survey.stackoverflow.co/2025/ai/
- GitHub Blog — The new identity of a developer (Octoverse / AI era): https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.