RAG یا Fine Tuning؟ چارچوب انتخاب
7 دقیقه مطالعه
RAG یا fine-tuning یا prompt؟ چارچوب انتخاب بر اساس نوع مشکل، eval، هزینه و دسترسپذیری با مثال و چکلیست.
سه راه برای وادار کردن LLM به کار شما وجود دارد: prompt engineering (دستور و مثال بهتر)، RAG (دادن دانش هنگام پاسخ) و fine-tuning (آموزش بیشتر مدل). تیمها اغلب با سومی شروع میکنند چون «حرفهایتر» به نظر میرسد. این مقاله چارچوبی برای انتخاب بر پایهٔ نوع مشکل میدهد: کمبود دانش، رفتار و قالب، یا هزینه و تأخیر.
منابع: «Model optimization» از OpenAI، آموزش fine-tuning و distillation در Google ML Crash Course، مقالهٔ Contextual Retrieval از Anthropic و مقالهٔ اصلی RAG، خواندهشده در ۱۹ اکتبر ۲۰۲۶. بهویژه، OpenAI در همان صفحه میگوید پلتفرم fine-tuning خود را جمع میکند و برای کاربران جدید در دسترس نیست؛ پس در دسترسبودن fine-tuning به ارائهدهنده و تاریخ بستگی دارد. جدول تصمیم و ترتیبها توصیهٔ نویسنده است. برای مفاهیم پایه برنامهریزی پروژه نرمافزاری را ببینید.
اول مشکل را نام ببرید
| مشکل | علامت | اولین راه |
|---|---|---|
| مدل دانش ما را ندارد یا کهنه است | پاسخ اشتباه دربارهٔ سند داخلی | RAG یا قراردادن متن در prompt |
| دستور را درست نمیفهمد | قالب یا لحن ناپایدار | prompt روشن + مثال (few-shot) |
| قالب یا سبک ثابت و دقیق میخواهیم و مثال زیاد داریم | prompt طولانی و ناپایدار | fine-tuning (اگر در دسترس است) |
| هزینه یا تأخیر زیاد است | مدل بزرگ برای کار ساده | مدل کوچکتر، کش، یا fine-tuning/distillation |
| کیفیت نامعلوم | «حس میکنیم خوب است» | اول eval |
قبل از همه: eval
OpenAI گردش کار را با نوشتن eval شروع میکند تا خط پایه معلوم شود، سپس prompt، سپس شاید fine-tuning، و بعد اجرای eval روی داده نماینده و تکرار. حتی پیشنهاد میکند evalها را پیش از prompt بنویسید. بدون آن نمیدانید کدام راه واقعاً بهتر شد. همینجا یک قید: ابزار خاص ارائهدهنده ممکن است حذف شود؛ مجموعهٔ نمونهها و معیارها دارایی شماست و به ابزار وابسته نیست.
prompt engineering
OpenAI میگوید ممکن است prompt engineering بهتنهایی برای نتیجهٔ عالی کافی باشد. سه عنصر: زمینهٔ مرتبط، دستور روشن و نمونه خروجی درست (few-shot). Google هم تأکید میکند prompt پارامترهای مدل را تغییر نمیدهد و از توان الگوشناسی همان مدل استفاده میکند. هزینهاش کم است و تغییرش سریع؛ پس همیشه اولین قدم است. محدودیتش پنجرهٔ زمینه است: نمیتوانید هزاران مثال یا کل دانش را در هر درخواست بفرستید.
RAG
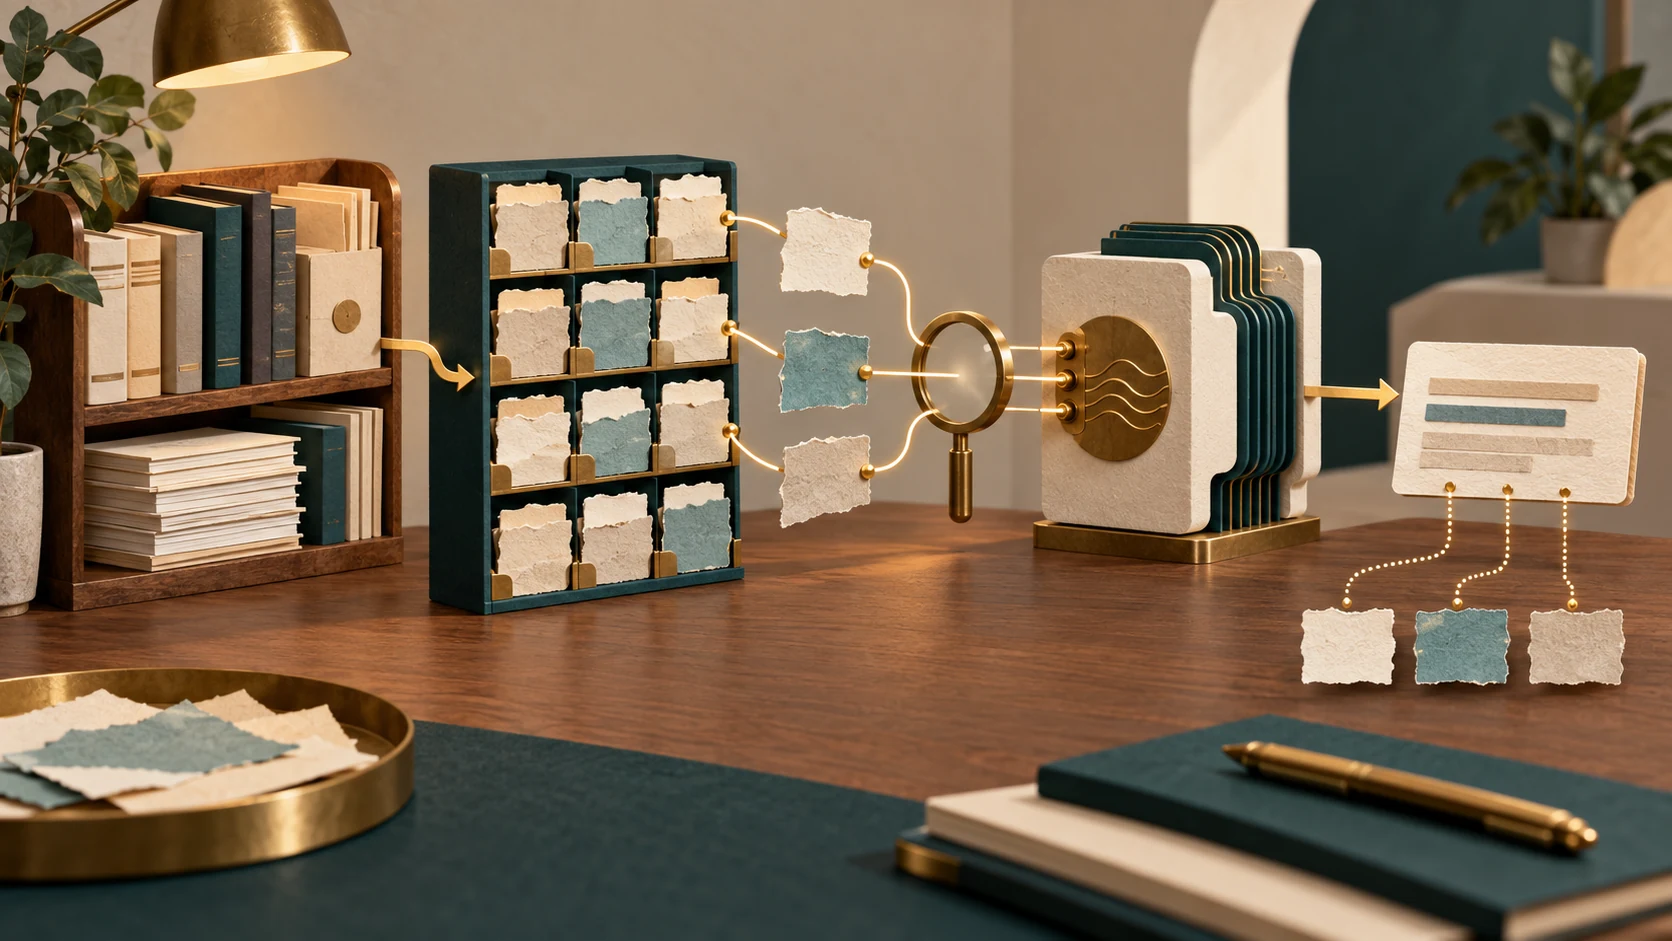
RAG دانش را هنگام پاسخ از پایگاه دانش بازیابی و به prompt اضافه میکند. مقالهٔ اصلی انگیزه را این میداند که مدلها دانش را در پارامتر دارند اما دسترسی دقیق، ارائهٔ منشأ تصمیم و بهروزرسانی دانش مسئله است؛ RAG حافظه بیرونی را اضافه میکند. مزیتهای عملی (تحلیل نویسنده): دانش را بدون آموزش دوباره بهروز میکنید، میتوانید منبع نشان دهید و کنترل دسترسی را در بازیابی اعمال کنید. اما بار مهندسی (ingest، نمایه، ارزیابی) دارد. Anthropic هم میگوید اگر دانش از حدود ۲۰۰ هزار توکن کمتر است میتوان همه را در prompt گذاشت و RAG لازم نیست (عدد مربوط به ۲۰۲۴ است؛ ظرفیت فعلی را از مستندات بخوانید).
fine-tuning
طبق OpenAI، fine-tuning میتواند: قالب ثابت پاسخ بدهد، مثالهای بیشتری از پنجرهٔ زمینه را به مدل بیاموزد، با prompt کوتاهتر هزینه و تأخیر را در مقیاس کم کند، از دادهٔ اختصاصی بدون ارسال در هر درخواست بهره ببرد، و مدل کوچکتر را برای یک کار قوی کند؛ اما فرایندی زمانبر است. Google هم یادآوری میکند fine-tuned model معمولاً بهتر از مدل پایه است ولی تعداد پارامترها همان میماند، fine-tuning کامل گران است و تنظیم پارامتر-کارا زیرمجموعهای از پارامترها را عوض میکند. دو هشدار:
- دانش تازه را با fine-tuning وارد نکنید (توصیهٔ نویسنده): تغییر دانش در RAG ساده است؛ در fine-tuning یعنی آموزش دوباره. منبع رسمی ما این را صریح نگفته؛ بنابراین با eval خودتان بسنجید.
- در دسترسبودن: OpenAI میگوید پلتفرم fine-tuning برای کاربران جدید قابل دسترس نیست و مدلهای fine-tuneشده تا منسوخشدن مدل پایه باقی میمانند. وابستگی به آن ریسک مدیریت نسخه دارد؛ پیش از تصمیم وضعیت روز ارائهدهنده را ببینید.
چارچوب انتخاب
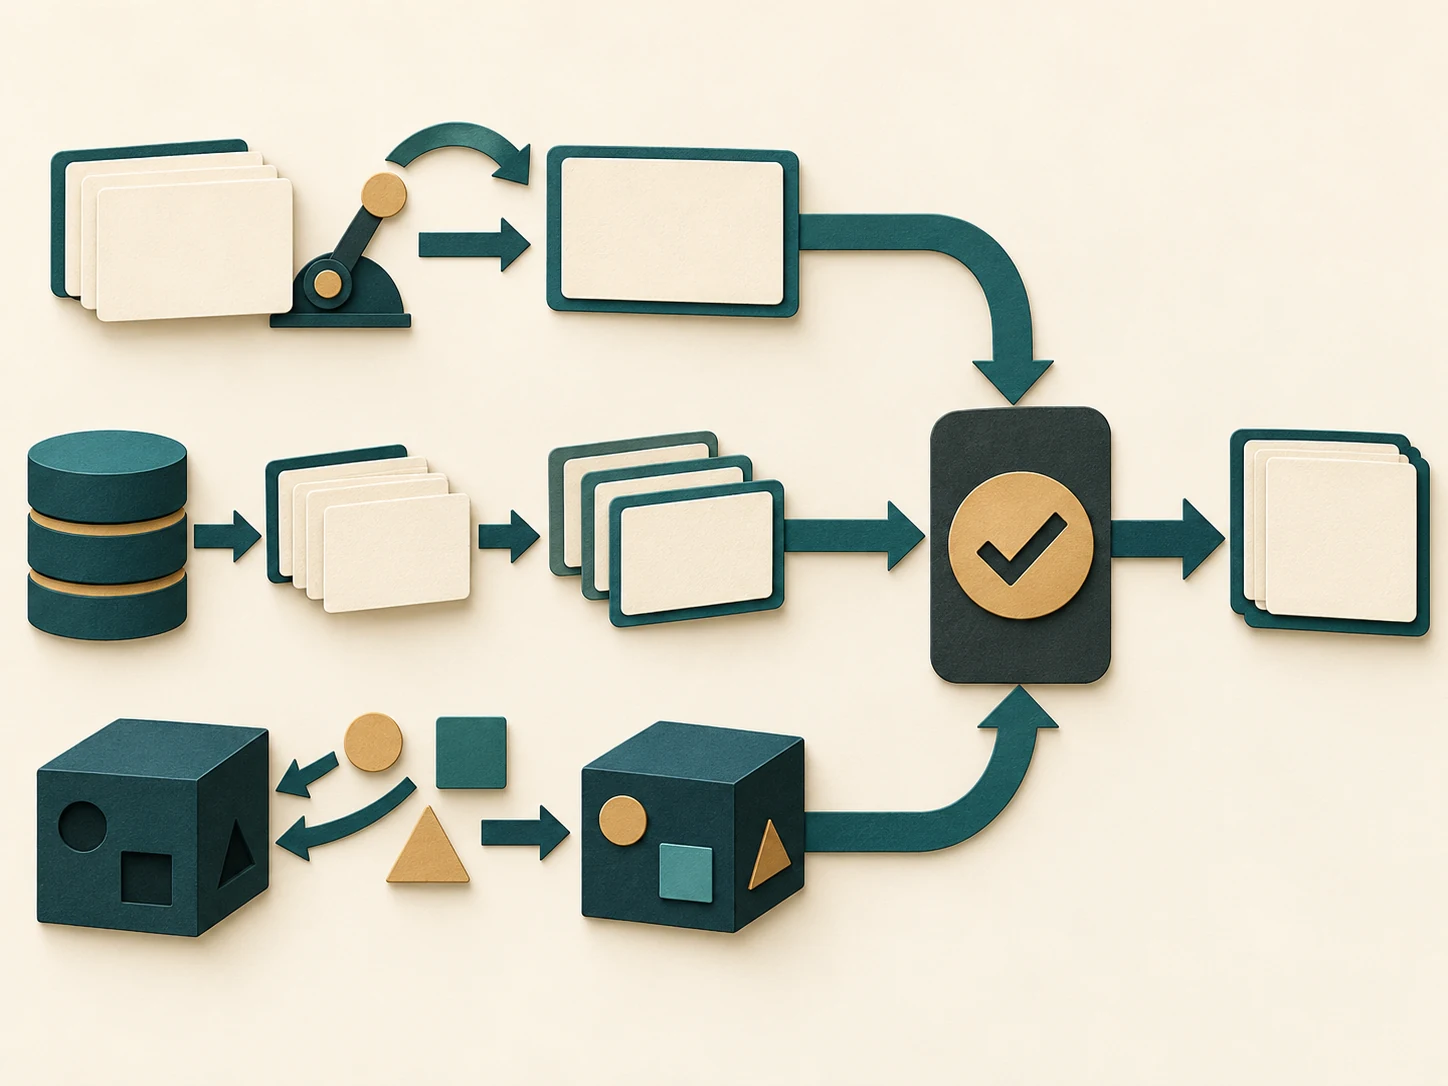
- eval بنویسید و خط پایه را بسنجید.
- prompt را بهبود دهید (دستور، مثال). اگر معیار برآورده شد، تمام.
- اگر خطا از کمبود دانش است: متن مرجع را در prompt بگذارید یا RAG بسازید.
- اگر خطا از رفتار/قالب است و مثال زیاد دارید: fine-tuning را بررسی کنید (در صورت دسترسبودن) یا مدل دیگر.
- اگر هزینه/تأخیر مسئله است: مدل کوچکتر، کش، و سپس تنظیم مدل.
- ترکیبها رایجاند: RAG برای دانش + prompt یا fine-tuning برای قالب. هر ترکیب را با eval بسنجید.
مثال ساختگی
یک شرکت فرضی میخواهد دستیار پشتیبانی بسازد. eval ۵۰ پرسش واقعی نشان میدهد: ۴۰٪ خطاها از ندانستن سیاستهای داخلی است (RAG)، ۳۰٪ از قالب نامنظم پاسخ (prompt و نمونهها یا خروجی ساختاریافته)، ۲۰٪ از ابهام پرسش (پرسش روشنکننده) و ۱۰٪ از مواردی که نیاز به انسان دارد (مسیر انسانی). تصمیم: ابتدا RAG و prompt؛ fine-tuning بهدلیل هزینهٔ نگهداری و ریسک دسترسپذیری فعلاً کنار گذاشته میشود؛ پس از سه ماه با داده واقعی بازبینی میشود. درصدها فرضیاند.
هزینه و نگهداری
- prompt: کمهزینه، سریع، اما در هر درخواست توکن میخورد.
- RAG: مهندسی ingest و نمایه، هزینه embedding و بازیابی، نگهداری تازگی داده.
- fine-tuning: آمادهسازی داده، آموزش، ارزیابی و آموزش دوباره با هر تغییر مدل پایه؛ در دسترسبودن به ارائهدهنده وابسته است. قیمت را از صفحهٔ رسمی تاریخدار بخوانید؛ ما عددی نیاوردهایم.
چطور تصمیم را در طول زمان بازبینی کنیم؟
انتخاب امروز دائمی نیست. OpenAI تأکید میکند رفتار مدلها بین نسخهها تغییر میکند و توسعهدهندگان باید پیوسته عملکرد را بسنجند و تنظیم کنند. پس هر سهماه (بازهٔ فرضی) سه کار انجام دهید: eval را روی نسخهٔ جدید مدل دوباره اجرا کنید؛ بررسی کنید آیا مدل جدیدتر مشکلی را که با ترفند prompt یا fine-tuning حل کرده بودید ذاتاً حل میکند (در این صورت پیچیدگی اضافه را حذف کنید)؛ و خطاهای تازهٔ تولید را دوباره طبقهبندی کنید تا ببینید سهم دانش، رفتار و هزینه عوض شده یا نه. اگر سهم خطاهای دانش بالا رفت، سرمایهگذاری روی RAG و کیفیت داده منطقیتر است؛ اگر قالب و سبک مسئله شد، مثالهای بیشتر یا خروجی ساختاریافته؛ و اگر هزینه، مدل کوچکتر یا کش. این بازبینی دورهای جلوی انباشت پیچیدگیای را میگیرد که دیگر لازم نیست.
اشتباهات رایج
- شروع با fine-tuning بدون eval و بدون امتحان prompt.
- استفاده از fine-tuning برای دانش متغیر.
- ساختن RAG برای دانش کوچک و ثابت.
- مقایسهٔ راهها بدون مجموعهسؤال یکسان.
- قفلشدن روی قابلیتی که ارائهدهنده در حال جمعکردن آن است.
چکلیست
- eval و خط پایه داریم.
- مشکل (دانش، رفتار، هزینه) از روی خطاها طبقهبندی شده است.
- prompt و مثالها بهاندازه کافی آزموده شدهاند.
- برای دانش متغیر RAG یا متن مرجع در نظر گرفته شده است.
- برای fine-tuning، دسترسبودن، داده برچسبخورده و هزینهٔ نگهداری روشن است.
- راهها با همان eval مقایسه شدهاند.
- تاریخ بازبینی تصمیم مشخص است.
برای انتخاب فناوری انتخاب تکنولوژی و برای معیار آمادگی نرمافزار آمادهٔ تولید را ببینید.
منابع و مراجع
- Model optimization — OpenAI API Docs، 2026-10-19.
- LLMs: Fine-tuning, distillation, and prompt engineering — Google for Developers (Machine Learning Crash Course).
- Introducing Contextual Retrieval — Anthropic Engineering، 2024-09-19.
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — Lewis et al., NeurIPS 2020 (arXiv)، 2021-04-12.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.