RAG چیست؟ از سند تا پاسخ مستند
7 دقیقه مطالعه
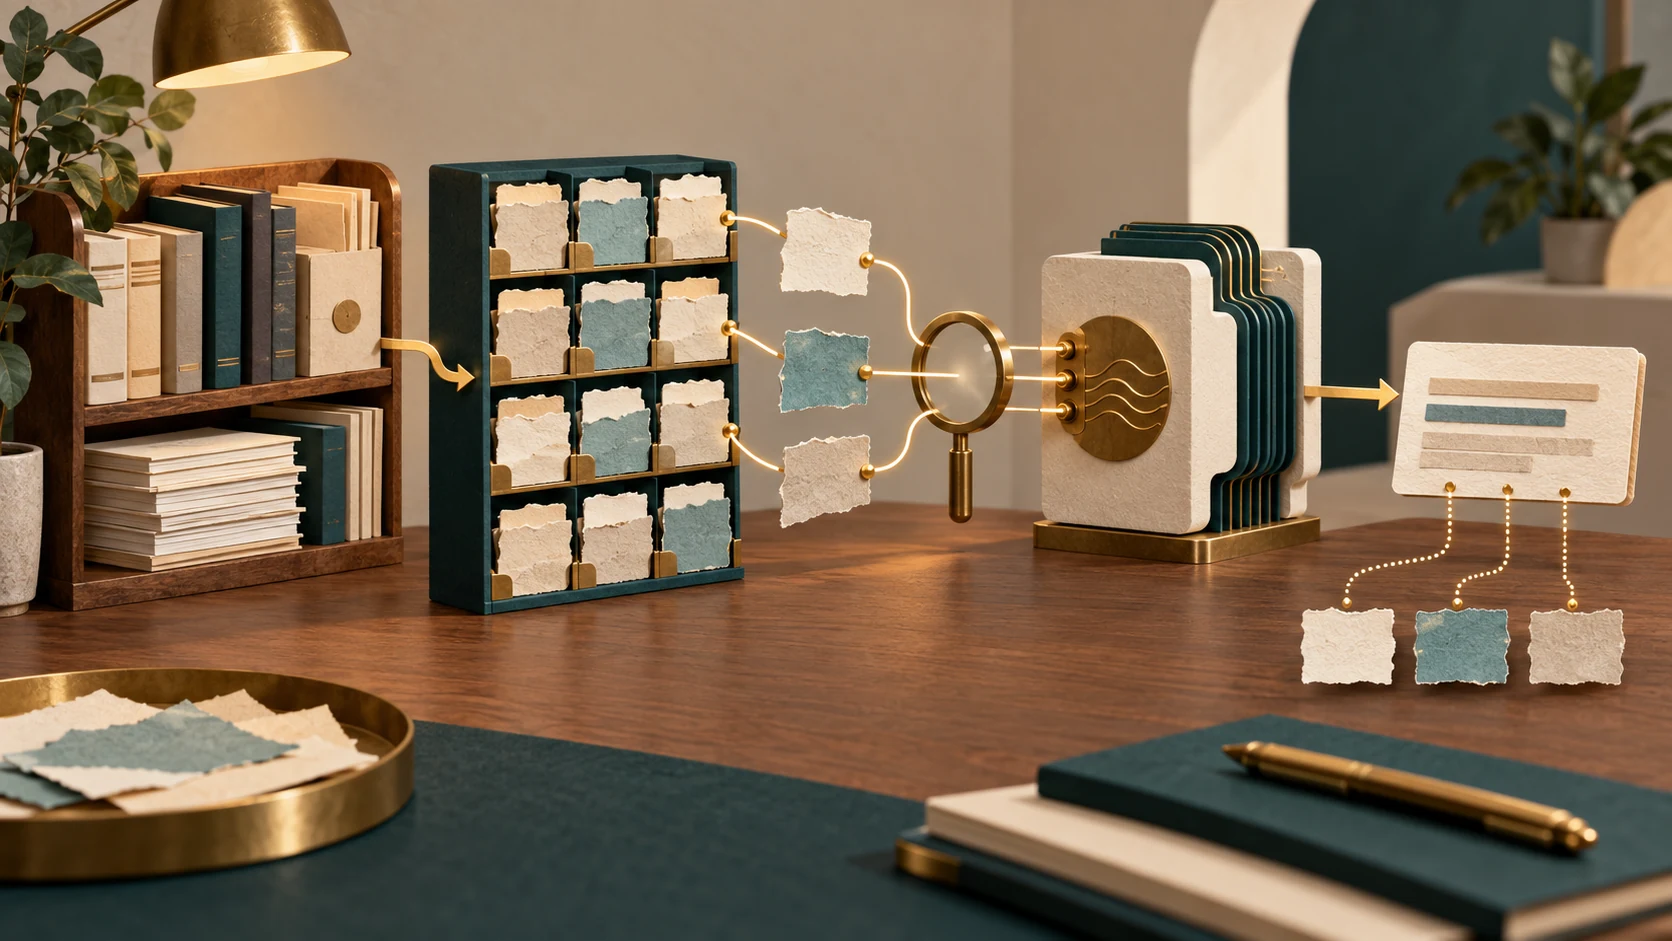
RAG چیست و چگونه کار میکند؟ مسیر ingest، chunk، embedding، بازیابی، ساخت prompt و پاسخ با ارجاع، با مثال و چکلیست.
«RAG» یعنی مدل زبانی پیش از پاسخ، چند تکه متن مرتبط را از دانش شما میگیرد و همراه سؤال میخواند. ایدهٔ سادهای است، اما کیفیتش به هر مرحلهٔ مسیر بستگی دارد: آمادهسازی، قطعهبندی، جستوجو، ساخت prompt و پاسخ. این مقاله مسیر کامل «از سند تا پاسخ مستند» را، با نمودار توصیفی و بر پایهٔ منابع رسمی، شرح میدهد.
منابع: مقالهٔ اصلی RAG (Lewis و همکاران، NeurIPS 2020)، مقالهٔ مهندسی Anthropic دربارهٔ Contextual Retrieval، راهنمای Amazon SageMaker و صفحهٔ Google Cloud؛ همه در ۱۹ اکتبر ۲۰۲۶ خوانده شدند. دقتها و درصدهایی که ذکر میکنیم فقط گزارش خود منبعاند، نه نتیجهٔ آزمون ما. مثالها ساختگیاند. برای فهم ساختار کلی سیستم انتخاب معماری اپلیکیشن وب را هم ببینید.
RAG چه مشکلی را حل میکند؟
مقالهٔ اصلی میگوید مدلهای زبانی دانش را در پارامترهایشان ذخیره میکنند، اما دسترسی دقیق به آن، ارائهٔ منشأ تصمیم و بهروزرسانی دانش هنوز دشوار است. AWS هم یادآوری میکند مدلهای پایه آفلاین آموزش میبینند و از دادههای پس از آموزش بیخبرند. RAG راهحل «حافظهٔ بیرونی» است: دانش شما در یک نمایهٔ قابلجستوجو میماند، بهروز میشود و تکههای مرتبط هنگام پاسخ به مدل داده میشوند. Google Cloud دو مزیت را برجسته میکند: اطلاعات تازه و «پایهگذاری واقعی» خروجی روی اسناد. این پایهگذاری هیچ تضمین ریاضی نیست؛ فقط احتمال خطا را با دادن واقعیتهای درست کم میکند.
مسیر از سند تا پاسخ
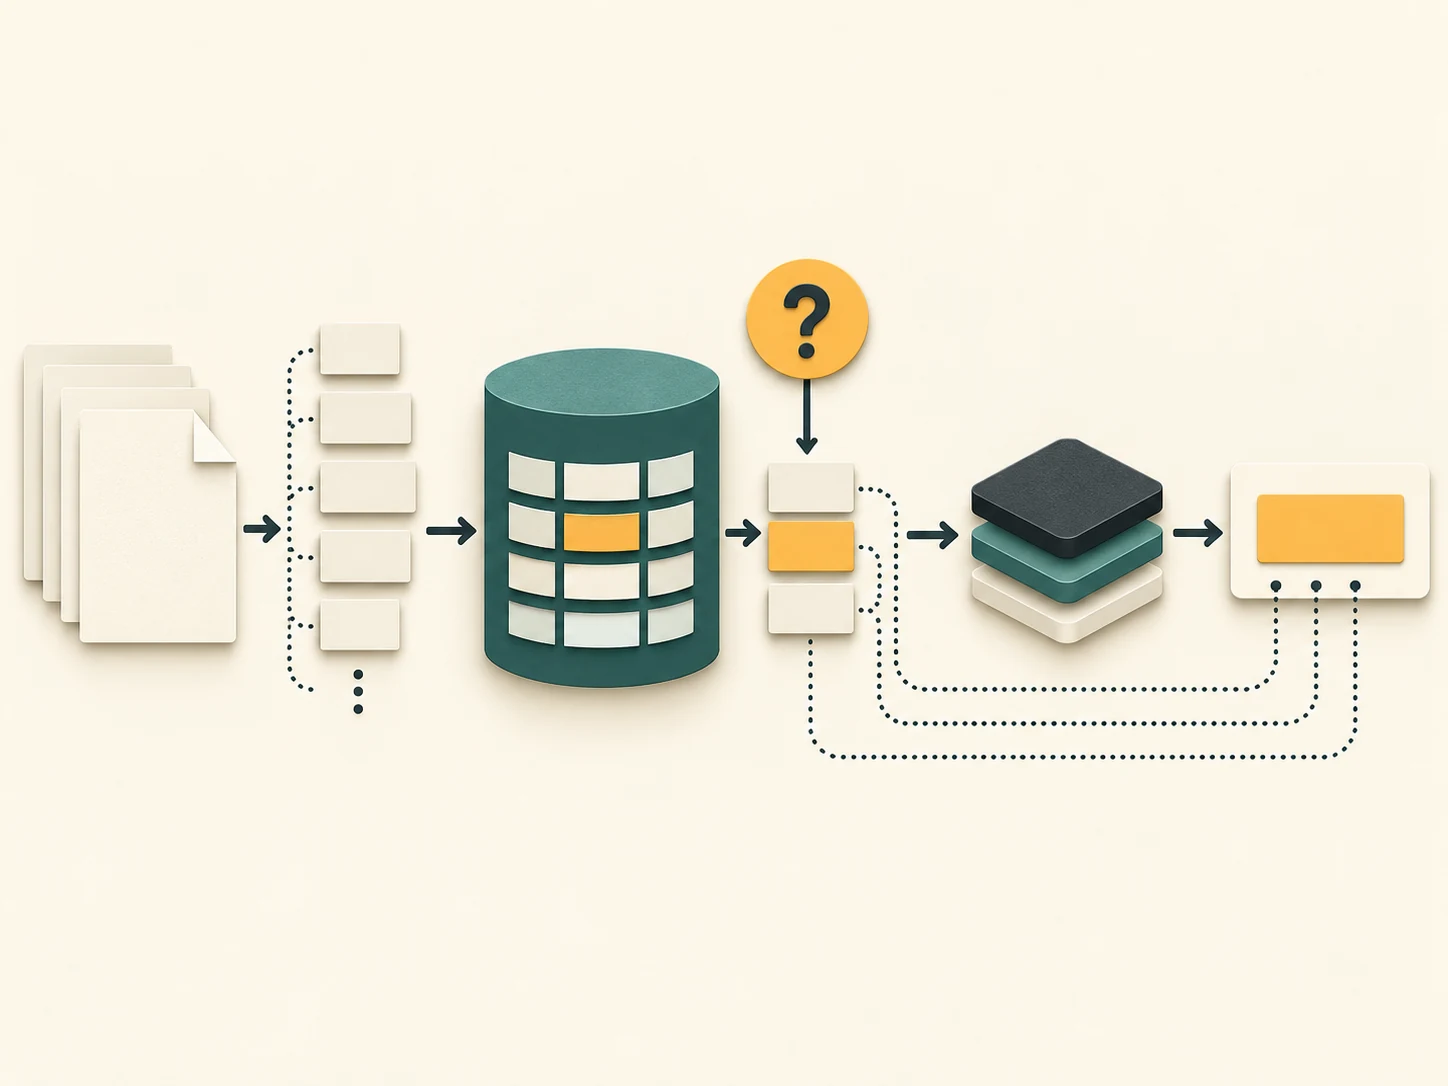
نمودار توصیفی (متنی):
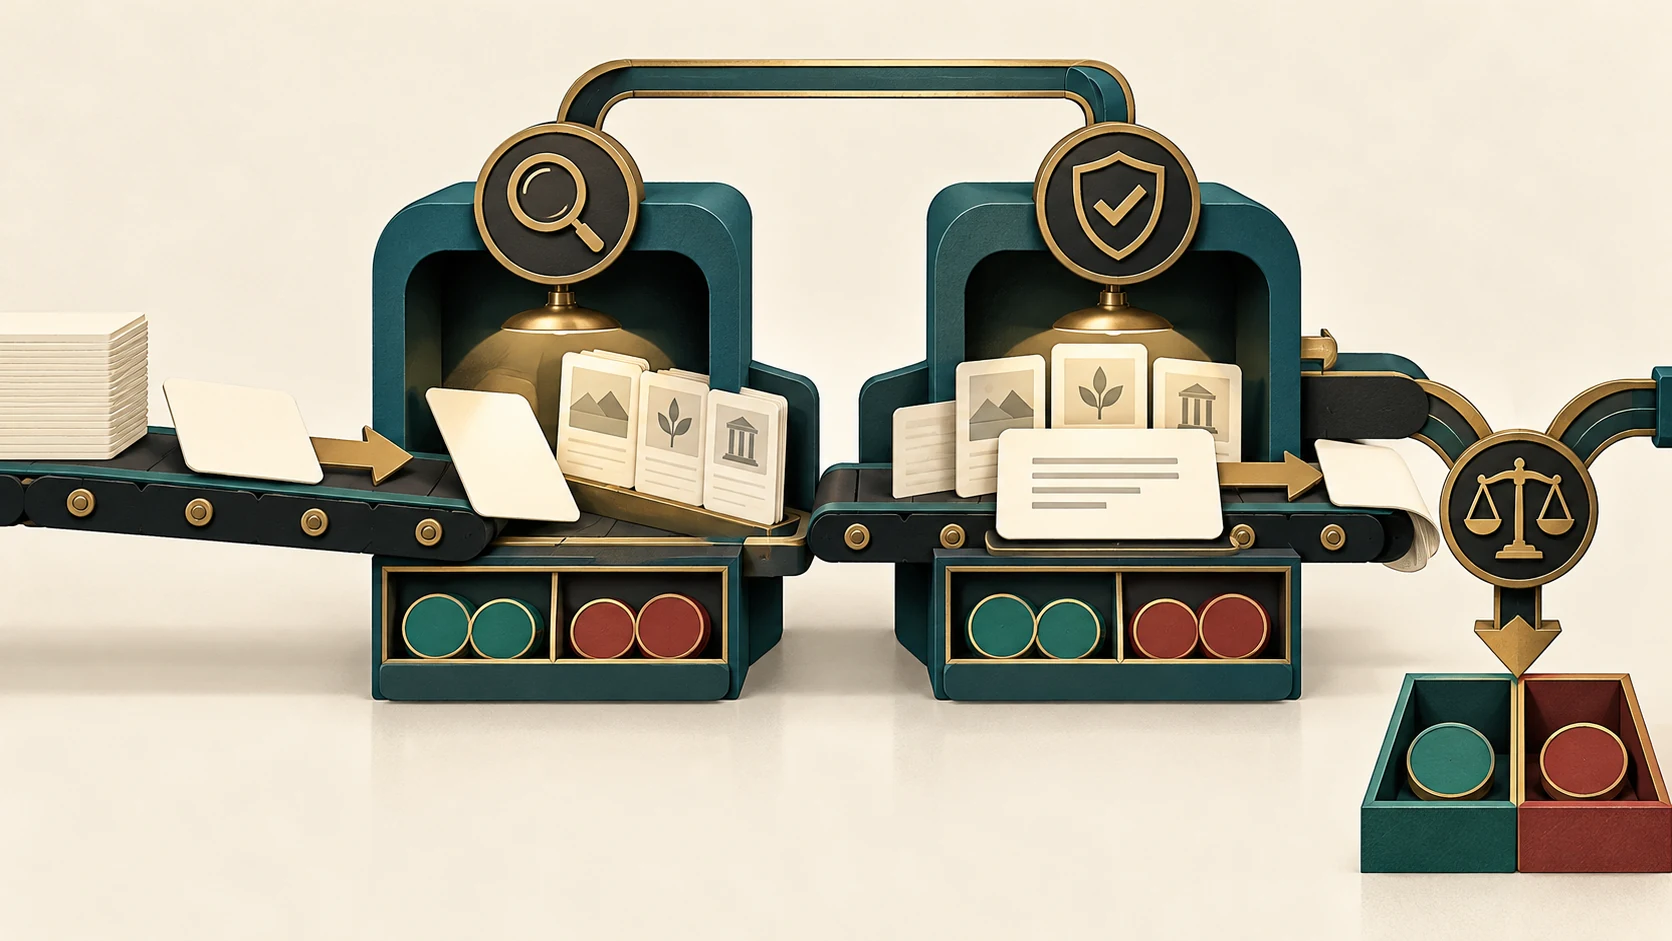
سند → [آمادهسازی و متادیتا] → [قطعهبندی] → [embedding] → [نمایه / پایگاه برداری]
↑
پرسش کاربر → [embedding پرسش] → [بازیابی top-K (+ BM25، rerank)] ┘
↓
[ساخت prompt: دستور + قطعهها + پرسش] → [LLM] → پاسخ + ارجاع به منبع
۱) ورود داده (ingest)
منبع میتواند مخزن سند، پایگاه داده یا API باشد (AWS). پیش از نمایهسازی، متن را تمیز کنید و برای هر سند متادیتا نگه دارید (عنوان، نسخه، تاریخ، مجوز دسترسی). نکتهٔ کلیدی: بدون متادیتا نمیتوانید منبع را نشان دهید یا دسترسی را کنترل کنید.
۲) قطعهبندی (chunk)
Anthropic اندازهٔ قطعه را «معمولاً حداکثر چند صد توکن» توصیف میکند و AWS میگوید قطعه باید برای دادن زمینهٔ مفید بهاندازهٔ کافی بزرگ و برای جاشدن در طول prompt بهاندازهٔ کافی کوچک باشد. عدد دقیق وابسته به سند و مدل است و باید با ارزیابی مشخص شود (توصیهٔ نویسنده).
۳) embedding و نمایه
embedding متن را به بردار عددی تبدیل میکند تا شباهت معنایی قابل مقایسه شود؛ بردارها در یک پایگاه برداری میروند. AWS اشاره میکند میتوان نمایه و embeddingها را ناهمزمان بهروز کرد، پس تازگی دانش مسئلهٔ طراحی پایپلاین است.
۴) بازیابی
پرسش هم embed میشود و نزدیکترین قطعهها برگردانده میشوند. Anthropic هشدار میدهد embedding ممکن است تطبیق دقیق را از دست بدهد: برای پرسش «Error code TS-999» جستوجوی معنایی میتواند مطالب مربوط به کدهای خطا را بیاورد و همان کد را نه. BM25 (تطبیق واژگانی) برای شناسه و اصطلاح فنی خوب است و ترکیب هر دو با rank fusion پیشنهاد شده است. Google Cloud از re-ranker هم نام میبرد.
۵) ساخت prompt و پاسخ
قطعههای برگزیده کنار دستور و پرسش به مدل داده میشوند. دستور باید بگوید فقط بر پایهٔ متن دادهشده پاسخ بدهد، اگر جواب نبود بگوید «نمیدانم» و ارجاع منبع بدهد (توصیهٔ نویسنده). Google Cloud هم تأکید میکند هدف این است که خروجی کاملاً روی همان واقعیتها پایهگذاری شود و در عین حال به پرسش پاسخ دهد.
مشکل زمینهٔ ازدسترفته
Anthropic مثال میزند: قطعهای میگوید «درآمد شرکت ۳٪ نسبت به فصل قبل رشد کرد»؛ بدون نام شرکت و دوره، بازیابی و استفاده دشوار میشود. روش Contextual Retrieval پیش از embedding و ساخت نمایهٔ BM25، توضیح کوتاه زمینه را به هر قطعه میافزاید و طبق گزارش خود Anthropic خطای بازیابی را ۴۹٪ (و همراه با reranking ۶۷٪) کم میکند. این نتیجهٔ ارزیابی داخلی روی مجموعههای خودشان است و تضمینی برای داده شما نیست. مستقل از این روش، اصل ساده این است: هر قطعه باید بدون سند اصلی هم قابلفهم باشد، مثلاً با افزودن عنوان و بخش به متن قطعه (توصیهٔ نویسنده).
چه زمانی لازم نیست؟
Anthropic میگوید اگر پایگاه دانش کمتر از ۲۰۰٬۰۰۰ توکن (حدود ۵۰۰ صفحه) باشد میتوان کل آن را در prompt گذاشت و نیازی به RAG نیست؛ Google Cloud هم پنجرهٔ زمینهٔ بلند را راهحل ممکن میداند و RAG را برای وقتی که حجم بیشتر است یا کاهش توکن، زمان و هزینه میخواهید. این عددها به تاریخ مقاله (۲۰۲۴) تعلق دارند و ظرفیت مدلها تغییر کرده است؛ ظرفیت فعلی را از مستندات روز ارائهدهنده بخوانید. قاعدهٔ عملی (توصیهٔ نویسنده): اگر دانش کم، ثابت و کمتغییر است، ابتدا سادهترین راه (کل متن در prompt یا جستوجوی معمولی) را بسنجید و فقط وقتی حجم، تازگی یا هزینه ناچار میکند به RAG بروید؛ چون هر مرحلهٔ RAG یک نقطهٔ خرابی و نگهداری اضافه است.
کیفیت را از کجا بسنجیم؟
خطای یک سیستم RAG دو منشأ جدا دارد: بازیابی (قطعهٔ درست نیامد) و تولید (قطعهٔ درست آمد ولی پاسخ غلط یا بیارتباط بود). اگر هر دو را با یک عدد «کیفیت کلی» بسنجید نمیدانید کجا را اصلاح کنید. پیشنهاد (نویسنده): فهرستی از پرسشهای واقعی همراه سند درست برای هر پرسش نگه دارید، ابتدا ببینید قطعهٔ درست در نتایج بازیابی هست یا نه، و بعد کیفیت پاسخ را بسنجید. گزارشهای درصدی منابع (مثل کاهش ۴۹٪ Anthropic) فقط نشان میدهد چنین سنجشی ممکن است، نه اینکه روی داده شما همان عدد را خواهید دید.
مثال ساختگی: راهنمای پشتیبانی
- ۱۲۰ سند راهنما در سه نسخه؛ هر کدام با متادیتا (محصول، نسخه، تاریخ).
- هر سند به قطعههای حدود چند صد توکن شکسته میشود و به هر قطعه عنوان بخش اضافه میشود.
- پرسش: «خطای TS-999 در نسخهٔ ۳ چیست؟». BM25 قطعهٔ حاوی TS-999 را میآورد و جستوجوی معنایی قطعههای مرتبط با اتصال را؛ ترکیب هر دو ۵ قطعهٔ نهایی را میسازد.
- prompt: «فقط بر اساس متن زیر پاسخ بده و منبع را بنویس؛ اگر پاسخ نیست بگو نمیدانم».
- پاسخ با لینک سند و نسخه. تیم پشتیبانی بازخورد «مفید/غیرمفید» ثبت میکند.
اشتباهات رایج
- قطعههای خیلی کوچک یا خیلی بزرگ بدون ارزیابی.
- فقط جستوجوی معنایی برای پرسشهایی با شناسه و کد.
- نداشتن متادیتا و ارجاع؛ پاسخ را نمیتوان راستیآزمایی کرد.
- باور اینکه RAG hallucination را صفر میکند.
- نمایهٔ کهنه و نبود فرایند بهروزرسانی.
- نمایش اسناد بدون کنترل دسترسی کاربر.
چکلیست
- منبع دانش، مالک و دورهٔ بهروزرسانی مشخص است.
- هر قطعه متادیتا و زمینه کافی دارد.
- اندازهٔ قطعه با آزمون روی پرسشهای واقعی انتخاب شده است.
- برای شناسه و اصطلاح، تطبیق واژگانی در کنار معنایی بررسی شده است.
- prompt «بدون منبع پاسخ نده» و ارجاع را اجباری میکند.
- کنترل دسترسی در بازیابی اعمال میشود.
- کیفیت بازیابی و پاسخ جدا اندازهگیری میشود.
- پایش خطا و تأخیر برقرار است (پایش سیستم).
اگر بخش بازیابی را پشت یک سرویس میگذارید، API چیست مفاهیم ارتباط را مرور میکند.
منابع و مراجع
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — Lewis et al., NeurIPS 2020 (arXiv)، 2021-04-12.
- Introducing Contextual Retrieval — Anthropic Engineering، 2024-09-19.
- Retrieval Augmented Generation — Amazon SageMaker AI Developer Guide.
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.