خواندن EXPLAIN ANALYZE در PostgreSQL
7 دقیقه مطالعه
چگونه EXPLAIN ANALYZE را در PostgreSQL بخوانیم و query کند را پیدا کنیم: اجرای ایمن، تخمین در برابر واقعی، loops، BUFFERS و روند سنجش؛ بر پایهٔ مستندات نسخهٔ ۱۸.
«این query کند است» جملهٔ مفیدی نیست تا وقتی نگاه کنید پایگاه داده با آن چه میکند. در PostgreSQL ابزار اصلی این کار EXPLAIN و EXPLAIN ANALYZE است. این مقاله روشی قابلتکرار برای خواندن خروجی آن میدهد: چه چیزی را اجرا کنیم، کجا را نگاه کنیم، و چه چیزی را نتیجه نگیریم. همهچیز بر پایهٔ مستندات PostgreSQL نسخهٔ ۱۸ است (خواندهشده ۱۹ اکتبر ۲۰۲۶؛ در همان صفحه اعلام شده PostgreSQL 19 RC 1 منتشر شده ولی نسخهٔ «current» ۱۸ است). نسخهٔ سرور خودتان را بررسی کنید چون قالب خروجی بین نسخهها فرق میکند. ما هیچ عدد «سریع» یا «کند» نمیدهیم؛ عددها فقط در مثال ساختگی اند. برای زمینهٔ معماری انتخاب معماری وباپ و مفهوم API API چیست را هم ببینید.
EXPLAIN در برابر EXPLAIN ANALYZE
طبق مستندات، EXPLAIN طرحی را نشان میدهد که برنامهریز برای query انتخاب کرده، بدون اجرای آن. EXPLAIN ANALYZE query را واقعاً اجرا میکند و زمان و تعداد ردیف واقعی را کنار تخمینها میگذارد. نکتهٔ ایمنی مهم: چون اجرا واقعی است، اگر query تغییردهنده باشد (INSERT، UPDATE، DELETE) تغییرها اتفاق میافتد. مستندات راهش را نشان میدهد: دستور را داخل BEGIN اجرا کنید و بعد ROLLBACK بزنید. با این حال، روی محیط تولید یا query سنگین احتیاط کنید، چون خود اجرا هزینه و قفل دارد؛ بهتر است روی نسخهٔ کپی یا staging با دادهٔ هماندازه بررسی کنید.
BEGIN;
EXPLAIN (ANALYZE, BUFFERS)
UPDATE orders SET status = 'archived' WHERE created_at < '2025-01-01';
ROLLBACK;
نام جدول و ستونها ساختگیاند. گزینهٔ BUFFERS اطلاعات I/O را اضافه میکند و بر پایهٔ مستندات، ANALYZE آن را ضمناً فعال میکند (در نسخهٔ ۱۸)؛ اگر نمیخواهید میتوانید BUFFERS OFF بدهید.
قدم صفر: مثال قابلبازتولید
- query دقیق را با پارامتر واقعی (نه تقریبی) ذخیره کنید.
- نسخهٔ PostgreSQL و تنظیمات مرتبط را یادداشت کنید.
- اندازهٔ جدولها و توزیع داده را شبیه تولید کنید؛ طرح روی جدول ۱۰۰ ردیفی با جدول میلیونی فرق میکند.
- آمار را تازه کنید (
ANALYZE) تا برنامهریز بر دادهٔ جاری تصمیم بگیرد؛ مستندات یادآوری میکند آمار از نمونهٔ تصادفی است و تخمین ردیف با هر ANALYZE ممکن است کمی عوض شود. - چند بار اجرا کنید؛ اجرای اول ممکن است cache سرد داشته باشد.
چه چیزی را بخوانیم؟
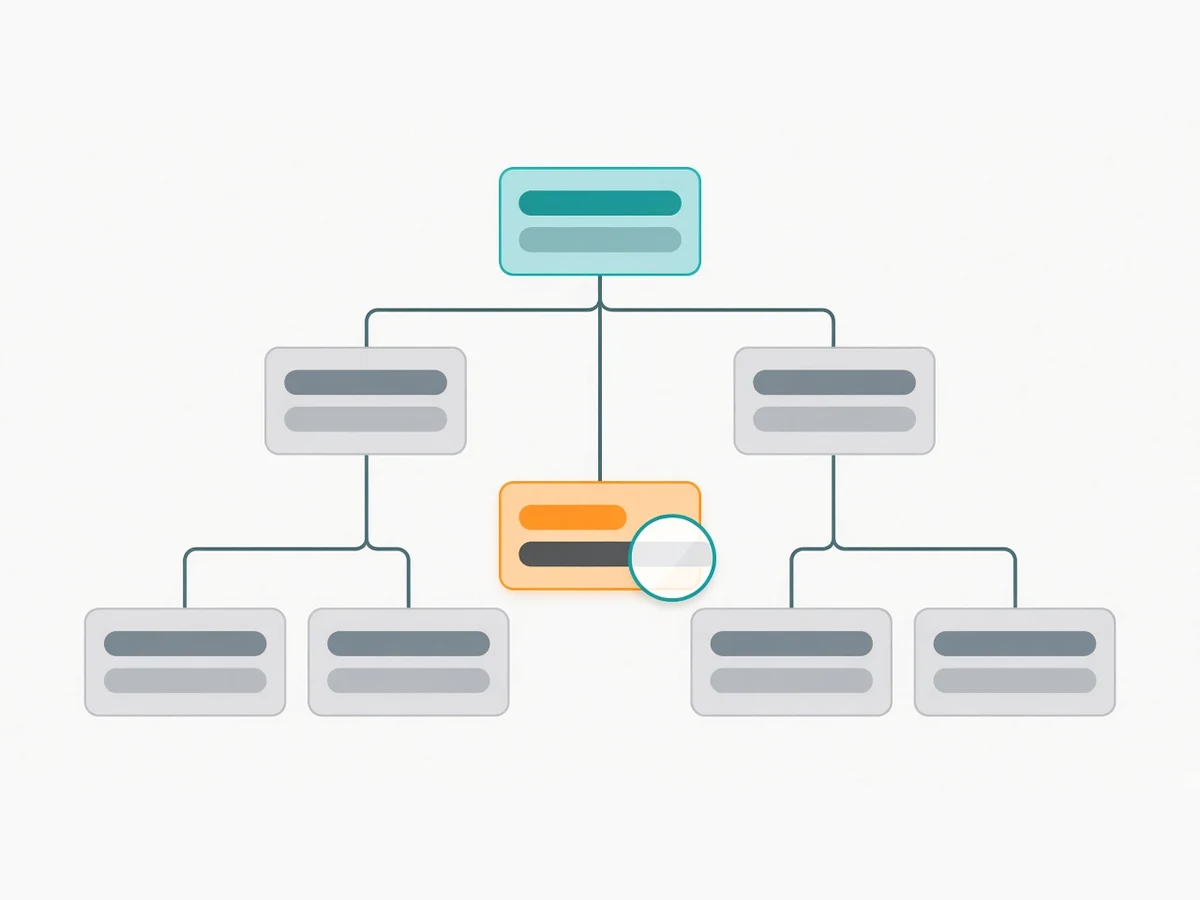
مستندات میگوید مهمترین چیزی که معمولاً باید دید این است که تعداد ردیف تخمینی به واقعی نزدیک باشد. اگر برنامهریز فکر کند ۱۰ ردیف برمیگردد و واقعاً صدهزار ردیف باشد، طرح انتخابشده (مثلاً nested loop) برای واقعیت مناسب نیست. چند نکتهٔ خواندن:
- cost در برابر actual time: هزینه واحد قراردادی است و با زمان واقعی (میلیثانیه) قابلمقایسهٔ مستقیم نیست.
- loops: اگر یک گره چند بار اجرا شود، زمان و ردیف نمایشدادهشده میانگین هر اجراست؛ برای زمان کل در loops ضرب کنید. این خطای رایج در خواندن nested loop است.
- rows در برابر actual rows: اختلاف زیاد یعنی آمار، همبستگی ستونها یا شرط پیچیده برنامهریز را گمراه کرده است.
- Buffers: تعداد بافرهای hit و read نشان میدهد گره چقدر I/O کرده است.
- Planning Time و Execution Time: هر دو گزارش میشوند؛ برای query بسیار کوتاه، برنامهریزی هم سهم دارد.
گرههای رایج
| گره | یعنی | چه سؤالی بپرسیم |
|---|---|---|
| Seq Scan | خواندن ترتیبی کل جدول | آیا شرط انتخابگر است و index مناسب نبود، یا خواندن بیشتر جدول واقعاً لازم است؟ |
| Index Scan / Bitmap Heap Scan | استفاده از index برای یافتن ردیفها | آیا تعداد ردیف تخمینی واقعی است؟ |
| Nested Loop | برای هر ردیف بیرونی، یک جستجوی درونی | loops چند است؟ |
| Hash Join / Merge Join | راهبردهای دیگر join | آیا تخمین ردیف دو طرف درست است؟ |
| Sort | مرتبسازی | آیا index میتواند ترتیب را بدهد؟ |
«Seq Scan بد است» درست نیست؛ اگر بخش بزرگی از جدول لازم است، خواندن ترتیبی ممکن است بهترین گزینه باشد. مستندات هم میگوید در شرایط معین برنامهریز طرحی را انتخاب میکند که ارزانتر میداند و پرچمهای enable_* بیشتر فقط یک گره را «دلسرد» میکنند، نه ممنوع. از آنها فقط برای آزمایش و تشخیص استفاده کنید، نه بهعنوان راهحل دائمی.
روند عملی
- ابتدا
EXPLAINساده بگیرید و شکل کلی را ببینید. - با
EXPLAIN (ANALYZE, BUFFERS)در محیط مناسب زمان واقعی را بسنجید. - گرهای را پیدا کنید که بیشترین زمان کل (با ضرب loops) یا بیشترین خطای تخمین را دارد.
- یک فرضیه بسازید: index ندارد؟ آمار کهنه است؟ شرط sargable نیست؟ join زیاد ردیف تولید میکند؟
- یک تغییر کوچک اعمال کنید (index، بازنویسی query، ANALYZE) و دوباره بسنجید.
- نتیجه را با طرح قبل و بعد ثبت کنید.
مثال ساختگی
فرض کنید گزارش «سفارشهای ۳۰ روز اخیر یک مشتری» کند است. EXPLAIN ANALYZE یک Seq Scan روی جدول سفارشها نشان میدهد که بیشتر ردیفها را حذف میکند و تخمین ردیف با واقعی فاصلهٔ زیادی دارد. فرضیه: index روی ستون مشتری و تاریخ نیست. یک index مرکب در محیط staging ساخته میشود، سپس طرح به Index Scan عوض میشود و خواندن بافر کمتر میشود. اما تیم قبل از انتشار میسنجد که این index روی نوشتن چه میکند، چون هر index هزینهٔ نوشتن و فضا دارد. اعداد ساختگیاند و شما باید بر دادهٔ خود بسنجید.
دامها
- اجرای EXPLAIN ANALYZE روی UPDATE یا DELETE بدون BEGIN و ROLLBACK.
- مقایسهٔ cost با زمان واقعی.
- فراموشکردن loops در nested loop.
- سنجش روی دادهٔ بسیار کوچک و تعمیم به تولید.
- افزودن index بدون سنجش اثر آن بر نوشتن و حافظه.
- تکیه بر یک اجرای تکی (cache سرد یا گرم).
- استفاده از پرچمهای enable_* بهعنوان راهحل دائمی.
چه چیزی در گزارش بهینهسازی ثبت کنیم؟
نتیجهٔ بهینهسازی اگر ثبت نشود، چند ماه بعد دوباره از صفر بررسی میشود. یک قالب کوتاه کافی است: query و پارامترهای آزمون، نسخهٔ PostgreSQL، اندازهٔ تقریبی جدولها، طرح قبل، فرضیه، تغییر، طرح بعد، و هزینههایی که تغییر دارد (مثلاً index جدید و اثر آن بر نوشتن). همچنین بنویسید چه چیزی را نسنجیدید؛ مثلاً «روی دادهٔ تولید نسنجیدهایم» یا «با یک مقدار پارامتر آزمایش شد». این صداقت از اطمینان کاذب جلوگیری میکند.
یادتان باشد که یک query ممکن است با پارامترهای مختلف طرحهای متفاوتی بگیرد. مشتریای با ردیفهای بسیار کم و مشتریای با ردیفهای بسیار زیاد ممکن است هر کدام طرح مناسب خودش را بخواهند. پس حداقل یک پارامتر «معمولی» و یک پارامتر «بدترین حالت» را آزمایش کنید و هر دو را در گزارش بیاورید.
بعد از تغییر: پایش بهجای یکبار سنجش
سنجش یکباره کافی نیست. داده رشد میکند و توزیع آن عوض میشود؛ طرحی که امروز خوب است ممکن است ماه بعد تغییر کند. پس بعد از اعمال تغییر، زمان اجرای همان query را در پایش (مثلاً در لاگ query کند یا ابزار پایش پایگاه داده) دنبال کنید و برای تغییر ناگهانی هشدار بگذارید. اگر طرح تغییر کرد، همین روش EXPLAIN ANALYZE را دوباره تکرار کنید. این رویکرد با ایدهٔ پایش عمومی سیستم هم سازگار است و بدون ادعای عدد خاص، از بازگشت مشکل جلوگیری میکند.
چکلیست
- query و پارامتر واقعی و نسخهٔ PostgreSQL ثبت شده است.
- آمار جاری و دادهٔ هممقیاس داریم.
- EXPLAIN ANALYZE تغییردهنده در تراکنش با rollback اجرا شده است.
- تخمین ردیف با واقعی مقایسه شده و loops اعمال شده است.
- یک تغییر در هر مرحله اعمال و اثرش سنجیده شده است.
- هزینهٔ نوشتن و فضای index بررسی شده است.
- طرح قبل و بعد ثبت شده است.
منابع و مراجع
- 14.1. Using EXPLAIN (PostgreSQL 18) — PostgreSQL Documentation 18، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.