SQL یا NoSQL: انتخاب بر اساس workload، query و سازگاری
7 دقیقه مطالعه
SQL یا NoSQL برای پروژه؟ چارچوب تصمیم بر اساس شکل داده، query و consistency با نمونههای مستند PostgreSQL و MongoDB، جدول تصمیم و فرایند prototype.
«SQL یا NoSQL؟» اغلب بهصورت جنگ سلیقهها مطرح میشود، در حالی که پرسش درست این است: دادههای ما چه شکلی دارند، چه query هایی میزنیم و چه سازگاریای لازم داریم؟ این مقاله یک چارچوب تصمیم از روی workload، query و consistency میدهد و هیچ برندهای از پیش اعلام نمیکند. «NoSQL» یک عنوان چتری برای دستههای متفاوتی است (سند، کلید-مقدار، ستونی، گراف)؛ برای مستندات از دو نمونهٔ مشخص استفاده میکنیم: PostgreSQL 18 بهعنوان یک پایگاه رابطهای و MongoDB بهعنوان یک پایگاه سندی (خواندهشده ۱۹ اکتبر ۲۰۲۶). تعمیم به همهٔ محصولات هر دسته درست نیست. برای زمینه انتخاب معماری وباپ و API چیست را ببینید.
سه پرسش اصلی
- شکل داده و روابط: آیا موجودیتها روابط زیاد و متقابل دارند (سفارش، مشتری، محصول، پرداخت) یا هر «سند» مستقل و خودبسنده است؟
- الگوی query: آیا باید روی هر ترکیبی از فیلدها فیلتر، join و تجمیع کرد (گزارشگیری آزاد)، یا بیشتر «سند را با کلیدش بخوان و بنویس»؟
- سازگاری و تراکنش: آیا چند رکورد باید همزمان و اتمیک تغییر کنند (انتقال موجودی)، و اگر نه، چه مقدار ناسازگاری موقت قابلتحمل است؟
رویکرد رابطهای: نقاط قوت
در پایگاه رابطهای مثل PostgreSQL، ساختار با ستونها، کلیدهای خارجی و قیدها تعریف میشود، و join و تجمیع روی فیلدهای مختلف ابزار اصلیاند. تراکنشها اتمیکاند و سطوح isolation مستندی دارند (مقالهٔ مربوط به isolation در همین مجموعه). به این ترتیب وقتی داده روابط زیاد دارد و قیدها مهماند (مثلاً «هر سفارش باید به مشتری موجود اشاره کند»)، پایگاه داده خودش قواعد را اعمال میکند. هزینه: تغییر ساختار نیازمند مهاجرت است (مقالهٔ expand-and-contract) و دادهٔ بسیار متغیر ممکن است در ستونهای رابطهای نگنجد، هرچند PostgreSQL خودش نوع jsonb را دارد (مقالهٔ JSONB یا جدول SQL). یعنی مرز «SQL یا NoSQL» در عمل کمی مبهم است: پایگاه رابطهای میتواند بخشی از داده را سندی نگه دارد.
رویکرد سندی: نقاط قوت
مستندات MongoDB میگوید مدل داده انعطافپذیر است: اسناد یک collection لازم نیست فیلدهای یکسان داشته باشند، و میتوان طرح داده را بهصورت تدریجی بهبود داد و schema validation را فقط برای بخشهایی که کنترل سختتر میخواهند افزود. روابط یکبهیک، یکبهچند و چندبهچند با اسناد تو در تو، آرایهها و ارجاع بین اسناد مدل میشوند. این وقتی مناسب است که هر سند یک واحد طبیعی باشد (مثلاً محصول با ویژگیهای متغیر، یا پروفایل کاربر) و بیشتر خواندن و نوشتن در سطح همان سند باشد. هزینه: روابط چندبهچند و گزارشگیری روی ترکیبهای آزاد معمولاً به طراحی ماهرانهتر و ابزارهای دیگر نیاز دارد، و سازگاری بین اسناد مختلف با تراکنش حل میشود که طبق مستندات هزینه دارد.
تراکنشها در دنیای سندی
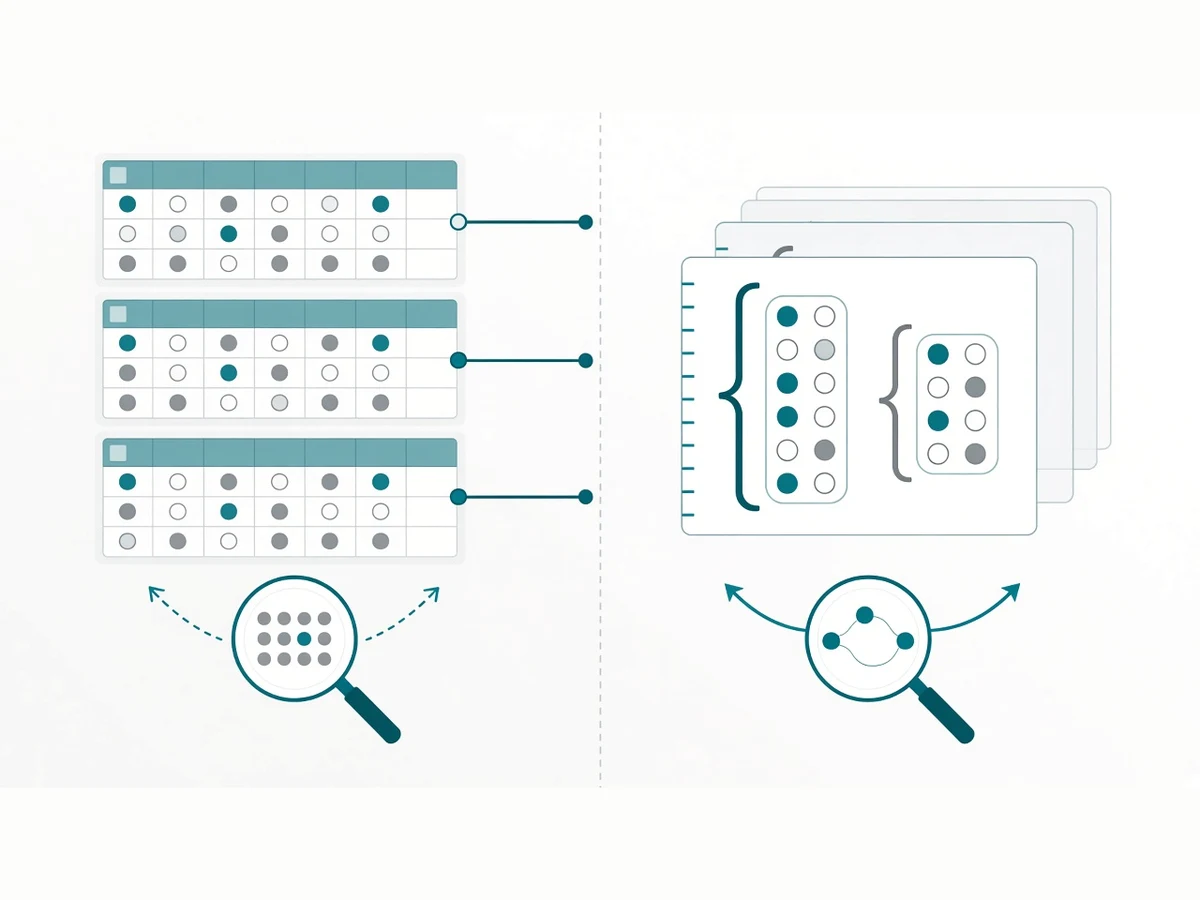
مستندات تراکنش MongoDB میگوید تراکنشها میتوانند چند عملیات، collection، پایگاه داده، سند و shard را پوشش دهند. اما تأکید میکند در بیشتر موارد، تراکنش توزیعشده هزینهٔ عملکردی بیشتری از نوشتن تکسندی دارد و نباید جایگزین طراحی مؤثر طرح داده باشد؛ برای بسیاری از سناریوها مدل denormalized (اسناد تو در تو و آرایهها) همچنان بهینه است و نیاز به تراکنش توزیعشده را به حداقل میرساند. یعنی «NoSQL تراکنش ندارد» ادعای کهنهای است، ولی «پس مثل SQL با آن کار کنیم» هم توصیهٔ خود مستندات نیست؛ طراحی طرح داده باید با تراکنشهای لازم سازگار باشد.
جدول تصمیم
| ویژگی workload | میل به رابطهای | میل به سندی |
|---|---|---|
| روابط متقابل زیاد | بله | نه (یا با طراحی ماهرانه) |
| گزارشگیری آزاد و join | بله | کمتر |
| قیدهای درستبودن داده در خود دیتابیس | بله | با validation محدودتر |
| سندهای مستقل با ساختار متغیر | با jsonb ممکن | بله |
| تغییر مکرر طرح داده در مراحل اولیهٔ محصول | با مهاجرت | بله، با ملاحظهٔ تدریجی |
| تراکنش چندرکوردی مکرر | بله | با هزینه و طراحی |
این جدول جمعبندی نویسنده است، نه معیار رسمی هیچ کدام از مستندات. «میل» یعنی گرایش، نه الزام؛ تیم، ابزار، هزینهٔ عملیات و مهارت هم عاملاند.
فرایند تصمیم
- موجودیتها و روابط اصلی را روی کاغذ بکشید.
- ۱۰ query یا عملیات مهم را بنویسید (خواندن و نوشتن) و تعیین کنید هر کدام چند موجودیت را لمس میکند.
- عملیات نیازمند اتمیکبودن چندرکوردی را مشخص کنید.
- مدل را یک بار با رویکرد رابطهای و یک بار با رویکرد سندی روی کاغذ طراحی کنید و ببینید کدام query ها ساده یا سخت میشوند.
- مهارت تیم، ابزارهای عملیاتی (بکاپ، پایش، مهاجرت) و هزینهٔ میزبانی را وارد کنید.
- یک نمونهٔ آزمایشی (prototype) از دشوارترین query و دشوارترین تراکنش بسازید و روی حجم نمونهٔ واقعی بسنجید.
- تصمیم را با دلیل و شرط بازبینی ثبت کنید.
مثال ساختگی: فروشگاه آنلاین
فروشگاه فرضی ما مشتری، محصول، سفارش، پرداخت و موجودی دارد. سفارش باید به مشتری و محصول اشاره کند، پرداخت و موجودی باید با سفارش هماهنگ تغییر کنند و تیم مالی گزارشهای آزاد میخواهد. اینها نشانهٔ تمایل به پایگاه رابطهای هستند. در همان فروشگاه، ویژگیهای متغیر محصول (رنگ، ظرفیت، ابعاد) کاندید ستون jsonb هستند، نه یک پایگاه جدا. اگر بعداً بخش «پیشنهاد محصول» با ساختار کاملاً متفاوت و بار خواندن زیاد اضافه شود، میتوان استفاده از یک ذخیرهساز مناسبتر را برای همان بخش سنجید؛ اما هر پایگاه داده اضافه، بکاپ، پایش، مهارت و هماهنگی داده بین سیستمها (مقالهٔ همگامسازی) را هم اضافه میکند.
اشتباهات رایج
- انتخاب بر اساس مد یا تجربهٔ قبلی بدون بررسی query ها.
- فرض اینکه «بدون schema» یعنی «بدون طراحی»؛ مستندات MongoDB هم طراحی طرح داده پیش از مقیاس تولیدی را توصیه میکند.
- تکیه بر تراکنش توزیعشده بهجای طراحی مناسب سند.
- افزودن پایگاه دوم برای مشکلی که با jsonb یا index حل میشود.
- نادیدهگرفتن هزینهٔ عملیات (بکاپ، پایش، مهاجرت) برای هر پایگاه داده.
- تصمیم بدون prototype روی دشوارترین query.
تصمیم برگشتپذیر؟ هزینهٔ تغییر بعدی
هیچ انتخابی نهایی نیست، ولی هزینهٔ تغییر آن متفاوت است. جابهجایی بین دو نوع پایگاه داده معمولاً شامل بازنویسی لایهٔ دسترسی به داده، انتقال داده، آزمون مجدد و دورهٔ اجرای موازی است. برای کاهش این هزینه، لایهٔ دسترسی به داده را از منطق کسبوکار جدا نگه دارید و قراردادهای داده (مثلاً قالب API) را مستقل از ذخیرهساز تعریف کنید. این کار اجازه میدهد بعداً یک بخش مشخص را به ذخیرهساز دیگر منتقل کنید بدون اینکه کل سیستم بازنویسی شود.
همچنین از «چندپایگاهی» زودهنگام پرهیز کنید. هر ذخیرهساز اضافه یعنی بکاپ، پایش، مدیریت دسترسی، بهروزرسانی امنیتی، مهارت جدید و مشکل همگامسازی داده. اگر یک پایگاه داده نیازهای امروز را با هزینهٔ معقول پوشش میدهد، ادامه با آن و ثبت شرط بازبینی (مثلاً «اگر query خاصی از آستانهٔ مشخصی کندتر شد، یا اگر نیاز جدیدی پیدا شد») معمولاً سادهترین مسیر است. این ارزیابی نویسنده است و جایگزین prototype و سنجش روی دادهٔ شما نیست.
چکلیست
- موجودیتها، روابط و ۱۰ query مهم نوشته شدهاند.
- عملیات نیازمند تراکنش چندرکوردی مشخص است.
- مدل در هر دو رویکرد روی کاغذ طراحی و مقایسه شده است.
- prototype روی دشوارترین سناریو و حجم واقعی انجام شده است.
- هزینهٔ عملیات و مهارت تیم در نظر گرفته شده است.
- تصمیم و شرط بازبینی ثبت شده است.
منابع و مراجع
- 13.2. Transaction Isolation (PostgreSQL 18) — PostgreSQL Documentation 18، 2026-10-19.
- 8.14. JSON Types (PostgreSQL 18) — PostgreSQL Documentation 18، 2026-10-19.
- Data Modeling in MongoDB — MongoDB Docs، 2026-10-19.
- Transactions (MongoDB) — MongoDB Docs، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.