استقرار بدون قطعی سایت: blue-green و rolling
7 دقیقه مطالعه
راهنمای استقرار بدون downtime: مقایسهٔ blue-green و rolling، health check، مهاجرت دیتابیس با الگوی expand/contract، rollback و مدیریت نشست.
استقرار نسخهٔ جدید با «سرویس را متوقف کن، فایلها را جایگزین کن، دوباره راه بینداز» چند ثانیه تا چند دقیقه قطعی دارد. برای سایتهایی که این قطعی قابلقبول نیست، دو الگوی رایج وجود دارد: blue-green و rolling. این مقاله این دو را بر پایهٔ توضیح Martin Fowler دربارهٔ blue-green، الگوی parallel change برای تغییر schema و مستندات Kubernetes برای rolling update و readiness probe (خواندهشده ۱۹ اکتبر ۲۰۲۶) مقایسه میکند و سه شرط عملی را توضیح میدهد: health check، مهاجرت دیتابیس و rollback. «بدون downtime» تضمین نیست؛ هر الگو حالتهایی دارد که در آن بخشی از کاربران خطا میبینند. برای زمینه برنامهریزی پروژه نرمافزاری و انتخاب معماری وباپ را ببینید.
blue-green
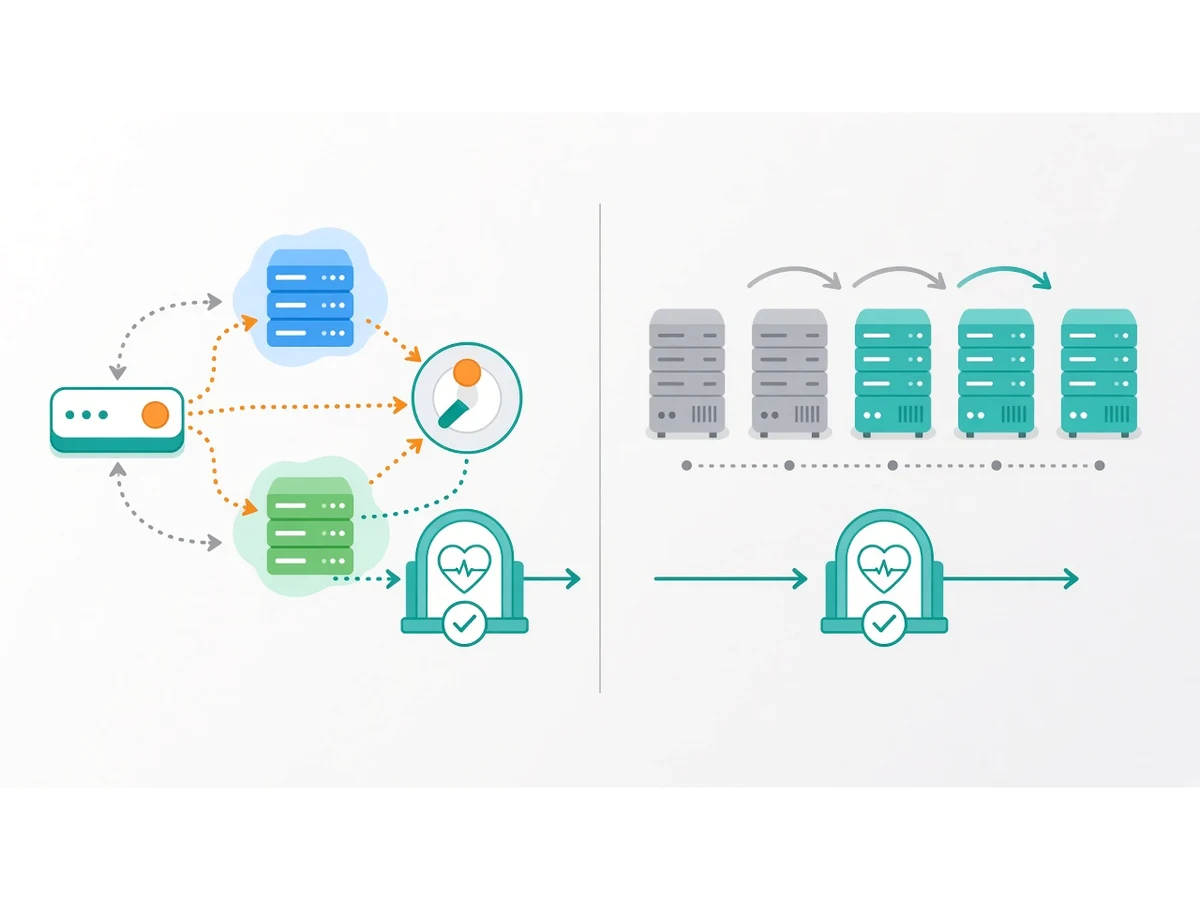
طبق توضیح Fowler، دو محیط تولید داریم که تا حد امکان یکساناند. در هر لحظه یکی (مثلاً blue) زنده است. نسخهٔ جدید را در محیط دیگر (green) مستقر و آزمون نهایی میکنید و پس از اطمینان، router را طوری تغییر میدهید که همهٔ درخواستها به green بروند؛ blue بیکار میشود. مزیت اصلی: بازگشت سریع، چون اگر چیزی خراب شد router را به blue برمیگردانید. دو محیط میتوانند سختافزار جدا، ماشین مجازی یا ناحیههای جدا باشند. هزینه: دو برابر منابع (یا حداقل ظرفیت کافی برای دو نسخه) و نیاز به سازوکار سوئیچ ترافیک. Fowler همچنین اشاره میکند که تراکنشهای ازدسترفته در زمانی که green زنده بوده مسئله است و راههایی مثل حالت فقطخواندنی پیش از جابهجایی را نام میبرد.
rolling
در rolling update، نمونهها یکییکی (یا گروهی) با نسخهٔ جدید جایگزین میشوند و در هر مرحله بقیه ترافیک را میگیرند. مستندات Kubernetes برای Deployment با استراتژی RollingUpdate میگوید پادهای قدیمی بهتدریج کم و جدید زیاد میشوند و دو پارامتر روند را کنترل میکنند: maxUnavailable (حداکثر پادهای در دسترسنبودنی، پیشفرض ۲۵٪) و maxSurge (حداکثر پاد اضافه بر تعداد مطلوب، پیشفرض ۲۵٪)؛ این دو نمیتوانند همزمان صفر باشند. پس از آمادهشدن پادهای جدید، پادهای قدیمی بیشتر کم میشوند. این الگو منابع کمتری از blue-green میخواهد، ولی در طول بهروزرسانی هر دو نسخه همزمان ترافیک میگیرند، پس نسخهٔ جدید و قدیم باید با هم سازگار باشند (بهویژه با دیتابیس و پروتکلها). rollback سختتر است: برگرداندن هم یک rolling دیگر است.
مقایسه
| ویژگی | blue-green | rolling |
|---|---|---|
| منابع | ظرفیت دو محیط | ظرفیت اضافهٔ کم (surge) |
| بازگشت | سوئیچ سریع router | یک rolling معکوس |
| همزیستی نسخهها | فقط در بازهٔ سوئیچ | در کل مدت بهروزرسانی |
| پیچیدگی | سوئیچ ترافیک و هماهنگی داده | تنظیم سرعت و آمادگی نمونهها |
جدول جمعبندی نویسنده از توضیح منابع است و بسته به ابزار شما ممکن است تفاوت داشته باشد.
شرط اول: health check واقعی
هر دو الگو فرض میکنند میدانید نمونهٔ جدید آماده است. مستندات Kubernetes readiness probe را برای همین میگوید: برنامه ممکن است موقتاً (مثلاً هنگام بارگذاری داده یا وابستگی به سرویس خارجی) نتواند ترافیک بپذیرد؛ پادی که آماده گزارش نشود از Service ترافیک نمیگیرد، و probe در کل چرخهٔ حیات اجرا میشود. همچنین liveness و readiness به هم وابسته نیستند و برای انتظار باید از initialDelaySeconds یا startupProbe استفاده کرد. نتیجه عملی برای هر زیرساخت (حتی بدون Kubernetes): endpoint سلامت باید وابستگیهای ضروری (مثل اتصال به دیتابیس) را واقعاً بسنجد، نه فقط «پروسس بالاست». ولی یک endpoint خیلی سختگیر ممکن است با خرابی موقت وابستگی، همهٔ نمونهها را از چرخش خارج کند؛ مرز را آگاهانه تعیین کنید.
شرط دوم: مهاجرت دیتابیس
دیتابیس مشترک بین نسخهٔ قدیم و جدید بزرگترین مانع است. Fowler میگوید ترفند این است که استقرار تغییر schema را از ارتقای برنامه جدا کنید: ابتدا refactoring دیتابیس را اعمال کنید که هر دو نسخهٔ قدیم و جدید را پشتیبانی کند، استقرار و بررسی کنید تا نقطهٔ بازگشت داشته باشید، سپس نسخهٔ جدید برنامه را مستقر کنید، و پس از جاافتادن، پشتیبانی از نسخهٔ قدیم را حذف کنید. این همان الگوی parallel change یا expand and contract است که به سه فاز expand، migrate و contract تقسیم میشود. برای مثال تغییر نام ستون: ستون جدید را اضافه کنید (expand)، برنامه را به خواندن/نوشتن هر دو یا جدید ببرید (migrate) و در نهایت ستون قدیم را حذف کنید (contract). حذف ستون یا تغییر ناسازگار پیش از تمامشدن همهٔ نمونههای قدیمی، rollback را غیرممکن میکند.
شرط سوم: rollback آزموده
- در blue-green، بازگشت یعنی سوئیچ دوباره؛ ولی اگر دادهای در green نوشته شده و schema ناسازگار است، بازگشت ساده نیست.
- در rolling، بازگشت یعنی استقرار نسخهٔ قبلی با همان روش؛ سرعت و مدت آن را پیشتر بسنجید.
- معیار تصمیم را قبل از استقرار بنویسید: چه نرخ خطا یا تأخیر یعنی «برگرد»؟ این معیار توصیهٔ نویسنده است.
- بازگشت را در محیط آزمایشی تمرین کنید، نه فقط ادعا.
نشست و اتصالهای جاری
اگر نشست کاربر در حافظهٔ نمونه نگهداری میشود، جابهجایی نمونه کاربر را از حساب خارج میکند؛ نشست را در محل مشترک (مثل پایگاه داده یا کش مشترک) نگه دارید یا پذیرفتهاید که کاربران دوباره وارد شوند. اتصالهای جاری و درخواستهای طولانی هم باید پیش از خاموشی نمونهٔ قدیمی تمام شوند؛ نمونهٔ قدیمی را از چرخش خارج کنید (draining) و بگذارید درخواستهای در جریان تمام شود. جزئیات هر ابزار load balancer باید از مستندات همان خوانده شود.
مثال ساختگی: تغییر نام ستون
تیمی فرضی ستون phone را به mobile تغییر میدهد. اگر در یک استقرار هم ستون را عوض و هم کد را جایگزین میکردند، در بازهٔ rolling نمونههای قدیمی خطای «ستون وجود ندارد» میدادند. در عوض سه استقرار انجام میدهند: ابتدا ستون جدید اضافه و نوشتن هر دو ستون فعال میشود؛ بعد خواندن از ستون جدید؛ در پایان، پس از اطمینان، ستون قدیم حذف میشود. هر مرحله rollbackپذیر است. این مثال ساختگی است و فقط الگو را نشان میدهد.
اشتباهات رایج
- health check سطحی که نمونهٔ ناآماده را آماده اعلام میکند.
- تغییر ناسازگار schema همزمان با استقرار برنامه.
- نداشتن معیار روشن برای rollback.
- نشستهای ذخیرهشده در حافظهٔ نمونه.
- خاموشکردن نمونهٔ قدیمی بدون draining.
- آزمون نکردن بازگشت.
پایش حین استقرار
استقرار بدون قطعی بدون پایش فقط یک ادعاست. در حین استقرار چند سیگنال را زیر نظر بگیرید: نرخ خطای 5xx، تأخیر درخواستها، تعداد نمونههای آماده، و خطاهای مربوط به دیتابیس. یک پنجرهٔ مشاهده (مثلاً چند دقیقه) پس از تکمیل سوئیچ یا آخرین مرحلهٔ rolling در نظر بگیرید و پیش از اعلام موفقیت منتظر بمانید. اگر استقرار تدریجی را دوست دارید، ابتدا ترافیک کمی را به نسخهٔ جدید بدهید و در صورت سالمبودن افزایش دهید (الگوی canary که در منابع خواندهشده بررسی نشد). نتیجهٔ هر استقرار را با زمان، نسخه و مشکلات ثبت کنید تا الگوهای تکرارشونده دیده شود. این توصیهها عملی نویسندهاند.
هزینه و انتخاب عملی
برای تیم کوچک با یک سرور، blue-green کامل معمولاً گران یا پیچیده است. نسخهٔ سبک آن میتواند دو نمونهٔ برنامه روی یک سرور با پورتهای متفاوت و یک پروکسی جلوی آنها باشد؛ پروکسی بین دو پورت جابهجا میشود و reload بیوقفهٔ آن قطعی را کم میکند. این الگو محافظت در برابر خرابی سرور نمیدهد و فقط خطای استقرار را پوشش میدهد؛ نیازمندیهای خودتان را بسنجید. اگر چند نمونه پشت load balancer دارید، rolling سادهترین گزینه است به شرط سازگاری نسخهها. انتخاب را بر اساس تحمل شما برای قطعی، هزینهٔ منابع و مهارت تیم بگیرید، نه بر اساس نام الگو. این بخش جمعبندی نویسنده است.
چکلیست
- الگو (blue-green یا rolling) با توجه به منابع و ابزار انتخاب شده است.
- health check وابستگیهای ضروری را میسنجد و آزموده شده است.
- تغییرات schema بهصورت expand/migrate/contract و جدا از استقرار برنامهاند.
- نسخهٔ جدید و قدیم با هم سازگارند.
- معیار و روش rollback نوشته و آزموده شده است.
- نشست و اتصالهای جاری مدیریت میشوند.
منابع و مراجع
- BlueGreenDeployment — Martin Fowler (martinfowler.com)، 2026-10-19.
- Parallel Change — Martin Fowler (martinfowler.com)، 2026-10-19.
- Deployments — Kubernetes Documentation، 2026-10-19.
- Configure Liveness, Readiness and Startup Probes — Kubernetes Documentation، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.