بازیابی سرور لینوکس بعد از خرابی دیسک یا استقرار اشتباه
7 دقیقه مطالعه
چکلیست بازیابی سرور Linux: فهرست اجزا، قاعدهٔ ۳-۲-۱، بازیابی دیتابیس، ترتیب عملی شامل DNS و TLS و تمرین بازیابی.
خرابی دیسک یا یک استقرار اشتباه که داده را خراب میکند، لحظهای نیست که بخواهید همان موقع بفهمید چه باید کرد. بازیابی سرور مجموعهای از تصمیمهای ترتیبدار است: چه چیزی را اول بازگردانیم، از کدام نسخه، با چه کلیدی و چه چیزی را پیش از شروع بررسی کنیم. این مقاله یک چکلیست بازیابی عملی میدهد که بر پایهٔ راهنمای CISA دربارهٔ پشتیبانگیری (قاعدهٔ ۳-۲-۱)، مستندات PostgreSQL برای بازیابی و مستندات Certbot (خواندهشده ۱۹ اکتبر ۲۰۲۶) است. بخشهای مبتنی بر تجربهٔ نویسنده جدا مشخص شدهاند. پیش از استفاده روی محیط واقعی، آن را روی یک سرور آزمایشی تمرین کنید؛ چکلیستی که هرگز تمرین نشده، چکلیست نیست. برای زمینه برنامهریزی پروژه نرمافزاری و Monitoring را ببینید.
اصل: بازیابی از پیش طراحی میشود
راهنمای CISA میگوید دادههای حیاتی باید پشتیبانگیری شوند و یک فایل پشتیبان کافی نیست. قاعدهٔ ۳-۲-۱ آن: سه نسخه از داده (یک اصلی و دو پشتیبان)، روی دو نوع رسانهٔ متفاوت، و یک نسخه خارج از محل. این سند مربوط به ۲۰۱۲ است و جزئیات فناوریاش قدیمی است، ولی اصل آن هنوز مرجع رایجی است. برای سرور وب یعنی: نسخهٔ پشتیبان فقط روی همان دیسک نباشد، و حداقل یک نسخه جدا از سرور (و ترجیحاً جدا از حساب ارائهدهنده) نگه داری شود. همچنین بازیابی را پیش از نیاز آزمون کنید؛ این بخش توصیهٔ نویسنده است و مهمترین قسمت چکلیست است.
فهرست آنچه باید بازگردد
پیش از بحران، فهرست کنید سرور شما از چه ساخته شده. نمونه:
- کد و پیکربندی برنامه: مخزن کد، فایلهای محیط، unit فایلهای systemd، پیکربندی وبسرور.
- داده: پایگاه داده، فایلهای بارگذاریشده، صفها.
- هویت و رمز: کلیدهای SSH، secretها، کلیدهای رمزگذاری.
- TLS: گواهیها؛ مستندات Certbot میگوید فایلها زیر
/etc/letsencryptهستند و فایلهای renewal را نباید دستی خراب کرد؛ گواهی را در بازیابی میتوان دوباره صادر کرد ولی rate limit را به یاد داشته باشید. - شبکه: رکوردهای DNS، فایروال، آدرسهای IP.
- عملیات: کارهای زمانبندیشده، پایش، لاگها.
این فهرست توصیهٔ نویسنده است؛ مورد جامانده در بحران پیدا نمیشود.
بازیابی پایگاه داده
مستندات PostgreSQL سه رویکرد اساساً متفاوت برای پشتیبانگیری معرفی میکند: SQL dump، backup سطح فایلسیستم و continuous archiving، که هرکدام قوت و ضعف دارد. برای continuous archiving و بازیابی در یک نقطهٔ زمانی (PITR) به دنبالهٔ پیوستهٔ فایلهای WAL از دستکم زمان شروع backup نیاز است و مستندات توصیه میکند روش بایگانی WAL را پیش از اولین base backup راهاندازی و آزمایش کنید؛ همچنین فقط کل cluster قابل بازیابی است. نتیجه: بازیابی دیتابیس باید روشی باشد که قبلاً امتحان کردهاید، با زمان تقریبی بازیابی مشخص. اگر از سرویس مدیریتشده استفاده میکنید، روش بازیابی ارائهدهنده را از مستندات خودش بخوانید؛ آن در این مقاله بررسی نشد.
ترتیب عملی بازیابی
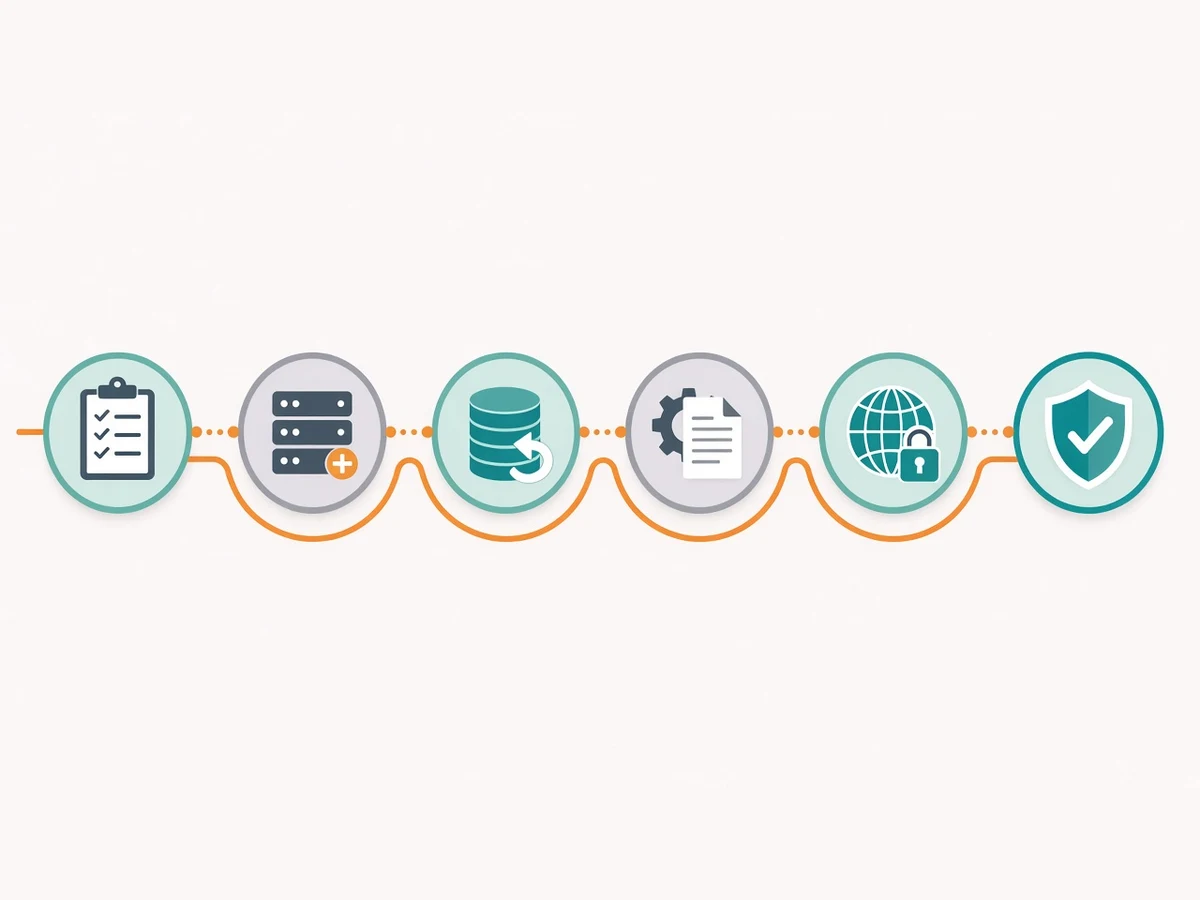
- ارزیابی و توقف آسیب: علت را مشخص کنید (دیسک، استقرار، حمله). اگر استقرار داده را خراب میکند، نوشتن را متوقف کنید (حالت نگهداری) تا آسیب بیشتر نشود.
- تصمیم: ترمیم یا بازسازی: سرور فعلی قابل اعتماد است؟ اگر دیسک خراب یا حمله بوده، سرور جدید بسازید (راه امنتر) نه ترمیم روی سیستم مشکوک.
- سرور پایه: سیستمعامل، کاربر، SSH با کلید، فایروال و بهروزرسانی را مطابق runbook راهاندازی اولیه برپا کنید (مقالهٔ راهاندازی Ubuntu و UFW).
- داده: آخرین پشتیبان سالم را بازیابی و سلامت آن را بررسی کنید (تعداد رکوردها، آزمونهای سبک).
- برنامه و پیکربندی: نسخهٔ سالم برنامه را از مخزن بگذارید و secretها را از مدیر امن تزریق کنید.
- TLS: گواهی را بازیابی یا دوباره صادر کنید.
- DNS: وقتی سرور جدید سالم است، DNS را به آدرس جدید ببرید؛ TTL رکورد زمان رسیدن تغییر را تحت تأثیر میگذارد، پس پیش از بحران آن را کم نگه دارید (توصیهٔ عمومی، از منبع خواندهشده نیامده).
- آزمون و پایش: سناریوهای کلیدی را آزمون کنید و پایش را فعال کنید.
پس از بازیابی
گزارش پس از حادثه بنویسید (علت، زمان، آنچه کار کرد و نکرد) و چکلیست را اصلاح کنید. اگر دادهٔ جدید بین آخرین پشتیبان و خرابی از دست رفت، آن را شناسایی و در صورت امکان با کاربران یا منابع دیگر ترمیم کنید. اگر دادهٔ شخصی درگیر بود، الزامات اطلاعرسانی و گزارش را از منابع رسمی مربوط بخوانید؛ این مقاله حکم حقوقی نمیدهد. کلیدها و رمزهایی که ممکن است در معرض خطر بودهاند را بچرخانید.
تمرین بازیابی
حداقل سالی دو بار بازیابی را در محیط جدا تمرین کنید: سرور آزمایشی بسازید، از پشتیبان بازیابی کنید و زمان واقعی را اندازه بگیرید. اندازهگیری نشان میدهد هدف زمان بازیابی شما (RTO) و میزان دادهای که ممکن است از دست برود (RPO) واقعگرایانهاند یا نه. هر شکستی در تمرین، اصلاحی در چکلیست است. این بخش توصیهٔ عملی نویسنده است.
مثال ساختگی: خرابی دیسک شبانه
دیسک سرور فرضی شبانه خراب میشود. تیم طبق runbook سرور جدید میسازد، پایگاه داده را از آخرین پشتیبان شبانه بازیابی میکند، کد را از مخزن میگذارد و گواهی را دوباره صادر میکند. DNS با TTL کوتاه در چند دقیقه عوض میشود. چون پشتیبان فقط شبانه بود، دادهٔ چند ساعت آخر از دست رفته و تیم تصمیم میگیرد دورهٔ پشتیبان را کوتاهتر یا بایگانی WAL را فعال کند. این مثال ساختگی است.
اشتباهات رایج
- نگهداشتن پشتیبان فقط روی همان سرور.
- هرگز آزمون نکردن بازیابی.
- فراموشکردن کلیدها و secretها در فهرست بازیابی.
- ترمیم روی سیستم مشکوک بهجای بازسازی.
- TTL بلند DNS و تأخیر در سوئیچ.
- نبود پایش پس از بازیابی.
ارتباط در حین حادثه
در بحران، فنیترین بخش کار معمولاً سادهترین بخش است؛ سختترین بخش هماهنگی است. یک نفر را مسئول هماهنگی (incident lead) تعیین کنید که تصمیم میگیرد و وضعیت را اعلام میکند، تا چند نفر همزمان دستورهای متناقض اجرا نکنند. وضعیت را در یک کانال مشخص بهروز نگه دارید: چه چیز خراب است، چه کاری در حال انجام است و برآورد زمان بعدی. برای کاربران یک پیام ساده و صادقانه آماده کنید که علت را حدس نزند و فقط وضعیت و زمان بعدی بهروزرسانی را بگوید. زمانبندی هر کار را یادداشت کنید، چون برای گزارش پس از حادثه لازم میشود. این توصیهها عملی نویسندهاند و جایگزین سیاست رسمی مدیریت حادثهٔ سازمان شما نیستند.
جای نگهداری پشتیبان و امنیت آن
راهنمای CISA دربارهٔ پشتیبان ابری مزیتهایی مثل محافظت در برابر بلایای محلی و معایبی مثل وابستگی به اینترنت، قفلشدن در یک ارائهدهنده و کنترل کم بر داده میشمرد، و توصیه میکند داده را رمزنگاری کنید و رسانههای فیزیکی را امن نگه دارید. در عمل: پشتیبان باید رمزنگاری شود و کلید رمزگشایی جدا و امن نگهداری شود (اگر کلید فقط روی همان سرور باشد، با از دست رفتن سرور پشتیبان بیفایده است). دسترسی نوشتن به محل پشتیبان را محدود کنید تا مهاجمی که سرور را میگیرد نتواند پشتیبانها را هم حذف کند؛ نسخهای که فقطافزودنی یا غیرقابلحذف باشد ارزش دارد (جزئیات ابزارها بررسی نشد). برای نگهداری خارج از کشور یا ارائهدهندهٔ ابری، الزامات قانونی و حریم خصوصی داده را از منابع رسمی بررسی کنید؛ این مقاله حکم حقوقی نمیدهد.
چکلیست
- فهرست اجزای سرور و محل پشتیبان هرکدام نوشته شده است.
- قاعدهٔ ۳-۲-۱ (حداقل یک نسخهٔ خارج از محل) رعایت میشود.
- بازیابی دیتابیس با روش آزموده و زمان اندازهگیریشده مستند است.
- runbook راهاندازی سرور پایه آماده است.
- کلیدها و secretها جدا و امن نگهداری میشوند.
- تمرین بازیابی دورهای انجام میشود.
منابع و مراجع
- Data Backup Options — CISA / US-CERT (Carnegie Mellon University)، 2026-10-19.
- Chapter 25. Backup and Restore (PostgreSQL 18) — PostgreSQL Documentation 18، 2026-10-19.
- 25.3. Continuous Archiving and Point-in-Time Recovery (PostgreSQL 18) — PostgreSQL Documentation 18، 2026-10-19.
- User Guide — Certbot 5.8.0 documentation — EFF Certbot Documentation، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.