ارزیابی RAG با مجموعهسؤال
7 دقیقه مطالعه
چطور کیفیت RAG را با مجموعهسؤال بسنجیم؟ جداکردن ریکال و پرسیژن بازیابی از وفاداری پاسخ با معیارهای Ragas و چکلیست.
تیمی که RAG ساخته معمولاً چند سؤال امتحان میکند، پاسخها را «خوب» میبیند و به تولید میرود. چند هفته بعد کاربر سؤال دیگری میپرسد و جواب غلط میگیرد؛ حالا کسی نمیداند اشکال از جستوجو بود یا از مدل. راهحل، یک مجموعهسؤال ثابت و معیارهایی است که بازیابی و پاسخ را جدا بسنجد. این مقاله روش ساخت آن را با کمک تعریف معیارهای مستندات Ragas و مقالهٔ آن شرح میدهد.
مرجع: مستندات Ragas (Context Recall، Context Precision، Faithfulness) و مقالهٔ Es و همکاران (arXiv 2309.15217)، خواندهشده در ۱۹ اکتبر ۲۰۲۶. Ragas یکی از چند ابزار است؛ ما ابزار خاصی را توصیه نمیکنیم و فقط تعریف معیارها را وام میگیریم. مثالها ساختگیاند و ما آزمونی روی سیستم واقعی اجرا نکردهایم.
چرا باید دو بخش را جدا سنجید
مقالهٔ Ragas میگوید ارزیابی RAG سخت است چون چند بعد دارد: توان بازیابی در یافتن قطعهٔ مرتبط و متمرکز، توان LLM در استفادهٔ وفادارانه از آن قطعه، و کیفیت خود تولید. اگر قطعهٔ درست اصلاً بازیابی نشود، بهترین مدل هم نمیتواند پاسخ مستند بدهد. اگر قطعهٔ درست بیاید ولی پاسخ از آن تخطی کند، مشکل در prompt یا مدل است. این جداسازی مشخص میکند کجا سرمایهگذاری کنید.
| لایه | سؤال | معیار نمونه |
|---|---|---|
| بازیابی | مطلب لازم آمد؟ | Context Recall |
| بازیابی | قطعههای آمده مفید بودند یا نویز؟ | Context Precision |
| تولید | پاسخ از زمینه تخطی کرد؟ | Faithfulness |
| تولید | به پرسش پاسخ داد و کامل بود؟ | بازبینی انسانی / معیار ارتباط |
ساخت مجموعهسؤال
مجموعهٔ ارزیابی همان «آزمون واحد» RAG است. پیشنهاد عملی (نویسنده):
- ۴۰ تا ۱۰۰ پرسش واقعی از لاگ پشتیبانی یا کاربران، نه پرسشهایی که خود تیم مینویسد؛ نمونههای مبهم و سخت هم داشته باشد.
- برای هر پرسش، پاسخ مرجع کوتاه و سند/بخش درست را ثبت کنید و نسخهٔ سند را هم بنویسید.
- موارد «پاسخ در دانش نیست» را هم اضافه کنید؛ رفتار درست «نمیدانم» است.
- مجموعه را نسخهبندی کنید و با هر تغییر بزرگ داده یا پارامتر بازیابی، دوباره اجرا کنید.
عدد ۴۰ تا ۱۰۰ توصیهٔ تجربی نویسنده است، نه استاندارد منبع؛ با حساسیت ریسک و تنوع دانش تنظیم کنید.
معیارهای بازیابی
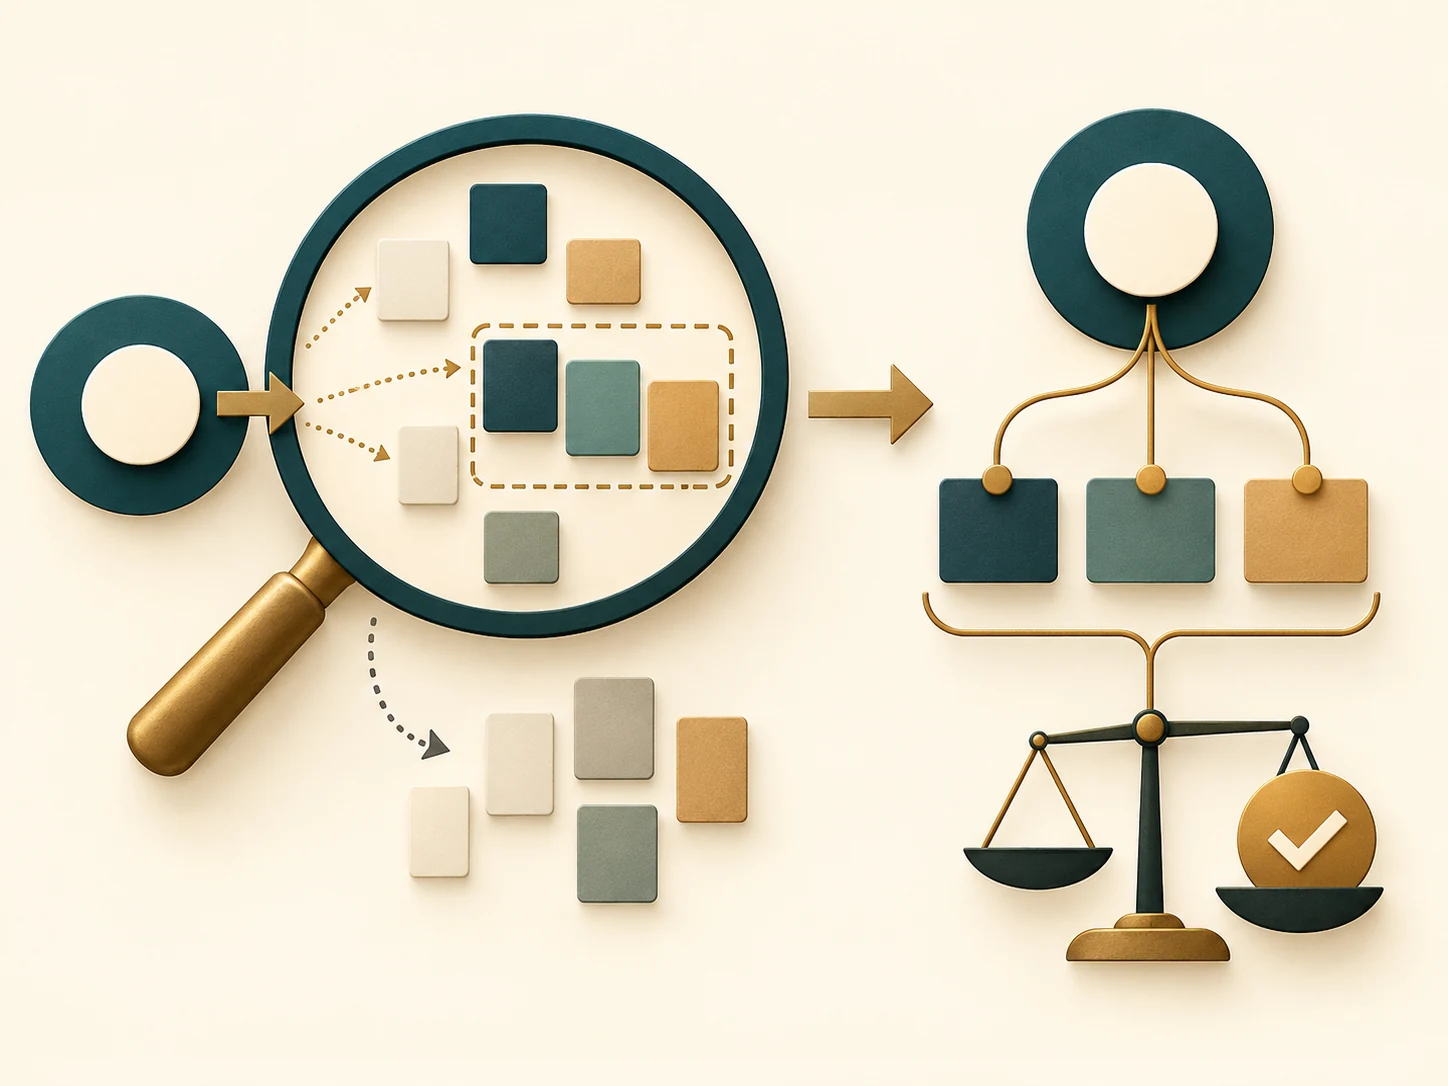
Context Recall طبق Ragas یعنی چه مقدار از اطلاعات مرتبط واقعاً بازیابی شده؛ «چیز مهمی را از دست ندادن». چون به مرجع نیاز دارد، پاسخ مرجع را به چند ادعا میشکند و نسبت ادعاهایی را که زمینهٔ بازیابیشده پشتیبانی میکند میشمارد. اگر ریکال پایین است، مشکل را در قطعهبندی، embedding، فقدان تطبیق واژگانی یا نبودن سند جستوجو کنید.
Context Precision مفید بودن قطعههای بازیابیشده را با precision@k میسنجد: در هر رتبه، مثبت درست نسبت به مثبت کاذب. دو حالت دارد: با پاسخ مرجع، یا بدون مرجع با مقایسه با پاسخ تولیدی (Context Utilization). اگر پرسیژن پایین است، قطعههای نامرتبط وارد prompt میشوند؛ تعداد top-K، reranking و فیلتر متادیتا را بازبینی کنید.
تعادل: بالا بردن K ریکال را زیاد میکند ولی پرسیژن و هزینهٔ توکن را بدتر میکند؛ هر دو را با هم گزارش کنید.
معیارهای پاسخ
Faithfulness نسبت ادعاهای پاسخ است که از زمینهٔ بازیابیشده قابل استنتاجاند (۰ تا ۱). این معیار «درست بودن در جهان» نیست، «وفاداری به زمینه» است: اگر زمینه غلط باشد، پاسخ وفادار هم غلط است. به همین دلیل Faithfulness را کنار بازبینی انسانی نمونهای از پاسخها و مرجعها ببینید. پاسخهایی که خارج از زمینه ادعا میکنند را برچسب بزنید و ببینید prompt «فقط از متن زیر» رعایت میشود یا نه.
محدودیت داور خودکار
نسخههای LLM-محور این معیارها با یک مدل دیگر امتیاز میدهند (در مستندات، مثال با یک مدل OpenAI). پس امتیاز خودِ ابزار هم میتواند اشتباه کند و به انتخاب مدل داور و زبان متن وابسته باشد. ما دقت این معیارها را روی متن فارسی بررسی نکردهایم و در منابع رسمی هم عدد فارسی نیافتیم. پیشنهاد: بخشی از نمونهها را انسان امتیاز بدهد و با امتیاز خودکار مقایسه کند تا اعتماد به ابزار کالیبره شود.
اجرای ارزیابی و جدول نتایج
برای هر اجرا: نسخهٔ داده، تنظیمات chunk و top-K، نسخهٔ مدل، و امتیازها را ثبت کنید. جدول مقایسهای ساختگی:
| اجرا | تغییر | ریکال | پرسیژن | وفاداری |
|---|---|---|---|---|
| پایه | K=3 | ۰٫۶۱ | ۰٫۷۲ | ۰٫۸۸ |
| الف | K=6 | ۰٫۷۴ | ۰٫۵۸ | ۰٫۸۵ |
| ب | K=6 + rerank | ۰٫۷۳ | ۰٫۷۰ | ۰٫۸۷ |
اعداد جدول فرضیاند و برای نشاندادن شیوهٔ خواندن آمدهاند. مثلاً اینجا افزایش K ریکال را بالا برد ولی پرسیژن را کم کرد و rerank بخشی از آن را برگرداند. بهجای مقایسهٔ تکی، اجرای تکراری با همان مجموعه را مبنا بگیرید.
آستانهٔ انتشار و پایش
- برای هر معیار آستانهٔ حداقل مشخص کنید و اگر پایینتر رفت، انتشار نکنید (آستانه بر پایهٔ ریسک شما، نه عدد منبع).
- بعد از انتشار، بازخورد کاربر («مفید؟») و نمونهٔ پاسخها را به مجموعه برگردانید.
- تغییر مدل، داده یا پارامتر بازیابی را مثل تغییر کد با اجرای ارزیابی قفل کنید.
- تأخیر و خطا را جدا پایش کنید (پایش سیستم).
مثال گامبهگام: یک پرسش
پرسش ساختگی: «مهلت بازگشت وجه چند روز است؟». پاسخ مرجع: «۷ روز از تاریخ تحویل، برای کالای باز نشده». این پاسخ دو ادعا دارد: (۱) مهلت ۷ روز است، (۲) شرط بازنشده بودن کالا.
- بازیابی: سه قطعه آمد. قطعهٔ الف شامل «۷ روز از تحویل»؛ قطعهٔ ب سیاست ارسال؛ قطعهٔ ج شرایط کالای باز نشده. هر دو ادعای مرجع از زمینه قابلانتسابند، پس ریکال به شیوهٔ Ragas برابر ۲ از ۲ است. از سه قطعه دو تا مفید بودهاند، یعنی پرسیژن حدود دو سوم؛ قطعهٔ ب نویز است.
- پاسخ: مدل نوشت «۷ روز و کالا باید باز نشده باشد و هزینهٔ ارسال برگشتی با فروشنده است». ادعای سوم در زمینه نیست، پس از سه ادعا فقط دو ادعا پشتیبانی میشود و وفاداری حدود دو سوم است؛ یعنی مدل از زمینه فراتر رفته است.
- اقدام: قطعهٔ ب را با فیلتر متادیتا کنار بگذارید و prompt را سختتر کنید که ادعای خارج از متن ننویسد.
عددها برای توضیح شیوهٔ محاسبهٔ ساده آمدهاند؛ ابزار Ragas امتیاز را با داور LLM و فرمول خودش حساب میکند و ممکن است عدد دقیق متفاوت بدهد.
عیبیابی: از علامت تا اقدام
| علامت | محتملترین علت | اقدام نخست |
|---|---|---|
| ریکال پایین | سند وارد نمایه نشده، قطعهبندی بد یا فقط جستوجوی معنایی | بازبینی ingest و افزودن تطبیق واژگانی |
| پرسیژن پایین | K زیاد، نبود فیلتر یا rerank | کاهش K، فیلتر متادیتا، reranking |
| وفاداری پایین با ریکال خوب | prompt شل یا مدل ضعیف در پیروی از زمینه | سختکردن دستور و نمونههای «نمیدانم» |
| همهچیز خوب ولی کاربر ناراضی | مجموعهسؤال واقعی نیست یا مرجع کهنه است | بهروزرسانی مجموعه از لاگ واقعی |
اشتباهات رایج
- ارزیابی با چند سؤال دلخواه.
- ادغام کیفیت بازیابی و پاسخ در یک عدد.
- اعتماد کامل به داور LLM بدون نمونهٔ انسانی.
- مقایسهٔ اجراها با مجموعههای متفاوت.
- باور اینکه Faithfulness بالا یعنی پاسخ درست است.
- نداشتن نمونهٔ «پاسخ در دانش نیست».
چکلیست
- مجموعهسؤال واقعی، نسخهبندیشده و با مرجع داریم.
- موارد «نمیدانم» را پوشش دادهایم.
- ریکال و پرسیژن بازیابی جدا از وفاداری پاسخ گزارش میشود.
- بخشی از امتیازها را انسان بازبینی میکند.
- هر اجرا با نسخه داده و پارامترها ثبت میشود.
- آستانهٔ انتشار تعریف شده است.
- بازخورد کاربران به مجموعه برمیگردد.
برای تعریف آستانهها شبیه معیار پذیرش در user story و معیارهای آمادگی تولید فکر کنید.
منابع و مراجع
- Context Recall — Ragas Documentation.
- Context Precision — Ragas Documentation.
- Faithfulness — Ragas Documentation.
- Ragas: Automated Evaluation of Retrieval Augmented Generation — Es et al. (arXiv 2309.15217).
- Introducing Contextual Retrieval — Anthropic Engineering، 2024-09-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.