آمادهسازی داده برای RAG
7 دقیقه مطالعه
چطور داده را برای RAG آماده و نسخهبندی کنیم؟ شناخت منبع، حذف تکرار، مجوز، قطعهبندی، متادیتا و تازگی با چکلیست.
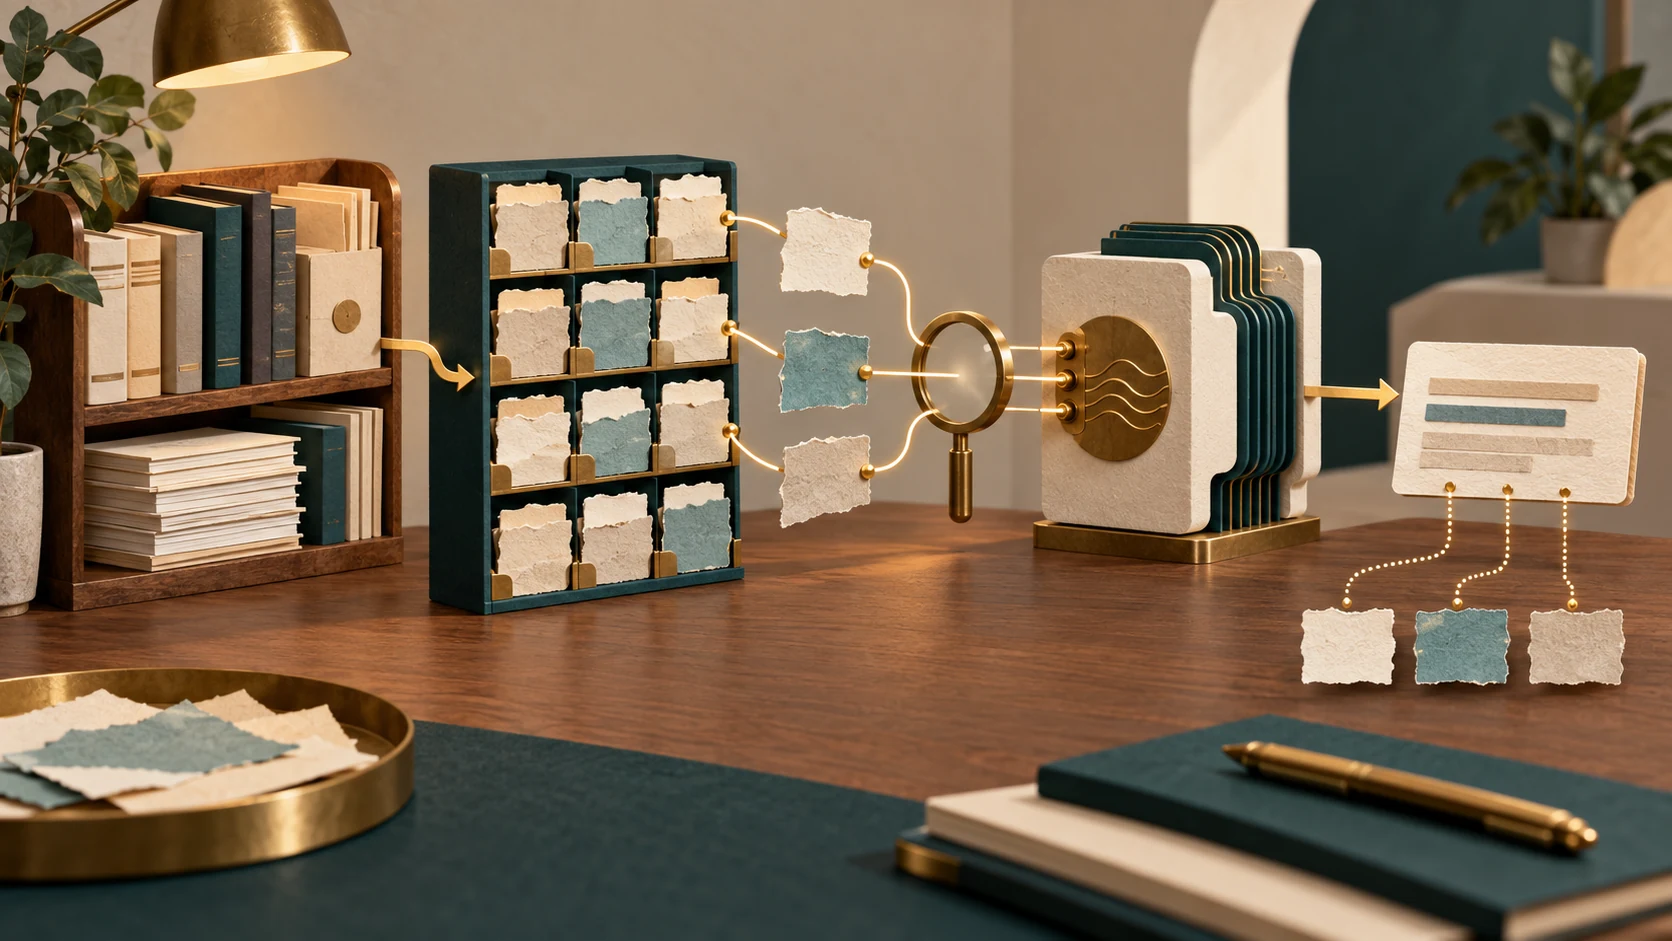
در پروژههای RAG، بیشترین زمان به مدل نمیرسد؛ به داده میرسد. اگر دانش شما تکراری، کهنه، بیمجوز یا بدون ساختار وارد نمایه شود، بهترین مدل و بهترین جستوجو هم پاسخ خوب نمیدهند. این مقاله یک خط تولید داده برای RAG را میچیند: تحلیل منبع، حذف تکرار، مجوز و دسترسی، متادیتا، قطعهبندی، تازگی و نسخهبندی.
منابع: سه صفحهٔ «Develop a RAG solution» در Azure Architecture Center (آمادهسازی، قطعهبندی، غنیسازی)، مقالهٔ Contextual Retrieval از Anthropic و راهنمای SageMaker، همه در ۱۹ اکتبر ۲۰۲۶ خوانده شد. مستندات Microsoft به Azure نظر دارد اما اصول آن عمومی است؛ ما ابزار یا سرویس خاصی را توصیه نمیکنیم. حذف تکرار، نسخهبندی، مجوز انتشار و تازگی که در این مقاله میآیند عمدتاً توصیهٔ نویسندهاند و در متن برچسب خوردهاند. مثالها ساختگیاند. برای چارچوب بزرگتر آمادهسازی تولید نرمافزار آمادهٔ تولید را ببینید.
گام ۱: شناخت منبع
Microsoft فاز آمادهسازی را با تعریف حوزه شروع میکند: چه پرسشهایی قرار است پاسخ داده شود و کدام سند آن را میدهد. پرسشها باید با محتوا قابل پاسخ باشند و محتوا هم باید به آن پرسشها جواب دهد؛ بنابراین جمعآوری سند و پرسش نمونه موازی انجام میشود. سپس تحلیل محتوا: طبقهبندیها (راهنمای محصول، قرارداد، گزارش)، قالبها (PDF، HTML، Markdown، DOCX، صوت، ویدیو)، قیود امنیتی و ساختار (طول، جدول، ستونهای چندگانه). هدف این است که هیچ گروه محتوا در آزمایش کم یا زیاد نمایندگی نشود.
جدول شناخت منبع (قالب پیشنهادی، نویسنده):
| ستون | مثال | چرا مهم است |
|---|---|---|
| مالک | تیم پشتیبانی | مسئول صحت و بهروزرسانی |
| قالب | PDF اسکنشده | نیاز به OCR یا استخراج |
| حساسیت | داخلی / عمومی | مجوز دسترسی |
| تغییر | ماهانه | برنامهٔ نمایهسازی مجدد |
| مجوز استفاده | قرارداد با ناشر | اجازه ورود به نمایه |
گام ۲: پاکسازی و حذف تکرار
Microsoft فهرستی از عناصر را میآورد که باید برایشان تصمیم گرفت: فهرست مطالب، سرصفحه و پاصفحه، حق نشر و سلب مسئولیت، پاورقی، واترمارک و حاشیهنویسی. گاهی این عناصر زمینه میدهند و گاهی نویز اند؛ تصمیم باید با آزمون روی پرسشهای نمونه گرفته شود. در مرحلهٔ غنیسازی هم پاکسازی متن (مثل یکدستکردن حروف در زبانهایی که حروف بزرگ و کوچک دارند) برای نزدیکی معنایی مطرح شده است؛ حکم کلی روی فارسی را منابع ندادهاند، پس اثر پاکسازی روی فارسی را باید خودتان بسنجید.
حذف تکرار (توصیهٔ نویسنده): نسخههای تکراری یک سند باعث میشوند چند قطعهٔ تقریباً یکسان جای top-K را بگیرند. هش محتوا برای تشخیص تکرار دقیق و برای نسخههای تقریباً مشابه، انتخاب نسخهٔ معتبر و آرشیو بقیه. Microsoft هم شناسهٔ یکتا را با هش یک فیلد کلیدی پیشنهاد میدهد تا بدانید قطعه از قبل در انبار هست یا نه.
گام ۳: مجوز و دسترسی
Microsoft میگوید اگر کاربران مختلف باید به محتوا یا بخشهای متفاوتی دسترسی داشته باشند، باید بفهمید این مجوزها در راهکار قطعهبندی چگونه حفظ میشوند. عملاً هر قطعه باید برچسب دسترسی سند اصلی را به ارث ببرد و بازیابی بر اساس کاربر فیلتر شود؛ وگرنه RAG میتواند سندی را به کسی نشان دهد که اجازه ندارد. محتوای رسانهای (تصویر و ویدیوی مرتبط) هم همین قیود را دارد و محتوای صوتی و تصویری ممکن است داده شخصی داشته باشد. ما از قوانین حریم خصوصی ایران چیزی ادعا نمیکنیم؛ این بخش را با مشاور حقوقی بسنجید.
گام ۴: قطعهبندی
Microsoft قطعهبندی را برای موفقیت RAG «حیاتی» میداند: سند کامل یا قطعهٔ درشت گران است، ممکن است از حد توکن مدل بگذرد و نتیجهٔ بدتر بدهد؛ قطعهٔ بسیار کوچک هم زمینهٔ کافی ندارد و زمینهٔ پراکنده در چند قطعه ممکن است ثبت نشود. روش مناسب به نوع و ساختار سند بستگی دارد و هر روش هزینهٔ مهندسی و هزینهٔ پردازش بهازای هر سند دارد. Anthropic هم هشدار میدهد قطعه ممکن است زمینه را از دست بدهد (قطعهای که نام شرکت و دوره را ندارد) و راهکار آن افزودن توضیح زمینه به هر قطعه پیش از embedding و BM25 است. نکتهٔ عملی (نویسنده): قطعهها را بر اساس ساختار سند (عنوانها، بخشها، جدول) ببرید نه صرفاً طول ثابت، و عنوان بخش را به متن قطعه اضافه کنید.
گام ۵: متادیتا
راهنمای غنیسازی Microsoft فهرست فیلدهای متادیتا را میدهد: شناسهٔ یکتا (هش)، عنوان، خلاصه، بازنویسی، کلیدواژه، برچسب، موجودیت، متن پاکشده، پرسشهای قابلپاسخ، منبع و زبان. کلیدواژه برای تطبیق دقیق (مثل «محصول X، سال ۲۰۰۹» که از نظر معنایی شبیه سال دیگر است) و برچسب برای جستوجوی ترکیبی و فیلتر مفید است؛ منبع هم امکان ارجاع را میدهد. از آن فهرست و نیاز خودتان یک طرح ثابت بسازید و به آن این فیلدها را بیفزایید (توصیهٔ نویسنده): doc_id، version، valid_from، valid_to، owner، access_group و source_url.
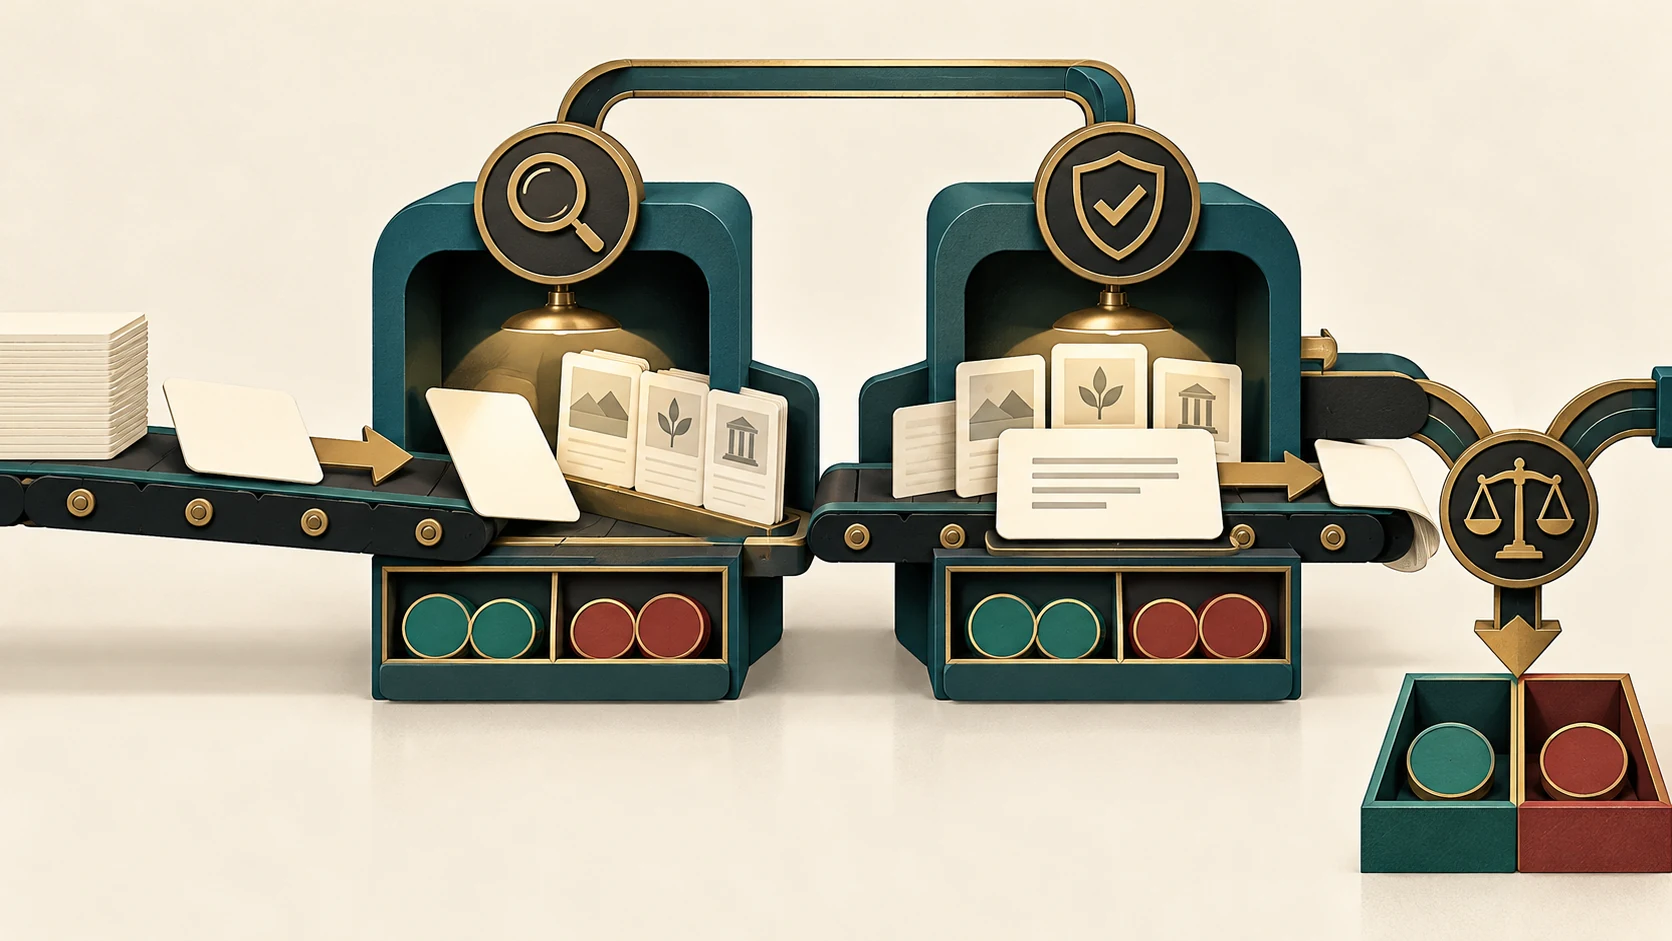
هشدار امنیتی همان صفحه: «هرگز از محتوای مخزن بهعنوان منبع دستور در پردازش استفاده نکنید». مهاجمی که میداند مخزن شما نمایه میشود میتواند در سند دستور برای مدل بگذارد؛ محتوای دارای دستور جاسازیشده را نشانهگذاری یا حذف کنید.
گام ۶: تازگی و نسخهبندی
AWS میگوید نمایه و embeddingها را میتوان ناهمزمان بهروز کرد. این آزادی یک خطر دارد: بین تغییر سند و بهروزشدن نمایه پنجرهای هست که مدل پاسخ کهنه میدهد. پیشنهاد (نویسنده): برای هر سند نسخه و تاریخ اعتبار ثبت کنید؛ با تغییر سند، قطعههای قدیمی را حذف یا غیرفعال کنید؛ در پاسخ تاریخ یا نسخهٔ منبع را نشان دهید؛ و برای سندهای حساس مثل قیمت یا مقررات، بهجای کپی در نمایه، پاسخ را با منبع زنده یا تاریخ اعتبار همراه کنید. اگر پایپلاین هش محتوا را نگه دارد، فقط سندهای تغییرکرده دوباره نمایه میشوند و هزینهٔ پردازش (که Microsoft آن را یکی از اجزای اقتصاد قطعهبندی میداند) کم میماند.
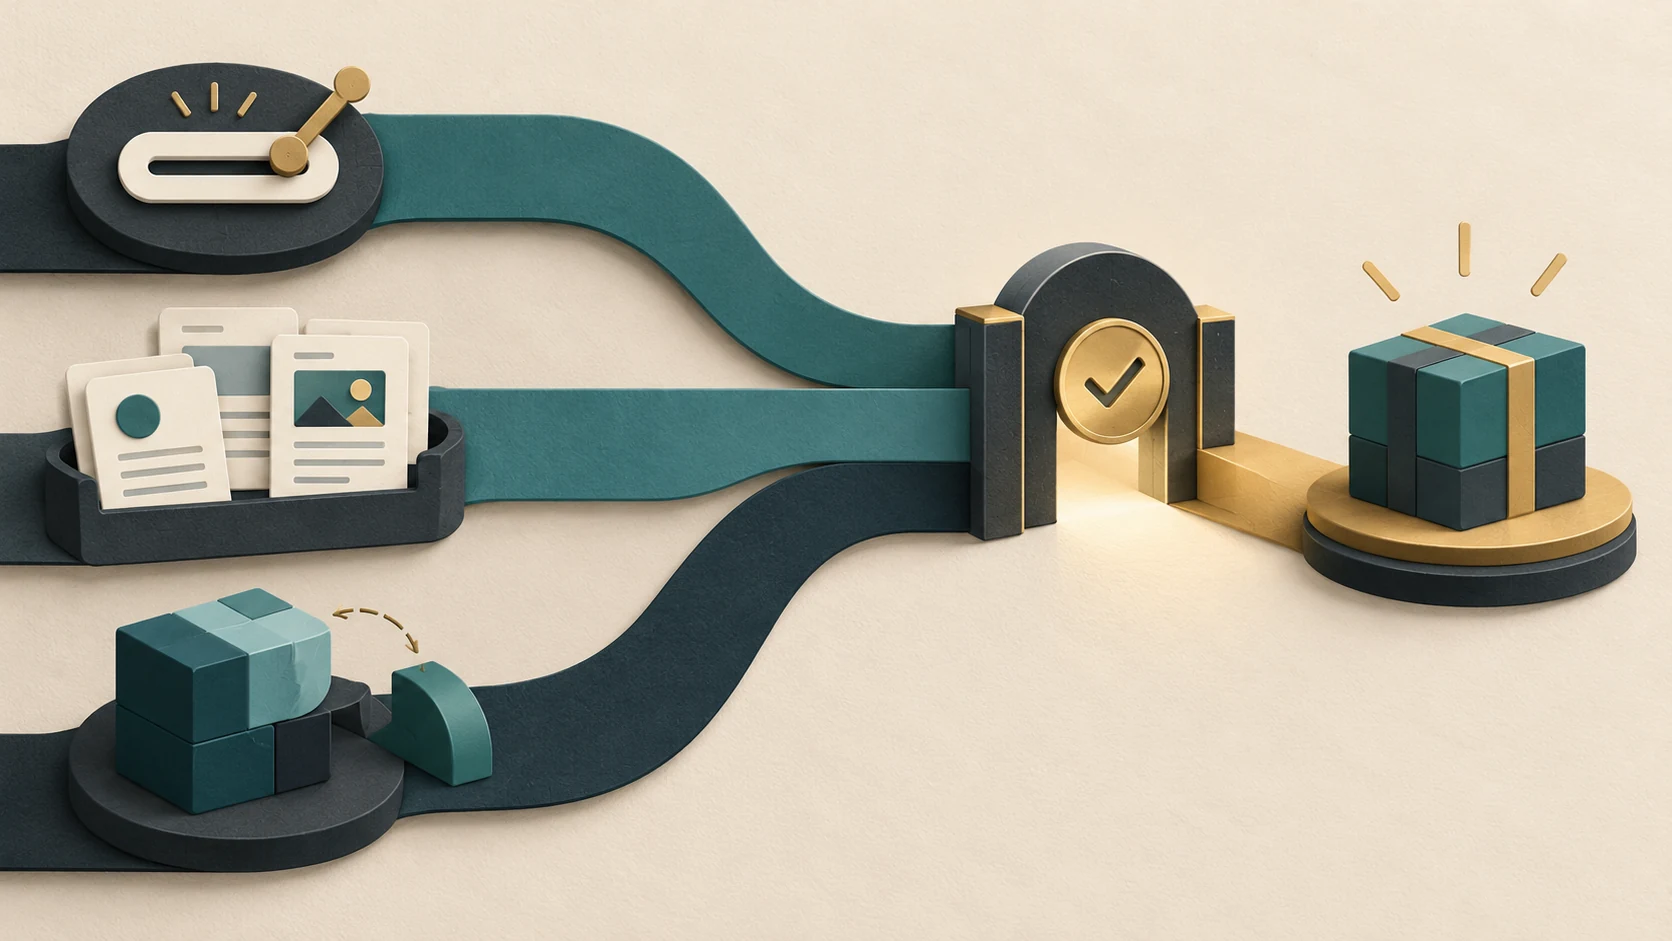
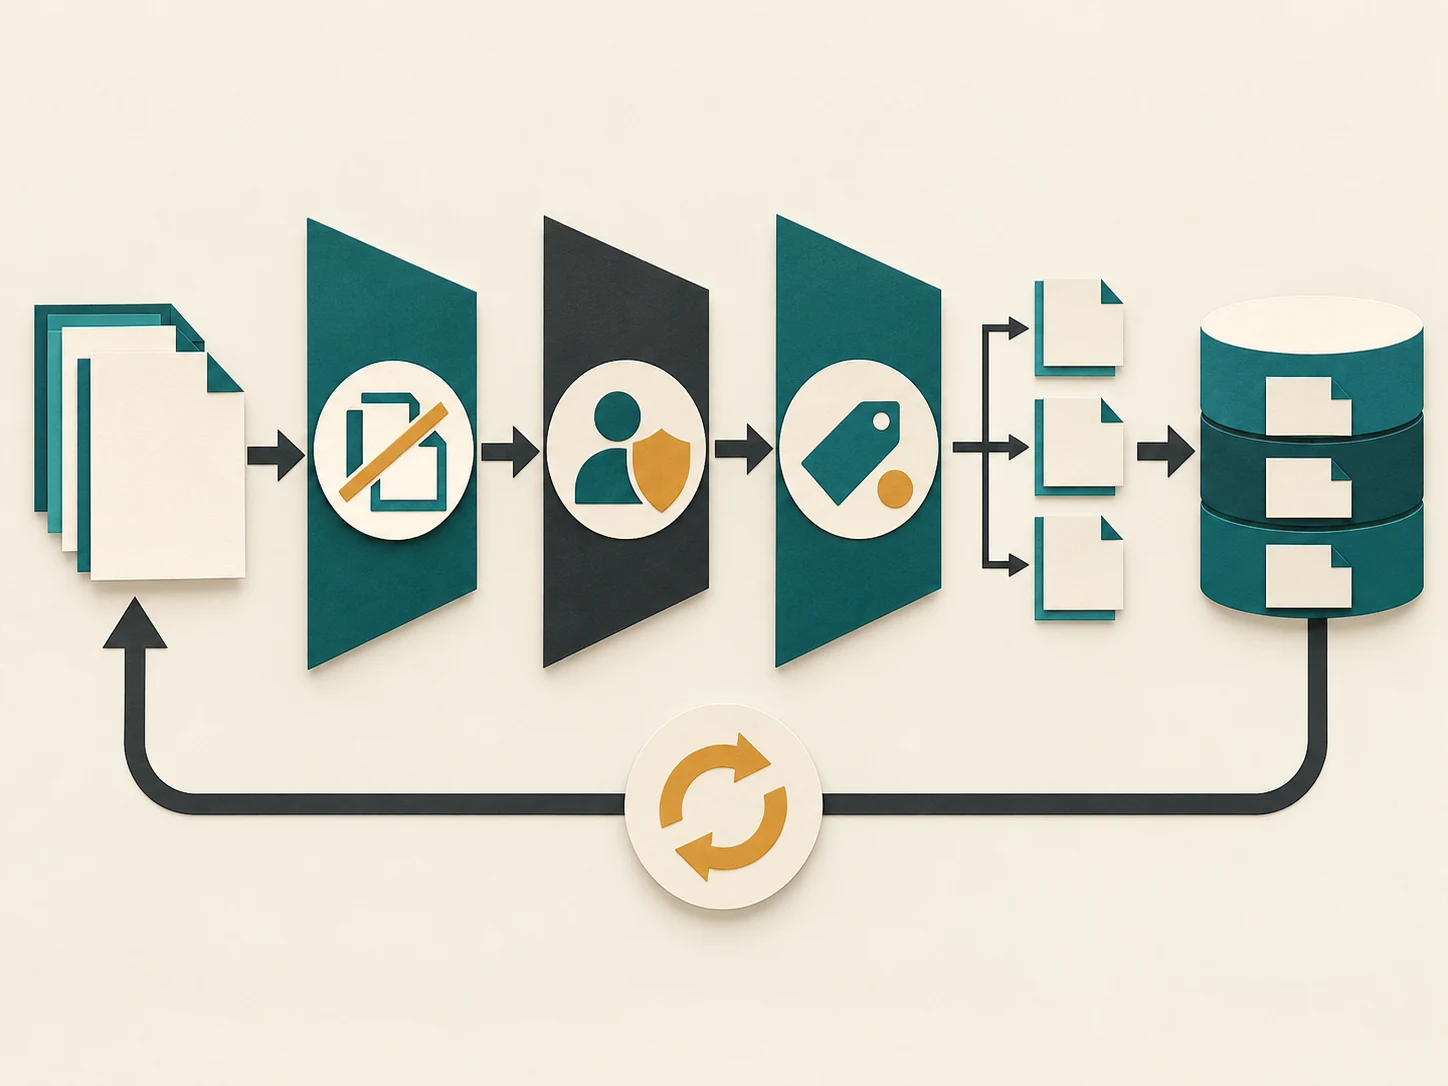
خط تولید پیشنهادی
- ثبت سند در فهرست منبع با مالک، مجوز استفاده و حساسیت.
- استخراج متن و ساختار، حذف نویز با تصمیم آزمایشی.
- هش محتوا و حذف تکرار؛ انتخاب نسخهٔ معتبر.
- تخصیص مجوز دسترسی سند به همهٔ قطعهها.
- قطعهبندی بر اساس ساختار و افزودن عنوان بخش.
- غنیسازی متادیتا (شناسه، نسخه، تاریخ، منبع، زبان، کلیدواژه).
- نمایهسازی و اجرای مجموعهسؤال ارزیابی.
- برنامهٔ بهروزرسانی و حذف قطعههای منسوخ.
مثال ساختگی
سند «سیاست بازگشت وجه» در سه نسخه وجود دارد. هشها نشان میدهند نسخهٔ ۲ و ۳ تقریباً یکیاند. تیم نسخهٔ ۳ را معتبر اعلام میکند (valid_from امسال)، نسخههای قبلی را از نمایه خارج و آرشیو میکند، هر قطعه را با «سیاست بازگشت وجه — بخش شرایط کالا» عنوان میدهد و access_group را «عمومی» میگذارد. سندهای مرتبط با قیمتهای داخلی access_group=داخلی میگیرند. در پاسخ، «نسخهٔ ۳ — بهروزشده در تاریخ مشخص» نشان داده میشود. نتیجه در مجموعهسؤال ارزیابی با نمایه قبلی مقایسه میشود تا اثر تمیزکاری سنجیده شود.
اشتباهات رایج
- نمایهسازی هر فایل بدون مالک و مجوز.
- نگهداشتن چند نسخهٔ تکراری و منسوخ.
- گمشدن مجوز دسترسی در قطعهبندی.
- قطعههای بدون عنوان و زمینه.
- باور به اینکه یک بار نمایهسازی کافی است.
- ورود محتوای غیرقابلاعتماد و دستورهای جاسازیشده.
چکلیست
- مالک، قالب، حساسیت و مجوز استفادهٔ هر منبع ثبت شده است.
- حذف تکرار و انتخاب نسخهٔ معتبر انجام میشود.
- مجوز دسترسی به قطعهها منتقل شده و در بازیابی اعمال میشود.
- قطعهبندی بر اساس ساختار و با عنوان بخش است.
- هر قطعه شناسهٔ یکتا، نسخه، منبع و تاریخ دارد.
- محتوای ورودی از نظر دستورهای جاسازیشده بررسی میشود.
- فرایند بهروزرسانی و حذف منسوخها زمانبندی شده است.
- کیفیت با مجموعهسؤال پس از هر تغییر سنجیده میشود.
برای برنامهریزی پروژه برنامهریزی پروژه نرمافزاری و برای امنیت انتقال داده SSL و HTTPS را هم ببینید.
منابع و مراجع
- RAG preparation phase — Microsoft Learn (Azure Architecture Center).
- RAG chunking phase — Microsoft Learn (Azure Architecture Center).
- RAG chunk enrichment phase — Microsoft Learn (Azure Architecture Center).
- Introducing Contextual Retrieval — Anthropic Engineering، 2024-09-19.
- Retrieval Augmented Generation — Amazon SageMaker AI Developer Guide.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.