چرا پروژههای حرفهای چند محیط مختلف دارند؟
تصمیم مالک: هزینهٔ Staging در برابر ریسک آزمایش روی Production، چه وقت دو محیط کافی است و چه وقت سه محیط واجب میشود.
SE
11 min readSoheil Ebrahimpour
Founder & product engineer
مقالهٔ ۰۴۸ تعریف Local، Staging و Production را میدهد. این صفحه سوال مالک است: آیا واقعاً باید پول و زمان برای محیط دوم و سوم بگذارم، یا همان سرور Production برای «یک بار تست کنیم ببینیم» کافی است؟ جواب تبلیغاتی «همیشه سه محیط» نیست؛ جواب صادقانه تابع ریسک، هزینهٔ خطا، و تعداد افرادی است که به سیستم دست میزنند.
بسیاری از پروژههای تکنفره با دو محیط شروع میکنند و زنده میمانند. بسیاری از تیمهای در حال رشد هم با اصرار روی «فقط Production» اولین باگ پرداخت یا اولین ایمیل اشتباه به هزار کاربر را تجربه میکنند. تفاوت در فهم trade-off است، نه در شعار DevOps.
اینجا معیارهای تصمیم، هزینههای پنهان تست در Production، و راهنمای «کی دو محیط کافی است / کی سه محیط تقریباً واجب است» را میبینید — بدون تکرار تعریفهای ۰۴۸.
پاسخ کوتاه
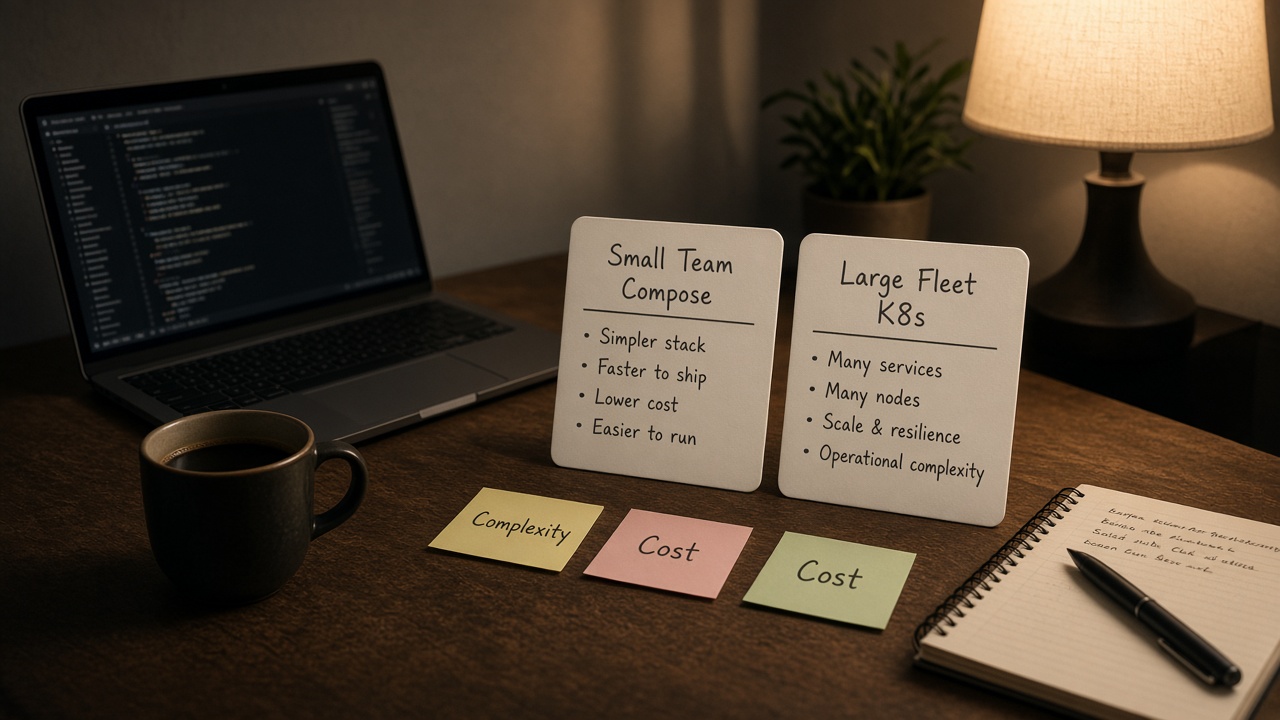
چند محیط میخرید تا هزینهٔ کشف باگ را جلوتر از چشم مشتری بیندازید. Staging پول سرور و نگهداری میگیرد؛ نبود Staging پول اعتماد، پشتیبانی، و گاهی جریمه یا از دست رفتن فروش میگیرد. وقتی خسارت یک انتشار خراب از اجارهٔ ماهانهٔ یک ماشین کوچک بیشتر شد، محیط میانی دیگر «لوکس» نیست.
پروژهٔ solo با ترافیک کم و بدون پرداخت حساس میتواند با Local + Production شروع کند، بهشرط Deploy آگاهانه و امکان Rollback سریع. بهمحض اینکه دادهٔ شخصی زیاد شد، چند نفر Deploy کردند، یا migrate/پرداخت وارد شد، هزینهٔ ریسک از هزینهٔ Staging جلو میزند.
تست در Production ارزان به نظر میرسد چون فاکتور Staging نمیآید؛ صورتحسابش را کاربر مینویسد.
هزینهٔ واقعی در برابر هزینهٔ روی فاکتور
روی فاکتور میبینید: یک VPS یا سرویس PaaS برای Staging، چند دقیقه تنظیم دامنه، چند Secret جدا. هزینهٔ پنهان نبود Staging سختتر دیده میشود:
- ساعتهای پشتیبانی وقتی ویژگی نیمهخام به همه رسید.
- از دست رفتن یک کمپین بازاریابی بهخاطر صفحهٔ خطا در ساعت اوج.
- بازیابی داده بعد از migrate برگشتناپذیر.
- زمان تیم برای عذرخواهی عمومی بهجای ساخت ویژگی بعدی.
مالک منطقی این دو سبد را با هم مقایسه میکند، نه اینکه فقط سبد «زیرساخت اضافه» را ببیند. اگر محصول شما هنوز ۲۰ کاربر دوستانه دارد، شاید سبد ریسک کوچک باشد. اگر درگاه پرداخت یا دادهٔ حساس دارید، سبد ریسک زود بزرگ میشود.
چرا «روی Production تست میکنیم» فریبنده است؟
چند استدلال رایج و پاسخ صادقانه:
- «ترافیک نداریم پس اشکال ندارد.» — ترافیک کم یعنی هر کاربر نسبتاً ارزشمندتر است؛ اولین ۱۰ مشتری اغلب مرجع معرفیاند.
- «Feature flag داریم.» — پرچم مفید است اما جایگزین جداسازی داده و Secret نیست؛ اشتباه پیکربندی پرچم هم در Production گران است.
- «Rollback سریع داریم.» — عالی؛ پس هم Rollback را نگه دارید هم Staging را وقتی پیچیدگی بالا رفت. Rollback بعد از migrate خراب یا ایمیل ارسالشده همیشه کامل نیست.
- «هزینهٔ دو برابر میشود.» — Staging لازم نیست هماندازهٔ Production باشد؛ اغلب یک ماشین کوچک یا پلن پایینتر کافی است.
نکتهٔ ظریف: بعضی آزمایشها فقط با ترافیک واقعی معنا دارند (عملکرد، نرخ تبدیل). آنها را با canary یا درصد کم کاربران طراحی کنید — نه با جایگزین کردن کل مسیر QA. این هنوز «چند محیط» است، فقط لایهٔ انتشار تدریجی به Production اضافه شده.
جدول تصمیم برای مالک
| وضعیت محصول | پیشنهاد محیط | دلیل اصلی |
|---|---|---|
| MVP تکنفره، بدون پرداخت، دادهٔ کم | Local + Production | سرعت یادگیری؛ ریسک محدود و قابل عذرخواهی |
| پرداخت یا دادهٔ شخصی وارد شد | Local + Staging + Production | اولین خطای واقعی گران است |
| بیش از یک Deployکننده | سه محیط + محدودیت دسترسی Prod | کاهش اشتباه انسانی بدون شاهد |
| چند تیم / چندبار انتشار در هفته | سه محیط + Preview/CI | پایداری سرعت انتشار |
| Solo اما با مشتری سازمانی | حداقل Staging جدا | قرارداد و اعتماد مهمتر از صرفهجویی کوچک |
چه چیزی را روی Staging باید شبیه Production کنید؟
هدف شباهت کامل نیست؛ هدف کاهش غافلگیری است. اولویتها:
- همان مسیر Build/Release تا حد ممکن — نه «از لپتاپ مستقیم» در برابر «از CI» فقط برای Prod.
- نسخهٔ مشابه سرویسهای اصلی (دیتابیس، صف) حتی اگر کوچکتر باشند.
- Secret و درگاه در حالت test؛ هرگز کلید live روی Staging بهعنوان میانبر.
- migrate یکبار روی Staging قبل از Production.
شباهت صددرصدی زیرساخت اغلب اسراف است. شباهت فرایند انتشار ارزش بیشتری دارد: اگر فقط Production از pipeline میگذرد و Staging دستی است، باز هم غافلگیری میخرید.
چه وقت دو محیط هنوز قابل دفاع است؟
اگر همهٔ اینها برقرار است، Local + Production میتواند موقتاً عقلانی باشد:
- یک نفر Deploy میکند و مسئولیت را میپذیرد.
- تغییرات کوچک و برگشتپذیرند؛ migrate پیچیده ندارید.
- پرداخت live یا دادهٔ حساس گسترده ندارید.
- میتوانید در دقیقه Rollback یا پشتیبان برگردانید.
- آگاهانه میپذیرید که بعضی باگها را مشتری اول میبیند.
این حالت «بدهی عملیاتی آگاهانه» است — مثل وام کوتاهمدت. وقتی نفر دوم برای Deploy آمد یا اولین قرارداد جدی بسته شد، بدهی را با Staging تسویه کنید؛ نه وقتی رخداد بزرگ شد.
رابطه با نقشها و رشد تیم
تا وقتی یک نفر همهکاره است، مرز محیطها در ذهنش است. وقتی نقشها جدا میشوند (محصول، توسعه، پشتیبانی)، Staging زبان مشترک تأیید میشود: «روی Staging دیدم» یعنی قبل از مشتری. بدون آن، بحثها به «روی سیستم من» برمیگردد.
مقالهٔ ۰۵۸ دربارهٔ اینکه یک نفر همهٔ نقشها را انجام بدهد بحث میکند؛ از زاویهٔ محیطها پیام این است: حتی solo حرفهای هم مرز Production را محترم میشمارد، ولی تیم در حال رشد بدون Staging زودتر به دیوار میخورد.
اشتباههای تصمیمگیری
- ساختن Staging و بعد وصل کردن همان دیتابیس Production «برای واقعی بودن».
- دادن دسترسی Deploy Production به همه چون «چابکتریم».
- نگه داشتن Staging ماهها عقبتر از Production تا دیگر شبیه نباشد.
- فرض اینکه مانیتورینگ جای پیشبینی باگ را میگیرد — مانیتورینگ بعد از آسیب هشدار میدهد.
Staging عقبافتاده خطرناکتر از نبود Staging است، چون حس امنیت کاذب میدهد. اگر بودجه ندارید محیط را بهروز نگه دارید، صریحاً بگویید «دو محیط داریم» تا کسی به کپی پوسیده اعتماد نکند.
حساب سرانگشتی هزینه در برابر ریسک
لازم نیست مدل مالی پیچیده بسازید. روی کاغذ سه عدد بگذارید:
- اجارهٔ ماهانهٔ یک Staging کوچک (یا سهم پلن PaaS).
- تخمین خسارت یک انتشار بد در ماه آینده (پشتیبانی + فروش ازدسترفته + زمان رفع).
- احتمال اینکه بدون Staging حداقل یکبار در فصل چنین انتشاری رخ دهد.
اگر حاصل ضرب احتمال در خسارت از چند ماه اجارهٔ Staging بیشتر است، تأخیر در ساخت محیط میانی تصمیم احساسی صرفهجویی است نه تصمیم مالی. برعکس، اگر محصول هنوز در حد آزمایش دوستان است، همان پول را روی یادگیری مشتری بگذارید و دو محیط را آگاهانه نگه دارید.
این حساب را هر فصل مرور کنید. چیزی که برای ماه اول MVP درست بود، بعد از اولین قرارداد سازمانی یا اتصال درگاه پرداخت عوض میشود.
ریسکهای غیر فنی که مالک میبیند
مهندس به downtime و exception فکر میکند؛ مالک به اعتماد فکر میکند. چند محیط به زبان کسبوکار یعنی:
- میتوانید به مشتری بگویید «قبل از انتشار روی محیط پیشنمایش دیدهایم».
- میتوانید پیمانکار را بدون دادن کلید Production وارد کار کنید.
- میتوانید کمپین بازاریابی را با نسخهٔ پایدار قفل کنید و آزمایشها را روی Staging نگه دارید.
نبود این مرزها هزینهٔ پنهان مذاکره میسازد: هر تغییر کوچک باید در جمعبندی ترس از «مبادا سایت بترکد» تصویب شود. Staging ترس را کم میکند تا سرعت تصمیم بالا برود — همان چیزی که چابکی واقعاً به آن نیاز دارد.
آیا Feature Flag جایگزین Staging است؟
خیر — مکمل است. Feature flag اجازه میدهد کد در Production باشد اما برای درصد کمی از کاربران روشن شود. عالی برای آزمایش محصول و canary. اما flag اشتباه پیکربندیشده، دادهٔ واقعی را درگیر میکند؛ migrate را جبران نمیکند؛ و Secret یا دسترسی Deploy را جدا نمیکند.
ترکیب سالم در تیمهای بالغ: Build یکسان، Staging برای مسیر بحرانی و migrate، سپس Production با flag برای آزمایشهای محصولی. اگر فقط flag دارید و هیچ محیط میانی ندارید، هنوز همهٔ تخممرغها در سبد Production است.
مسیر رشد پیشنهادی بدون اسراف
- هفتههای اول: Local + Production، Deploy دستی مستند، Backup روشن.
- ورود پرداخت یا نفر دوم: Staging کوچک هممسیر با Production، Secret جدا.
- انتشار پرتکرار: CI برای Build، تأیید کوتاه قبل از Prod، بعداً Preview per-PR اگر درد هماهنگی دیدید.
- رشد بیشتر: مانیتورینگ، on-call، و محیطهای تخصصی فقط وقتی درد واقعی دارید نه از روی کاتالوگ ابزار.
هر پله را وقتی درد یا ریسک توجیه کرد بردارید. خریدن همهٔ پلهها در روز اول برای یک فروشگاه کوچک معمولاً اتلاف است؛ نخریدن پلهٔ Staging بعد از ورود پول واقعی معمولاً قمار است.
نشانههای دیرکردن در افزودن Staging
اگر چند مورد زیر را در ماه اخیر دیدهاید، احتمالاً از نقطهٔ بهینهٔ «دو محیط» عبور کردهاید:
- بیش از یکبار عذرخواهی عمومی یا جبران برای کاربر بهخاطر انتشار.
- ترس از Deploy باعث انباشت تغییرهای بزرگ و پرریسک شده است.
- دیباگ فقط با اتصال مستقیم به Production ممکن شده.
- نفر دوم بدون نظارت کامل به Prod دسترسی Deploy گرفته.
- migrate یا تغییر پرداخت بدون هیچ پیشنمایش واقعی رفته است.
در این وضعیت ساخت Staging دیگر پروژهٔ بزرگ نیست؛ یک ماشین کوچک، دامنه، Secret جدا، و اجبار به عبور Release از آن قبل از Prod کافی است تا روند ترس را برگرداند. کمال زیرساخت را به فاز بعد بگذارید.
مخالفتهای بودجهای و پاسخهای کوتاه
«هزینه دو برابر میشود.» — Staging هماندازه لازم نیست؛ اغلب کسری از Production کافی است.
«زمان تیم را میگیرد.» — یکبار راهاندازی در برابر هر بار جنگ اتاق فرمان بعد از انتشار خراب؛ زمان خالص معمولاً به نفع Staging است.
«مشتری نداریم که بترسیم.» — پس دو محیط را نگه دارید؛ ولی همان لحظه که مشتری پرداختکننده آمد، تصمیم را از نو بگیرید نه سه ماه بعد.
«ابزارهای بزرگ لازم است.» — لازم نیست؛ تعریف محیط، جداسازی داده و Secret، و یک مسیر Deploy تکراری حداقلِ حرفهای است.
جمعبندی میانی برای بنیانگذار غیرتکنیکال
از شما انتظار نمیرود Kubernetes بخرید تا «حرفهای» به نظر برسید. از شما انتظار میرود بپرسید: اگر امشب انتشار خراب شود، آیا جایی غیر از چشم مشتری برای دیدن آن داشتیم؟ اگر جواب مکرراً نه باشد، بودجهٔ Staging را در اولویت بگذارید — حتی اگر به قیمت یک ویژگی عقب بیفتد. ویژگی روی سیستم بیثبات، بازاریابی روی بدهی است.
از خجالت هزینه تا خجالت رخداد
بنیانگذارها گاهی از «خرج اضافه برای سروری که مشتری نمیبیند» خجالت میکشند. بعد از اولین رخداد عمومی، خجالت جایش را به سوال سختتر میدهد: چرا پیشنمایش نداشتیم؟ روایت سالم برای سرمایهگذار یا شریک این است که Staging بیمهٔ ارزان انتشار است، نه اسباببازی مهندس.
اگر بودجهٔ امسال واقعاً صفر است، حداقل معادل Staging را با انضباط بسازید: شاخهٔ release، چکلیست دستی دو نفره، و ممنوعیت آزمایش روی دادهٔ مشتری. این هنوز «چند لایهٔ کنترل» است حتی اگر سرور جدا نخریده باشید. به محض امکان مالی، آن انضباط را روی محیط واقعی سوار کنید تا به حافظهٔ افراد وابسته نماند.
در نهایت معیار موفقیت تعداد محیطها نیست؛ کاهش غافلگیری برای کاربر است. هر ساختاری که این غافلگیری را جلوتر از Production میآورد — حتی اگر اسمش Staging نباشد — در جهت درست است. هر ساختاری که فقط حس امنیت میدهد بدون همترازی و دادهٔ امن، هزینه بدون فایده است.
جمعبندی برای تصمیم
چند محیط میخرید تا یادگیری و شکست را جایی انجام دهید که مشتری هزینه ندهد. هزینهٔ Staging معمولاً خطی و قابل پیشبینی است؛ هزینهٔ تست خام روی Production نامنظم و گاهی وجودی است. Solo میتواند با دو محیط شروع کند؛ حرفهای شدن یعنی قبل از اینکه ریسک از کنترل خارج شود، لایهٔ میانی را اضافه کنید.
اگر امروز باید یک تصمیم بگیرید: فهرستی از بدترین سه رخداد انتشار هفتهٔ گذشته یا محتمل را بنویسید و بپرسید کدامها با یک بار دیدن روی Staging ارزانتر تمام میشدند. همان فهرست بودجهٔ Staging شماست.
منابع و مراجع
- The Twelve-Factor App — III. Config (جدا بودن config بین Deployها؛ پایهٔ فکری چند Deploy) — https://12factor.net/config
تعریف عملی محیطها در ۰۴۸ و مسیر Build/Release/Run در ۰۵۰ مکمل این تصمیماند.
Author
SE
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.