

حافظه و Swap در لینوکس: free، OOM و تصمیمگیری درست
خواندن free -h، تفاوت available و free، نقش buff/cache، Swap، swappiness و رفتار OOM Killer وقتی RAM تمام میشود.
Founder & product engineer
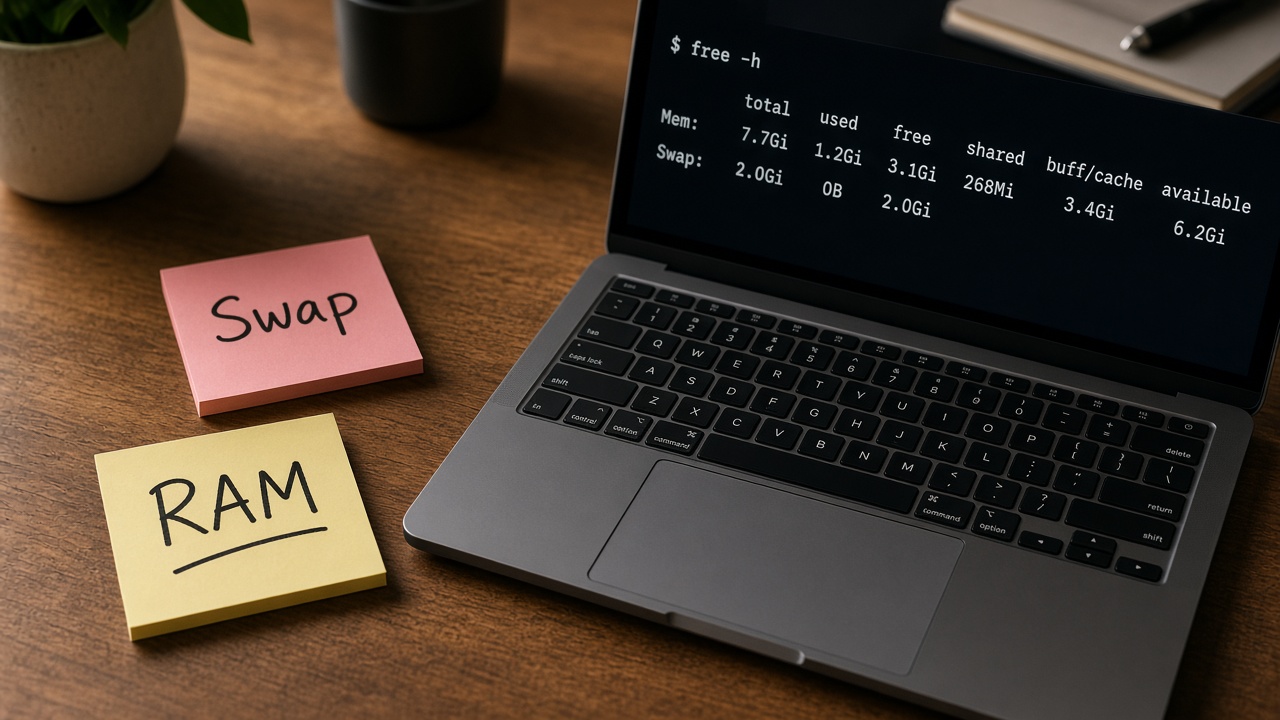
مانیتورینگ میگوید RAM پر است، در حالی که سرور روان کار میکند؛ یا برعکس، `free` مقدار زیادی نشان میدهد ولی اپلیکیشنها کند شدهاند و OOM Killer پروسس را کشته. در لینوکس «پر بودن حافظه» اغلب به معنی استفادهٔ سالم از cache است، نه لزوماً بحران. بدون تفکیک free، available، buff/cache و swap، تصمیمهای اشتباه میگیرید: Swap را بیدلیل حذف میکنید یا اپ را زود scale میکنید.
این مطلب معنی اعداد را روشن میکند، فشار حافظه را از cache سالم جدا میکند، و مسیر واکنش به OOM را میچیند.
پاسخ کوتاه
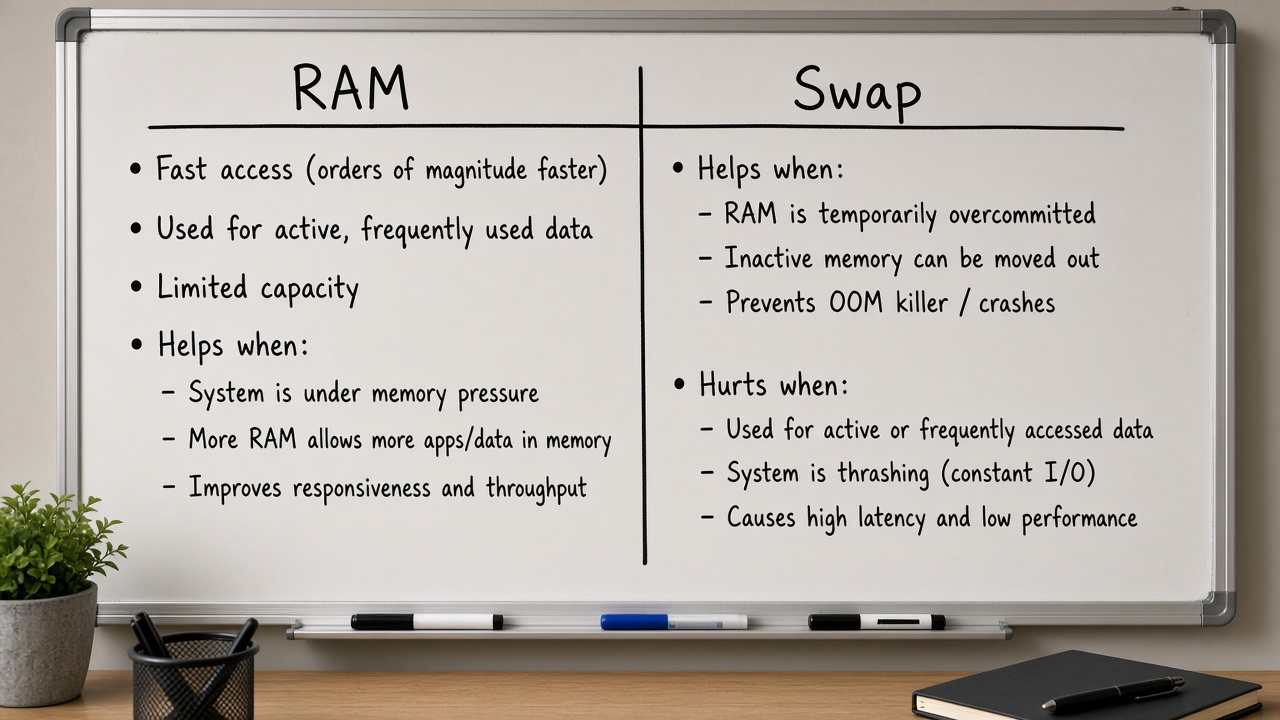
به ستون `available` در `free -h` اعتماد کنید نه فقط `free`. buff/cache معمولاً قابلبازپسگیری است. Swap بالشتک در برابر اسپایک است نه جایگزین RAM. وقتی فشار واقعی است، ابتدا پروسس پرمصرف را با `ps`/`top` پیدا کنید؛ اگر کرنل OOM کرد، dmesg/journal را بخوانید. swappiness را فقط با فهم بار کاری عوض کنید.
حافظهٔ خالیِ بیاستفاده هدررفت است؛ کرنل ترجیح میدهد صفحه را برای cache نگه دارد تا دیسک کمتر خوانده شود.
مدل ذهنی: RAM چه کار میکند؟
صفحات حافظه برای کد پروسس، heap، صفحهٔ فایلهای mmapشده، و cache صفحات فایلسیستم مصرف میشوند. وقتی فایلی را میخوانید، کرنل کپی را در page cache نگه میدارد تا خواندن بعدی سریعتر باشد. اگر اپ جدید به RAM نیاز داشته باشد، کرنل میتواند صفحات cache تمیز را آزاد کند — به همین دلیل `available` مهمتر از `free` است.
- Anon memory: حافظهٔ اختصاصی پروسس (heap و مشابه) که روی دیسک فایل پشتیبان ندارد مگر Swap.
- File-backed / cache: قابلبازپسگیری بدون از دست دادن دادهٔ پروسس (محتوا روی دیسک هست).
- Buffers: اغلب مرتبط با بلوکهای متادیتا؛ در خروجی free معمولاً با cache جمع میشود.
خواندن free و /proc/meminfo
bash
free -h cat /proc/meminfo | head -n 20 swapon --show
در `free -h` مدرن:
- total: ظرفیت فیزیکی.
- used: تقریبیِ در حال استفاده (تعریف بسته به نسخهٔ procps کمی فرق دارد).
- free: کاملاً استفادهنشده — اغلب کوچک است و این بهتنهایی بد نیست.
- buff/cache: حافظهٔ قابلاستفادهٔ مجدد برای cache.
- available: تخمین کرنل از حافظهای که بدون شروع swap سنگین به کاربر جدید داده میشود — معیار عملیاتی اصلی.
اگر available پایین است و swap در حال پر شدن یا si/so در `vmstat` بالاست، فشار واقعی دارید. اگر free کم ولی available بالاست، سیستم سالم cache میکند.
Swap چیست و چه وقت مفید است؟
Swap فضای روی دیسک (پارتیشن یا فایل) است که کرنل صفحات کمترفعال را آنجا مینویسد تا RAM برای کار فوری آزاد شود. مزیت: جلوگیری از OOM در اسپایکهای کوتاه و جا برای cache بیشتر. هزینه: تأخیر زیاد نسبت به RAM؛ اگر کاری دائماً از Swap بخواند، thrashing میشود و همه چیز کند میگردد.
روی سرورهای کوچک ابری، داشتن کمی Swap (مثلاً ۱–۲ برابر RAM کوچک، با سقف معقول) اغلب بهتر از صفر است — به شرط مانیتورینگ. روی گرههای latency-critical گاهی Swap را کم یا صفر میگذارند تا شکست سریعتر و واضحتر از کندی پنهان باشد؛ این انتخاب معماری است نه قانون مطلق.
bash
sudo fallocate -l 2G /swapfile # نمونه؛ روی برخی FSها dd ترجیح داده میشود # سپس chmod 600، mkswap، swapon و ورود به fstab — فقط با درک پیامدها
swappiness و تنظیمات vm
`vm.swappiness` (۰ تا ۱۰۰) تمایل کرنل به بازپسگیری anon از طریق Swap در برابر بازپسگیری file cache را تنظیم میکند. مقدار پیشفرض بسیاری از توزیعها ۶۰ است؛ برای دسکتاپ/سرور عمومی گاهی کمتر (مثلاً ۱۰–۲۰) پیشنهاد میشود تا Swap دیرتر وارد شود. صفر به معنی «هرگز Swap نکن» نیست همیشه؛ رفتار دقیق به نسخهٔ کرنل وابسته است. تغییر را با بار واقعی بسنجید نه با کپی کور وبلاگ.
bash
sysctl vm.swappiness cat /proc/sys/vm/swappiness
پیدا کردن مصرفکنندهٔ حافظه
bash
ps aux --sort=-%mem | head ps -eo pid,user,rss,comm --sort=-rss | head smem -t 2>/dev/null || true
RSS تقریبی از صفحات مقیم در RAM است و با جمع سادهٔ همهٔ پروسسها بهخاطر صفحات مشترک (shared libraries) بیشبرآورد میشود. برای جاوا/Node، heap داخل پروسس را جدا ببینید؛ گاهی «نشت حافظهٔ اپ» است نه «کرنل بد». cgroup و کانتینر محدودیت جدا دارند: ممکن است OOM داخل کانتینر رخ دهد در حالی که میزبان هنوز available دارد.
OOM Killer چه میکند؟
وقتی تخصیص حیاتی شکست میخورد و بازپسگیری کافی نیست، کرنل ممکن است پروسسی را بکشد تا سیستم زنده بماند. انتخاب بر اساس امتیاز OOM است (حافظه مصرفی، nicely، و تنظیمات). نشانه: در `dmesg` یا journal پیامهایی شبیه Killer و نام پروسس قربانی. واکنش: علت مصرف را رفع کنید (باگ، محدودیت نادرست، ظرفیت کم)، نه اینکه فقط Swap را بینهایت بزرگ کنید.
bash
sudo dmesg -T | rg -i 'oom|killed process' | tail sudo journalctl -k -b | rg -i 'oom|out of memory' | tail
جدول تفسیر سریع
| مشاهده | معنی محتمل | اقدام |
|---|---|---|
| free کم، available بالا | cache سالم | نیازی به وحشت نیست |
| available کم، swap کماستفاده | فشار در حال شکلگیری | پروسسها و روند رشد را ببینید |
| si/so مداوم در vmstat | فشار فعال روی Swap | RAM یا مصرف را اصلاح کنید |
| OOM در لاگ | تخصیص شکست خورده | قربانی و مقصر را تحلیل کنید |
| کانتینر Kill، میزبان آزاد | حد cgroup | limits کانتینر را بازبینی کنید |
اشتباههای رایج
- تفسیر «RAM پر» فقط از روی used یا free بدون available.
- غیرفعال کردن کامل Swap روی VPS کوچک بدون جایگزین مانیتورینگ و ظرفیت.
- افزایش swappiness برای «سرعت» در حالی که دیسک کند است.
- جمع کردن RSS همهٔ پروسسها و نتیجهگیری قطعی دربارهٔ نشت.
- نادیده گرفتن محدودیتهای Kubernetes/Docker و سرزنش میزبان.
چه زمانی RAM بخرید؟
اگر پس از بستن نشتها و تنظیم cache/اپ، available در اوج بار کاری پایدار پایین میماند و latency بد میشود، ارتقای RAM یا تقسیم بار منطقی است. اگر فقط در بکاپ شبانه اسپایک دارید، زمانبندی و محدودیت همزمانی ارزانتر از ارتقای همیشگی است.
مثال خواندن خروجی free
فرض کنید `total` برابر ۳٫۸Gi، `used` حدود ۲٫۱Gi، `free` فقط ۲۰۰Mi، `buff/cache` حدود ۱٫۵Gi و `available` حدود ۱٫۶Gi است. این تصویر اغلب سالم است: کرنل cache نگه داشته و هنوز برای تخصیص جدید جا تخمین میزند. حال اگر `available` به ۱۵۰Mi برسد و `Swap used` در حال صعود باشد، وقت اقدام است: پیدا کردن پروسس، بررسی نشت، یا افزایش ظرفیت.
در `vmstat 1 5` ستونهای `si` و `so` نشان میدهند همین حالا صفحه به Swap میرود یا برمیگردد. چند نمونهٔ تکرقمی گهگاه کمتر نگرانکننده از جریان مداوم زیر بار پایدار است.
محدودیت حافظه در systemd و کانتینر
واحد systemd میتواند `MemoryMax` داشته باشد و قبل از فشار کل میزبان، خودش OOM شود. در Kubernetes همین نقش را limit پاد بازی میکند. وقتی فقط میزبان را با free میبینید ممکن است سرویس داخل cgroup در حال Kill شدن باشد. همیشه لایهٔ محدودیت را در تشخیص وارد کنید: `systemctl show` برای خواص حافظه، و متریکهای runtime کانتینر.
bash
systemctl show some.service -p MemoryMax -p MemoryCurrent 2>/dev/null | cat cat /sys/fs/cgroup/memory.max 2>/dev/null || true
Transparent Huge Pages و بارهای خاص
برخی پایگاههای داده نسبت به THP حساساند و توصیههای فروشنده دارند. این موضوع جایگزین فهم available/swap نیست، ولی یادآوری میکند تنظیمات پیشفرض کرنل برای همهٔ بارها بهینه نیست. هر تغییر sysctl را مستند و برگشتپذیر نگه دارید.
ظرفیتسنجی حافظه برای سرویسهای رایج
برای یک API ساده، عدد RSS در حالت بیکار و زیر بار مصنوعی را اندازه بگیرید و ضریب رشد را حساب کنید. برای JVM، اندازهٔ heap را با محدودیت کانتینر همتراز کنید تا GC و OOM با هم نجنگند. برای Redis یا Memcached، حداکثر حافظه را صریح بگذارید؛ وگرنه کش دوستداشتنی کل ماشین را میبلعد. ظرفیتسنجی یعنی دانستن سقف عمدی، نه امید به اینکه «فعلاً کم است».
هنگام مهاجرت به نمونهٔ کوچکتر ابری، اول available را زیر اوج بار ببینید نه میانگین شبانهروز. میانگین میتواند گمراهکننده باشد اگر اوج روزانه کوتاه ولی مرگبار باشد. تست بار کوتاه با نمایهٔ واقعی (نه فقط hello world) جلوی غافلگیری را میگیرد.
اگر مجبورید بین افزودن Swap و افزودن RAM انتخاب کنید، برای بارهای latency-sensitive معمولاً RAM برنده است و Swap فقط بالشتک اضطراری میماند. برای بچجابهای شبانه، Swap بیشتر میتواند موقت قابل قبول باشد به شرطی که مانیتورینگ thrashing داشته باشید و کاربر تعاملی روی همان گره نباشد.
مستند کنید چه پروسسهایی «اجازه دارند» بزرگ شوند و کدامها باید با cgroup محدود شوند. بدون این قرارداد اجتماعی، هر سرویس جدید تا جایی رشد میکند که همسایهها OOM شوند.
چکلیست واکنش به فشار حافظه
وقتی available پایین است: ۱) تأیید کنید متریک مال همان ماشین و همان cgroup است. ۲) فهرست پروسسها را بر اساس RSS مرتب کنید و صاحب هر کدام را پیدا کنید. ۳) ببینید رشد اخیر است یا از boot همینطور بوده. ۴) لاگ OOM و restartهای systemd را چک کنید. ۵) تصمیم بگیرید: محدود کردن سرویس، رفع نشت، یا افزایش ظرفیت. عجله برای drop_caches یا reboot بدون ثبت شواهد، یادگیری را میسوزاند و حادثه را تکرارپذیر میکند.
بعد از حادثه، یک یادداشت کوتاه بنویسید: چه چیزی available را خورد، چه آستانهای دیر بود، و چه تغییری در مانیتورینگ یا limit اعمال شد. همین یادداشتها بیش از هر اسلاید آموزشی از تکرار جلوگیری میکنند. اگر کانتینر بوده، limit و request را در مخزن استقرار بهروز کنید تا فردا دوباره با پیشفرض نامحدود بالا نیاید.
در محیطهای مشترک، قرارداد «هر سرویس سقف دارد» را به سیاست تبدیل کنید. بدون سقف، گفتگو دربارهٔ بهینهسازی معمولاً بعد از نیمهشب و بعد از Kill شدن پروسس درست شروع میشود — دیر.
خلاصه
حافظه در لینوکس یک استخر پویا است: cache دوست است تا وقتی available نفس بکشد. Swap بالشتک است نه انبار اصلی. OOM سیگنال ظرفیت یا باگ است. با free -h، meminfo، top و لاگ کرنل تصمیم بگیرید نه با حس «عدد used بزرگ است».
سوالات متداول
آیا باید buff/cache را دستی خالی کنم؟
بهندرت. drop_caches برای آزمایش است؛ در تولید معمولاً مشکل را پنهان یا I/O را بدتر میکند. ریشه را پیدا کنید.
Swapfile بهتر است یا پارتیشن؟
هر دو کار میکنند. پارتیشن کلاسیک و ساده است؛ فایل انعطاف تغییر اندازه دارد. اولویت با عملکرد دیسک و مستندسازی است.
چرا بعد از کشتن پروسس هنوز available پایین است؟
ممکن است پروسسهای دیگر جای آن را پر کرده باشند، slab/cache خاص آزاد نشده، یا هنوز به اندازهگیری دوباره نیاز دارید. چند ثانیه صبر و دوباره free را ببینید.
منابع و مراجع
- free(1) — Display amount of free and used memory: https://man7.org/linux/man-pages/man1/free.1.html
- proc(5) — /proc/meminfo: https://man7.org/linux/man-pages/man5/proc.5.html
- Linux admin-guide sysctl vm (swappiness): https://docs.kernel.org/admin-guide/sysctl/vm.html
- vmstat(8) for si/so columns: https://man7.org/linux/man-pages/man8/vmstat.8.html
- Kernel OOM killer documentation (admin-guide/mm/oom.rst family)
Author
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.




