چه چیزی یک محصول نرمافزاری را Production-Ready میکند؟
AuthZ، خطاها، observability، backup، امنیت، تست، deploy، rollback، دسترسیپذیری، SEO و ops — فراتر از demo سبز.
SE
9 min readSoheil Ebrahimpour
Founder & product engineer

«Production-ready» برچسبی است که زیاد استفاده میشود و کم تعریف میشود. برای بعضی یعنی «روی سرور واقعی است»؛ برای بعضی دیگر یعنی «میتوانیم شبها بخوابیم». در عمل، محصولی production-ready است که بتوان آن را با امنیت قابل دفاع، خطای قابلفهم، مشاهدهپذیری، پشتیبان، تست معنادار، استقرار تکرارپذیر، rollback، دسترسیپذیری، SEO پایه (جایی که معنا دارد)، و عملیات پایدار نگه داشت — نه فقط اینکه featureها در demo سبز به نظر برسند.
این یادداشت چکلیست تشریفاتی نیست. مجموعهای از قابلیتهای بههمپیوسته است که FutureForge هنگام سختسازی محصول برای محیط واقعی روی آنها کار میکند.
احراز هویت و مجوزدهی (AuthN / AuthZ)
بیشتر حوادث جدی وباپها از «نداشتن رمزنگاری پیشرفته» نیست؛ از broken access control است. OWASP Top 10 سالهاست این الگو را در صدر یا نزدیک صدر نگه میدارد: کاربر نباید به داده یا عملی برسد که برایش مجاز نیست — حتی اگر URL را حدس بزند، ID را عوض کند، یا نقش UI را دور بزند.
production-ready یعنی:
- احراز هویت استاندارد و مدیریت session/token درست
- مجوزدهی در سرور enforce شود، نه فقط در UI
- مدل tenancy و ownership در queryها صریح باشد
- سطوح admin جدا، محدود، و قابل audit باشند
«بعداً AuthZ را درست میکنیم» یکی از گرانترین وعدههاست؛ چون داده و API اطراف همان مدل اشتباه شکل میگیرند.
خطاها: برای انسان و برای سیستم
خطای خوب دو مخاطب دارد. برای کاربر: پیام واضح، قابل اقدام، بدون افشای جزئیات داخلی. برای تیم: log ساختاریافته، correlation id، و context کافی برای بازتولید.
در production، stack trace خام در پاسخ API نشانهٔ «شفافیت» نیست؛ نشانهٔ ناپختگی و ریسک امنیتی است. همچنین سکوت کامل وقتی عملیات شکست میخورد — بدون کد خطا، بدون id پیگیری — پشتیبانی را کور میکند.
استراتژی خطا باید بین transient failure (قابل retry) و permanent failure فرق بگذارد، و برای عملیات مالی یا حساس از idempotency حمایت کند.
Observability: دیدن قبل از حدس زدن
بدون observability، production فقط یک جعبهٔ سیاه است که گاهی ticket میدهد. حداقل عملی:
- logs متمرکز و قابل جستجو
- metrics برای latency، error rate، و saturation
- tracing برای مسیرهای حیاتی بین سرویسها یا لایهها
- alerting که به انسان بگوید چه باید بکند
کتاب Site Reliability Engineering گوگل روی مفاهیم SLI، SLO و error budget تأکید میکند: قابلیت اطمینان هدف طراحی است، نه حادثهای که بعداً مدیریت میشود. لازم نیست همه چیز Google-scale باشد؛ لازم است بدانید «سالم بودن» برای محصول شما چه معنایی دارد و وقتی از آن منحرف میشوید خبردار شوید.
پشتیبان و بازیابی
backup بدون تست restore فقط حس امنیت میدهد. برای دادههای حیاتی مشخص کنید:
- چه چیزی backup میشود و با چه تناوبی
- RPO و RTO قابل قبول چیست
- چه کسی و چگونه restore را تمرین کرده است
- رمزنگاری و دسترسی به backup چگونه کنترل میشود
محصولی که featureهای زیبا دارد اما مسیر بازیابی داده ندارد، در برابر یک اشتباه انسانی یا خرابی دیسک production-ready نیست.
امنیت سطح محصول
امنیت production فراتر از HTTPS است. شامل مدیریت secret خارج از repo، بهروزرسانی وابستگیها، محدود کردن سطح حمله، rate limiting روی endpointهای عمومی، و بازبینی ورودیهاست. misconfiguration — دسترسی باز storage، debug mode در production، CORS بیحد — بارها بیشتر از حملات پیچیده آسیب زده است.
برای surfaceهای authenticated و admin، بازبینی منظم روی IDOR، privilege escalation، و file access ضروری است. security یک فاز پایانی نیست؛ بخشی از Definition of Done برای مسیرهای پرریسک است.
تست: اعتماد برای release
هدف تست coverage عددی نیست؛ هدف اعتماد برای deploy است. هرم کلاسیک هنوز مفید است: unit برای منطق، integration برای مرزها، e2e برای مسیرهای حیاتی. بدون تست روی auth، پرداخت، و migration داده، هر انتشار یک قمار است.
تستهای production-minded همچنین شامل smoke بعد از deploy و چکهای سلامت میشوند. اگر تنها راه فهمیدن خرابی، پیام کاربر در شبکههای اجتماعی باشد، حلقهٔ بازخورد شما شکسته است.
استقرار تکرارپذیر
استقرار دستی روی سرور «چون همیشه کار کرده» مقیاسپذیر و قابل audit نیست. production-ready یعنی pipeline یا حداقل script تکرارپذیر برای build، migrate، و release — با جداسازی محیطها و مدیریت config.
migration دیتابیس باید با نسخهٔ اپ هماهنگ باشد و مسیر سازگاری عقبرو یا جلورو مشخص داشته باشد. deploy بدون مالکیت migration یکی از منابع کلاسیک outage است.
Rollback و مدیریت تغییر
توانایی رفتن به جلو بدون توانایی برگشتن، شجاعت نیست؛ شکنندگی است. قبل از release جدی بدانید:
- چگونه نسخهٔ قبلی را برمیگردانید
- migrationهای برگشتپذیر یا استراتژی expand/contract چیست
- چه کسی تصمیم rollback را میگیرد و در چه شرایطی
feature flagها و releaseهای تدریجی ریسک را کم میکنند، اما جایگزین rollback plan نیستند.
دسترسیپذیری (a11y)
محصولی که فقط با موس و بینایی کامل قابل استفاده است، بخشی از کاربران واقعی را حذف میکند — و در بسیاری از بازارها الزامات قانونی یا قراردادی دارد. حداقلهای عملی: ساختار معنایی، کنتراست، فوکوس کیبورد، برچسب فرمها، و پیامهای خطا قابل درک برای screen reader.
a11y را به «فاز زیبایی» موکول نکنید؛ اصلاح دیرهنگام گرانتر از رعایت پایه در کامپوننتهای اصلی است.
SEO و قابلیت کشف (جایی که معنا دارد)
برای محصولات محتوایی و صفحات عمومی، production-ready شامل metadata درست، ساختار heading، عملکرد قابل قبول، و URLهای پایدار هم هست. SEO جادو نیست؛ نتیجهٔ HTML معنادار، سرعت، و محتوای واقعی است. برای پنلهای کاملاً خصوصی پشت لاگین، اولویت با SEO عمومی نیست — اما حتی آنجا metadata و اشتراکگذاری کنترلشده گاهی مهم است.
عملیات: نفر بعدی که ساعت ۳ صبح بیدار میشود
ops یعنی runbook کوتاه برای حوادث رایج، دسترسی اضطراری کنترلشده، وابستگیهای شناختهشده، و کانال ارتباطی مشخص. محصولی که فقط سازندهاش میتواند درستش کند، از نظر سازمانی fragile است.
رویههای on-call لازم نیست پیچیده باشند؛ باید واقعی باشند: چه چیزی را چک کنیم، کجا log است، چگونه rollback کنیم، چه کسی را بیدار کنیم.
عملکرد و ظرفیت: سریع کافی در شرایط واقعی
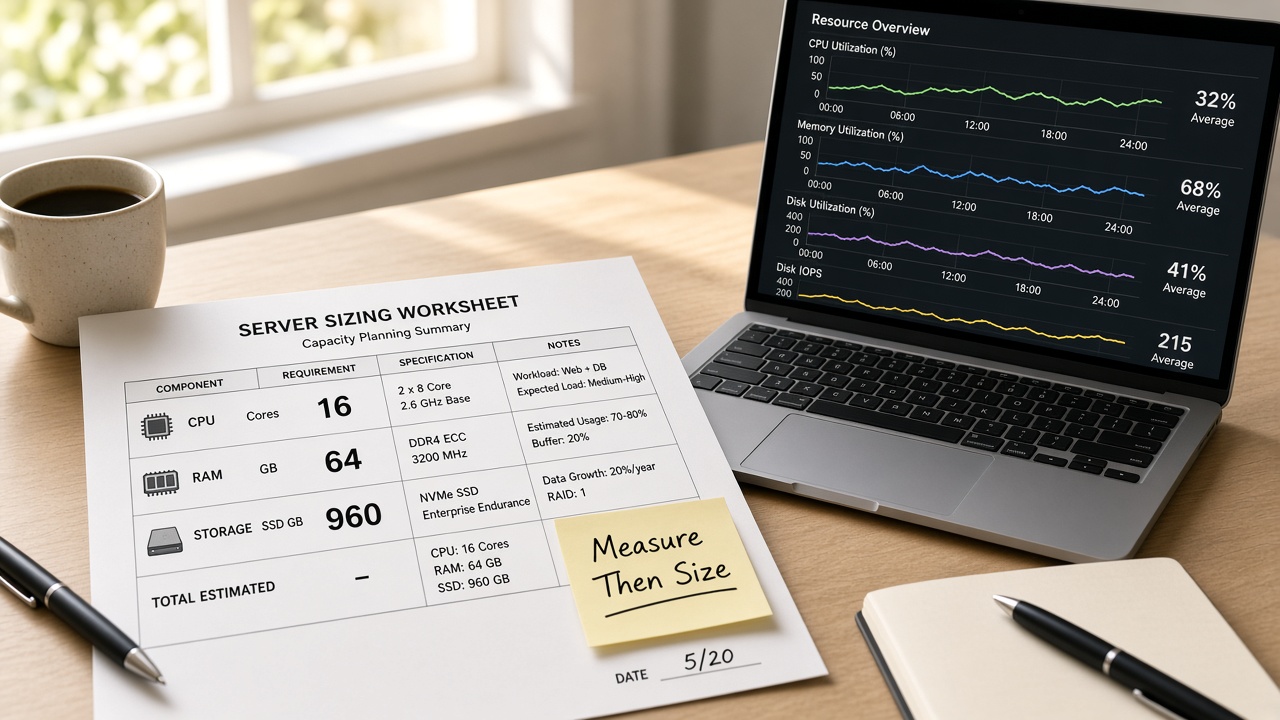
Production-ready بودن فقط «کار میکند» نیست؛ یعنی در بار و شرایط واقعی هم قابل استفاده میماند. لازم نیست از روز اول برای میلیونها کاربر طراحی کنید، اما باید برای مسیرهای حیاتی بودجهٔ عملکرد داشته باشید: صفحهٔ ورود، checkout، جستجو، یا هر آنچه کسبوکار روی آن میچرخد.
اندازهگیری قبل از بهینهسازی نمایشی ضروری است. بدون baseline، هر تغییر «بهینهسازی» فقط داستان است. timeoutها، pagination، و محدودیت اندازهٔ payload تصمیمهای سادهای هستند که از بسیاری از outageهای خاموش جلوگیری میکنند.
پیکربندی، secretها و محیطها
تفاوت محیط development و production اگر مدیریت نشود، خودش منبع باگ میشود. config باید از کد جدا باشد، secretها در repo نباشند، و تفاوتهای محیطی مستند و حداقلی باشند. Twelve-Factor در این بخش هنوز راهنمای عملی است.
همچنین مشخص کنید چه کسی به production دسترسی دارد، چگونه تغییر config audit میشود، و آیا امکان «تنظیم اشتباه با یک کلیک» وجود دارد. بسیاری از حوادث امنیت و پایداری از privilege بیشازحد و تغییر بدون ردپا میآیند.
چکلیست آزادسازی: قبل از اعلام آماده بودن
قبل از اینکه محصول را production-ready اعلام کنید، حداقل این پرسشها را جدی جواب دهید:
- آیا مسیرهای حیاتی تست و مشاهده میشوند؟
- آیا backup و restore تمرین شده است؟
- آیا rollback در کمتر از یک پنجرهٔ قابل قبول ممکن است؟
- آیا دسترسیها و سطح حمله بازبینی شدهاند؟
- آیا نفر دوم میتواند با runbook مختصر سیستم را پشتیبانی کند؟
اگر پاسخ چند مورد «هنوز نه» است، محصول ممکن است قابل demo باشد — اما برای اعتماد عملیاتی زود است. صادق بودن دربارهٔ این فاصله، بخشی از حرفهای بودن Product Engineering است.
مستندسازی operability، نه wiki بیانتها
مستندات production-ready لزوماً دانشنامه نیست. معمولاً چند صفحهٔ زنده کافی است: معماری خلاصه، وابستگیهای خارجی، نحوهٔ deploy و rollback، محل logs/metrics، و تماسهای escalation. سندی که کسی نمیخواند و بهروز نمیشود، ارزش عملیاتی ندارد.
هر بار که حادثهای رخ میدهد و runbook ناقص است، همان جا را تکمیل کنید. این حلقهٔ یادگیری همان چیزی است که SRE جدی از آن حرف میزند: قابلیت اطمینان از تمرین و بازخورد ساخته میشود، نه از شعار.
مرز بین MVP و production-ready
MVP میتواند scope کوچک داشته باشد و همچنان در مسیرهای برگشتناپذیر production-minded باشد. تفاوت در این است که MVP همهٔ قابلیتها را ندارد؛ نه اینکه auth شل، بدون backup، و بدون راه برگشت از deploy باشد. اگر فرضیه validate شد، مسیر سختسازی باید از قبل نیمهآماده باشد — نه اینکه از صفر شروع شود.
FutureForge معمولاً این مرز را صریح با مشتری میگذارد: چه چیزی برای یادگیری کافی است، و چه چیزی برای نگهداری پایدار لازم است. قاطی کردن این دو، یا محصول را شکننده launch میکند یا scope را بیدلیل متورم میکند.
در نهایت، production-ready یک وضعیت باینری مطلق نیست؛ یک آستانهٔ اعتماد است که باید با ریسک کسبوکار همخوان باشد. محصول پرداخت یا دادهٔ سلامت آستانهٔ بالاتری از یک ابزار داخلی کمریسک میخواهد — اما هیچکدام نباید بدون مشاهدهپذیری و راه برگشت وارد محیط واقعی شوند.
جمعبندی
Production-ready بودن یعنی محصول در محیط واقعی قابل دفاع، قابل مشاهده، قابل بازیابی، و قابل تغییر کنترلشده است. AuthZ، خطاها، observability، backup، امنیت، تست، deploy، rollback، a11y، SEO، و ops لایههایی هستند که با هم یک سیستم قابل اتکا میسازند. Feature بدون این لایهها demo است. محصول وقتی production-ready است که بتوانید آن را نگه دارید — نه فقط رونمایی کنید.
منابع و مراجع
- OWASP Top 10 — OWASP Foundation
- Site Reliability Engineering — Google / O'Reilly
- Web Content Accessibility Guidelines (WCAG) 2.2 — W3C
- DORA Research — Google Cloud
Author
SE
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.