Monitoring چیست؟ پایش سلامت سیستم با متریک و هشدار
مانیتورینگ یعنی اندازهگیری پیوستهٔ رفتار سیستم با متریک و هشدار — با مفاهیم OpenTelemetry و Prometheus برای تصمیم عملی تیم.
SE
6 min readSoheil Ebrahimpour
Founder & product engineer
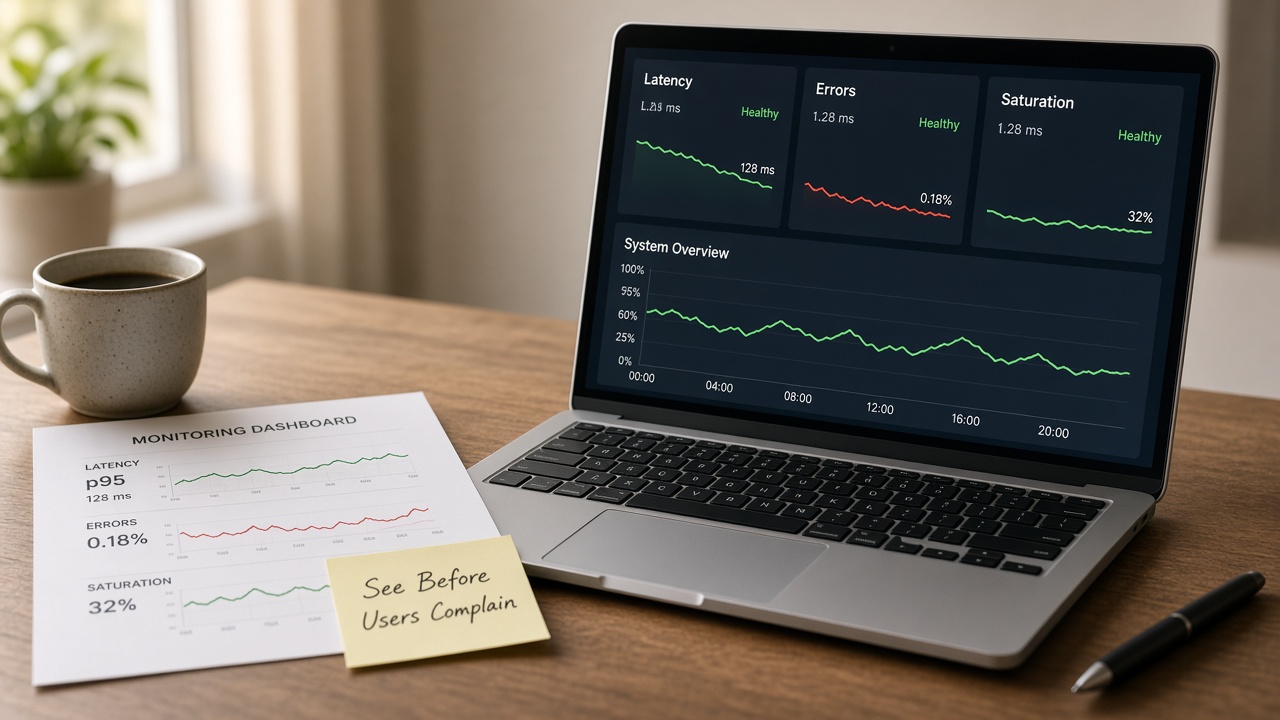
Monitoring (مانیتورینگ یا پایش) یعنی بهصورت پیوسته نشانههای عددی و وضعیت سیستم را جمع کنید تا بفهمید سرویس از نگاه کاربر درست کار میکند یا نه — و وقتی از آستانه رد شد، هشدار بدهید. بدون پایش، از خرابی معمولاً اولینبار از پیام کاربر یا سکوت فروش باخبر میشوید.
OpenTelemetry مشاهدهپذیری (Observability) را توانایی فهم وضعیت درونی سیستم از روی خروجیهایش تعریف میکند؛ سیگنالهای اصلی traces، metrics و logs هستند. Prometheus متریک را اندازهگیری عددی در طول زمان میداند و برای مانیتورینگ و alerting طراحی شده است. Kubernetes هم میگوید راهحل مانیتورینگ را دیکته نمیکند؛ باید خودتان یکپارچه کنید.
این مقاله مانیتورینگ را در سطح تصمیم توضیح میدهد، آن را از لاگ جدا میکند، و یک مسیر مینیمال برای تیم کوچک پیشنهاد میدهد. لاگ تفصیلی در مقالهٔ ۱۱۴ است.
پاسخ کوتاه
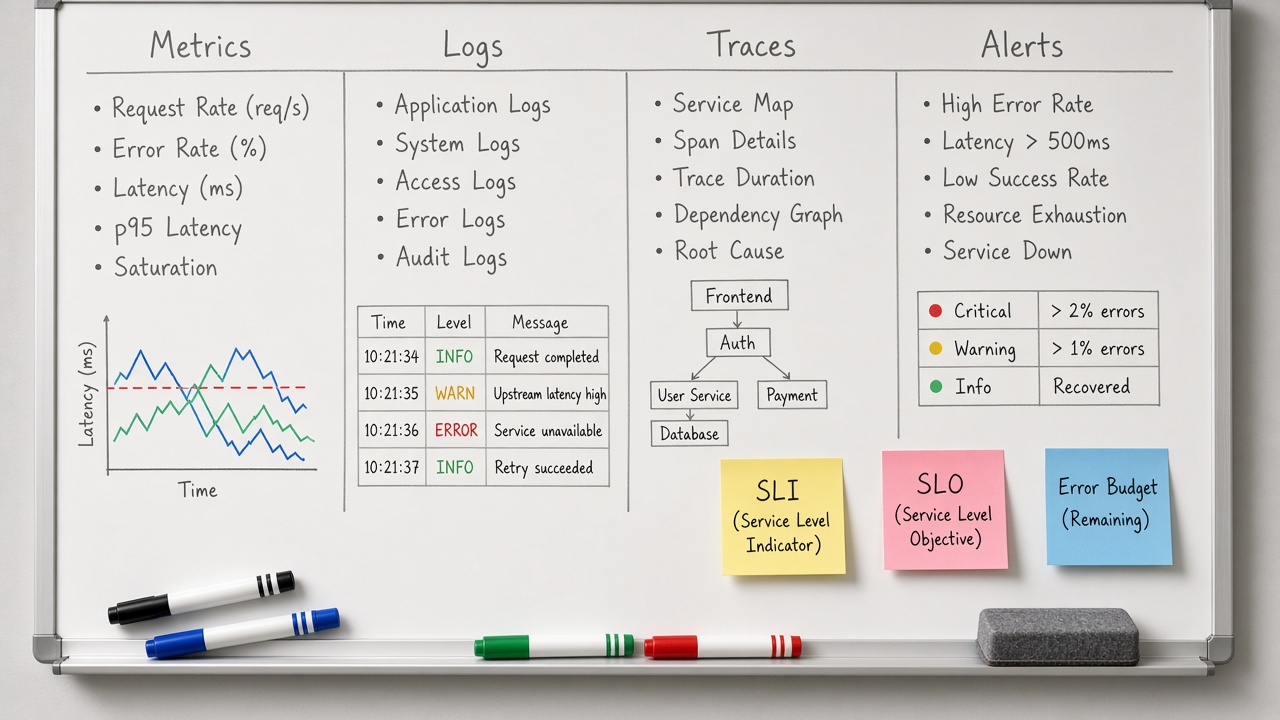
مانیتورینگ خوب سه کار میکند: متریکهای معنادار جمع میکند (مثلاً نرخ درخواست، خطا، تأخیر، اشباع منابع)، وضعیت را در داشبورد قابلخواندن نشان میدهد، و با قاعدهٔ هشدار افراد درست را وقتی لازم است بیدار میکند. هدف «زیبایی نمودار» نیست؛ هدف کاهش زمان تشخیص و تصمیم Rollback یا مقیاس است.
متریک برای روند و آستانه عالی است؛ برای «چرا این درخواست خاص شکست» معمولاً به لاگ و trace نیاز دارید. پشتهٔ بالغ هر سه را دارد؛ شروع مینیمال اغلب با چند متریک طلایی و یک هشدار واقعی است.
هشداری که همیشه قرمز است دیگر هشدار نیست؛ نویز است. آستانه را طوری بگذارید که اقدام معنادار داشته باشد.
Observability، Reliability و متریک
طبق Observability primer در OpenTelemetry:
- Observability یعنی بتوانید دربارهٔ سیستم سؤال بپرسید — حتی دربارهٔ مسائل تازه (unknown unknowns).
- برای این کار اپ باید instrument شود تا traces، metrics یا logs تولید کند.
- Reliability میپرسد: آیا سرویس کاری را که کاربر انتظار دارد انجام میدهد؟ آپتایم ۱۰۰٪ اگر «افزودن به سبد» غلط کار کند، کافی نیست.
- Metrics تجمیع عددی در بازهٔ زمانیاند: نرخ خطا، CPU، نرخ درخواست.
- SLI اندازه از نگاه رفتار سرویس/کاربر؛ SLO هدف ارتباطی قابلیت اطمینان برای سازمان.
برای محصول کوچک لازم نیست واژههای SRE را کامل پیاده کنید؛ اما یک SLI ساده مثل «درصد پاسخهای موفق زیر ۳۰۰ms برای checkout» از «CPU را نگاه کن» به کاربر نزدیکتر است.
Prometheus بهعنوان الگوی ذهنی متریک
Prometheus (پروژهٔ CNCF) متریک را بهصورت time series با timestamp و برچسبهای key-value ذخیره میکند. ویژگیهای کلیدی از مستندات:
- مدل چندبُعدی با نام متریک و برچسب.
- زبان پرسوجوی PromQL.
- جمعآوری عمدتاً pull روی HTTP؛ push از طریق gateway برای jobهای کوتاه.
- کشف هدف با service discovery یا پیکربندی ثابت.
- Alertmanager برای رسیدگی به هشدارها.
Prometheus برای سریهای عددی و تشخیص سریع در قطعی طراحی شده؛ هر سرور نسبتاً مستقل است تا وقتی بقیهٔ زیرساخت لنگ است بتوانید به آن تکیه کنید. برای صورتحساب per-request با دقت ۱۰۰٪ خودش را مناسب نمیداند — مثال خوبی از مرز ابزار.
مانیتورینگ در برابر Logging
| بعد | Monitoring (عمدتاً Metrics) | Logging |
|---|---|---|
| جنس داده | عدد تجمیعی در زمان | رویداد متنی/ساختیافته با جزئیات |
| سؤال قوی | چقدر؟ چند؟ از کی بد شد؟ | برای این مورد دقیقاً چه شد؟ |
| هزینهٔ ذخیره | معمولاً فشردهتر در مقیاس | میتواند حجیم و گران شود |
| هشدار | طبیعی روی آستانه | ممکن اما نیاز به دقت برای نویز |
| شروع مینیمال | latency، error rate، saturation | خطاهای اپ با request id |
هر دو لازماند. مانیتورینگ زود فریاد میزند؛ لاگ و trace علت را روشن میکنند. مقالهٔ ۱۱۴ روی لاگ تمرکز دارد.
چهار سیگنال طلایی عملی برای وب
برای بیشتر APIها و سایتها این مجموعه شروع خوبی است:
- Latency: توزیع تأخیر (نه فقط میانگین).
- Traffic: نرخ درخواست.
- Errors: نرخ ۴xx/۵xx یا خطای کسبوکاری کلیدی.
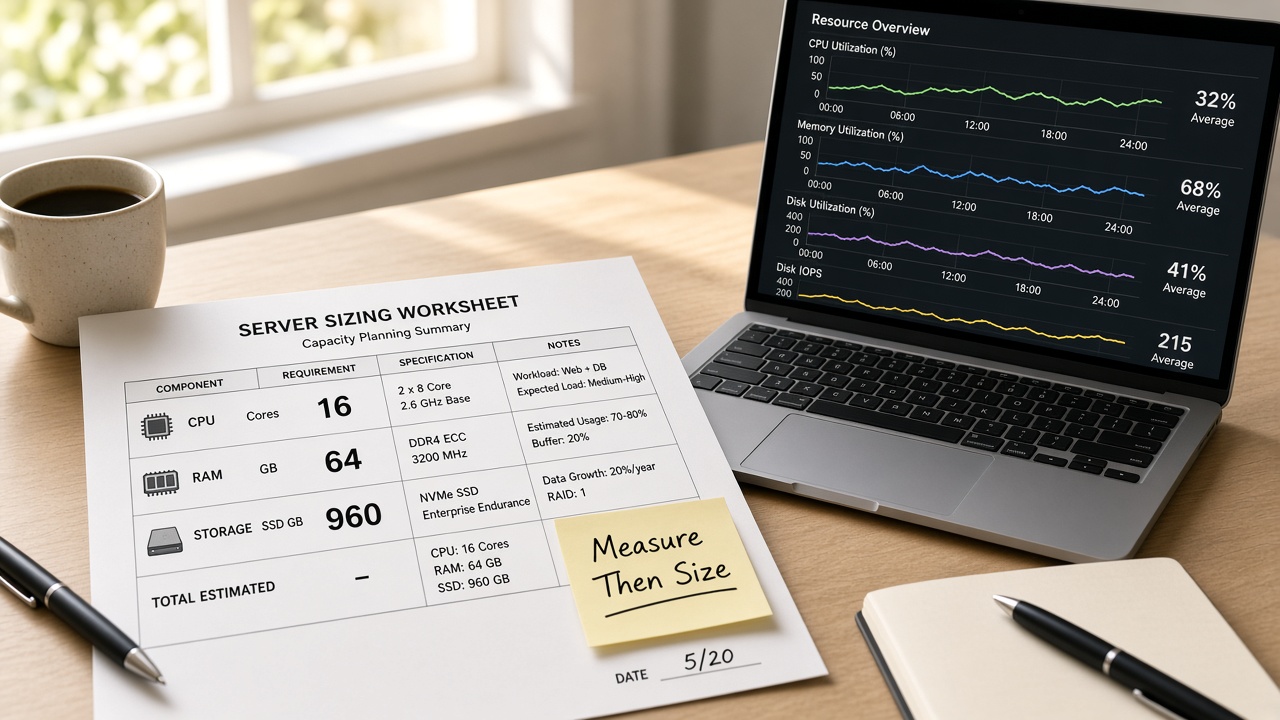
- Saturation: CPU، حافظه، صف، اتصال DB نزدیک سقف.
اگر فقط یکی را میتوانید این هفته اضافه کنید، error rate مسیر حیاتی + هشدار روی جهش ناگهانی را انتخاب کنید — نزدیکترین سیگنال به درد کاربر.
هشدار مؤثر
- هر هشدار باید اقدام مشخص داشته باشد (صفحه، Rollback، مقیاس، بررسی وابستگی).
- روی symptom کاربر هشدار بدهید نه فقط علت زیرساختی؛ CPU بالا ممکن است بیضرر باشد.
- شب و روز آستانه/مسیر متفاوت داشته باشید اگر on-call محدود است.
- هشدارهای تکراری بدون اقدام را حذف یا اصلاح کنید تا اعتماد نماند.
OpenTelemetry یادآوری میکند سیستم میتواند «بالا» باشد ولی رفتار غلط داشته باشد. هشدار فقط روی uptime کافی نیست.
نقش OpenTelemetry
OpenTelemetry چارچوب و ابزارک برای تولید و صدور telemetry (trace، metric، log) است؛ خودش backend مشاهدهپذیری نیست. هدف: instrument یکبار، صادرات به Prometheus، Jaeger یا فروشندههای مختلف بدون قفلشدن. برای تیم در حال رشد، استاندارد کردن صدور متریک/تریس جلوتر از تعویض داشبورد ارزش دارد.
مسیر مینیمال تیم کوچک
- یک endpoint سلامت عمیقتر از «پورت باز است».
- متریک نرخ خطا و latency برای مسیرهای پولساز.
- داشبورد یکصفحهای که بعد از Deploy باز شود.
- یک هشدار واقعی به کانال/تماس on-call.
- بعداً: exporter منابع، tracing برای مسیرهای پیچیده، SLO رسمی.
نصب پشتهٔ کامل روز اول لازم نیست. پیوند مانیتورینگ با پنجرهٔ مراقبت بعد از Deploy مهمتر از تعداد پنلهاست.
اشتباههای رایج
- صدها متریک بدون مالک و بدون هشدار اقدامپذیر.
- داشبورد زیبا که کسی در حادثه بلد نیست بخواند.
- هشدار روی CPU بدون پیوند به تجربهٔ کاربر.
- نداشتن مانیتورینگ Staging؛ فقط Production.
- فرض اینکه Kubernetes بهتنهایی مانیتورینگ میدهد.
جمعبندی برای تصمیم
Monitoring پایش پیوسته با متریک و هشدار برای فهم سلامت و قابلیت اطمینان است؛ بخشی از مشاهدهپذیری کنار لاگ و trace. Prometheus الگوی رایج time series و alerting است؛ OpenTelemetry راه استاندارد instrument. از سیگنالهای نزدیک به کاربر شروع کنید و هشدار را کموزیاد ولی قابلاعتماد نگه دارید.
این هفته: error rate و latency یک مسیر حیاتی + یک هشدار با اقدام مشخص. فردا داشبورد را زیبا کنید.
منابع و مراجع
- OpenTelemetry — Observability primer — https://opentelemetry.io/docs/concepts/observability-primer/
- OpenTelemetry — What is OpenTelemetry? — https://opentelemetry.io/docs/what-is-opentelemetry/
- Prometheus Docs — Overview — https://prometheus.io/docs/introduction/overview/
- Kubernetes Docs — What Kubernetes is not (logging/monitoring) — https://kubernetes.io/docs/concepts/overview/what-is-kubernetes/
برای رویدادهای متنی مقالهٔ ۱۱۴ و برای انتشار ایمن مقالهٔ ۰۵۰ را ببینید.
Author
SE
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.