Local، Staging و Production چیست؟
تعریف Local، Staging و Production، جداسازی داده، چه کسی حق Deploy دارد، و چرا یک محیط واحد برای کار حرفهای کافی نیست.
SE
11 min readSoheil Ebrahimpour
Founder & product engineer
وقتی میگوییم «سایت بالا است» معمولاً منظورمان Production است: جایی که مشتری واقعی کار میکند و پول و اعتبار برند در خطر است. اما نرمافزار قبل از رسیدن به آنجا روی ماشین برنامهنویس و روی یک کپی نزدیک به واقعیت هم زندگی میکند. نامهای رایج این سه لایه Local، Staging و Production است.
اشتباه گرفتن این سه، منشأ بسیاری از فاجعههای کوچک است: تست روی دادهٔ مشتری، Deploy مستقیم از لپتاپ به سرور اصلی، یا «روی سیستم من کار میکرد» بدون آنکه کسی در محیطی شبیه Production دیده باشد. Twelve-Factor هم فرض میکند config بین Deployها فرق میکند؛ همین فرض بدون نامگذاری محیطها ناقص میماند.
این صفحه تعریف هر محیط، جداسازی داده، و اینکه چه کسی حق Deploy دارد را روشن میکند. مقالهٔ ۰۴۹ روی «چرا اصلاً چند محیط؟» از زاویهٔ هزینه و ریسک برای مالک تمرکز دارد؛ اینجا نقشهٔ چیستی و نقشهاست.
پاسخ کوتاه
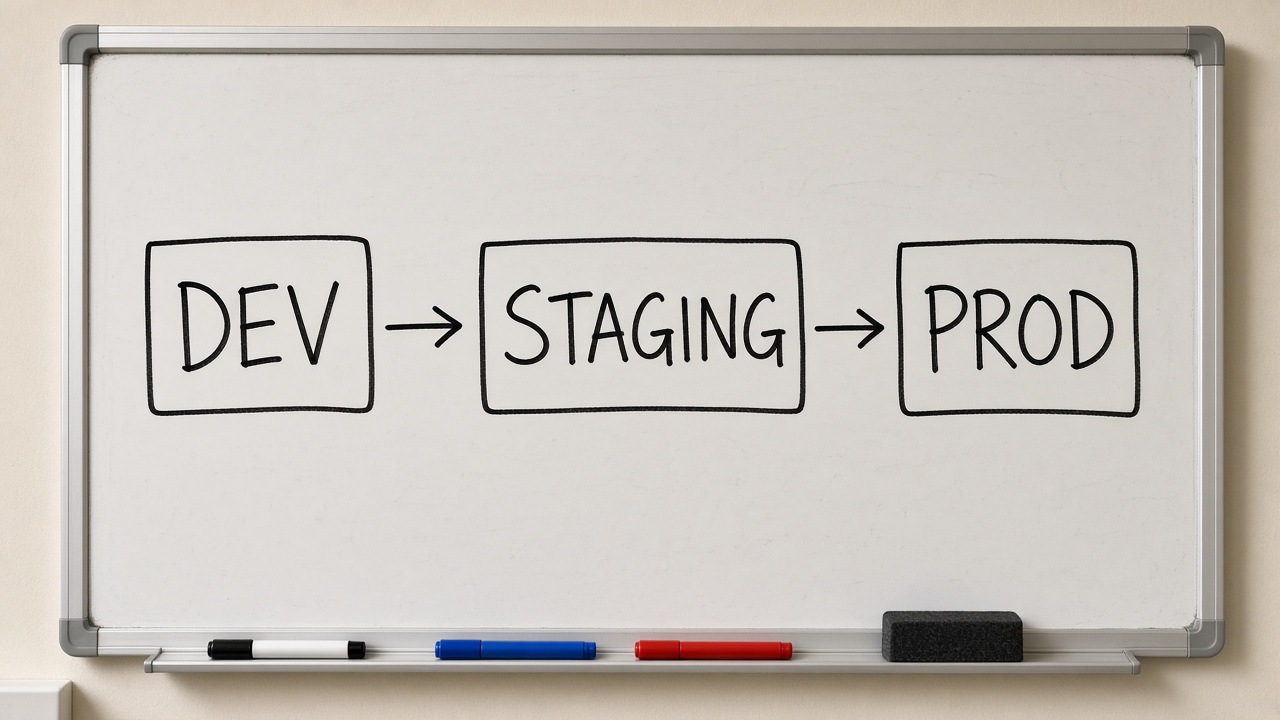
Local محیطی است روی ماشین توسعهدهنده برای ساخت و آزمایش سریع. Staging (یا Pre-production) کپی کنترلشدهای نزدیک به Production است برای تأیید قبل از انتشار عمومی. Production محیط زندهٔ کاربران واقعی است. داده، Secret، دامنه و دسترسی Deploy این سه باید جدا باشند؛ کد میتواند از یک مخزن بیاید.
حداقل حرفهای برای بیشتر محصولات وب: Local برای هر نفر، یک Staging مشترک، یک Production. پروژههای خیلی کوچک گاهی با Local + Production شروع میکنند؛ وقتی هزینهٔ باگ روی مشتری از هزینهٔ Staging بیشتر شد، لایهٔ میانی را اضافه کنید.
اگر Staging همان Production با دادهٔ واقعی و دسترسی آزاد همه باشد، Staging ندارید — فقط Production دوم دارید.
Local: کارگاه شخصی توسعهدهنده
Local یعنی لپتاپ یا ایستگاه کاری شما: دیتابیس محلی یا کانتینر، سرویسهای mock، و معمولاً دادههای ساختگی. هدف سرعت بازخورد است؛ نه شبیه بودن صددرصد به Production. اینجا میتوانید شاخهٔ نیمهکاره را بشکنید، migrate آزمایشی بزنید، و بدون ترس از مشتری دیباگ کنید.
محدودیت Local این است که «شبیه من» است نه «شبیه همه». نسخهٔ سیستمعامل، معماری CPU، مقدار RAM، و سرویسهای جانبی ممکن است با سرور فرق کند. بنابراین سبز بودن تست روی Local لازم است اما برای انتشار کافی نیست.
- Secret محلی در .env با gitignore — نه کلید Production.
- دادهٔ نمونه یا anonymized؛ نه dump کامل مشتری.
- سرویسهای خارجی در حالت test/sandbox وقتی ممکن است.
Staging: آخرین ایستگاه قبل از مشتری
Staging محیطی مشترک است که پیکربندی، نسخهٔ وابستگیها، و مسیر Deploy آن تا حد معقول به Production نزدیک است. تیم محصول، QA، یا خود توسعهدهنده اینجا میپرسد: آیا این Release برای کاربر قابل قبول است؟ آیا migrate خراب میکند؟ آیا پرداخت در حالت تست درست است؟
Staging مکان «دمو برای مدیر» و «بازبینی نهایی» است، نه محل نگهداری دائمی دادهٔ حساس مشتری. بهتر است دادهٔ Staging ساختگی، نمونهای، یا بهشدت ناشناسسازیشده باشد. اگر مجبورید از کپی Production استفاده کنید، دسترسی را محدود و عمر داده را کوتاه کنید.
از نظر شبکه، Staging اغلب روی دامنهٔ جدا (مثلاً staging.example.com) با محدودیت IP یا Basic Auth است تا موتور جستجو و کاربر تصادفی وارد نشوند. Secretهای Staging باید جدا از Production باشند — حتی اگر نام کلیدها یکی باشد.
Production: تعهد به کاربر واقعی
Production جایی است که SLA، پشتیبانی، پشتیبانگیری، و مانیتورینگ معنا پیدا میکند. هر تغییر اینجا باید برگشتپذیر یا حداقل قابل مشاهده باشد: healthcheck، لاگ، و مسیر Rollback. دسترسی Deploy محدود است؛ «هر کسی از لپتاپش scp کند» ضدالگو است.
تفاوت مهم با Staging: در Production نمیتوانید «بعداً درستش میکنیم» را با خیال راحت بگویید. آزمایش ویژگی نیمهخام، روشن کردن debug verbose با دادهٔ شخصی، یا استفاده از کلید sandbox پرداخت، اینجا اشتباههای گراناند.
| محیط | کاربر اصلی | داده | هدف |
|---|---|---|---|
| Local | توسعهدهنده | ساختگی / شخصی | سرعت ساخت و دیباگ |
| Staging | تیم محصول / QA | نمونهای / ناشناس | تأیید قبل از انتشار |
| Production | مشتری واقعی | دادهٔ واقعی + پشتیبان | ارائهٔ خدمت پایدار |
جداسازی داده: خط قرمز
اختلاط داده بین محیطها سه ریسک رایج میسازد:
- ارسال ایمیل/پیامک واقعی به مشتری بهخاطر تست روی کپی Production.
- نشت اطلاعات شخصی وقتی dump روی لپتاپ یا Staging باز میشود.
- خراب شدن آمار و گزارش وقتی دادهٔ تست با دادهٔ واقعی قاطی شود.
قانون عملی: Production به Staging فقط با pipeline ناشناسسازی یا تولید مصنوعی؛ هرگز .env و dump را در یک پوشهٔ مشترک چت تیمی نگذارید. اتصال Local به دیتابیس Production — حتی «فقط خواندنی» — باید استثنا باشد و با مجوز ثبت شود، نه عادت روزانه.
چه کسی میتواند Deploy کند؟
Local را هر توسعهدهنده برای خودش «deploy» میکند (اجرای محلی). Staging را معمولاً افراد با نقش توسعه/QA از شاخهٔ مشخص یا پس از CI سبز میفرستند. Production باید حلقهٔ سختتری داشته باشد: شاخهٔ محافظتشده، بازبینی، و در تیمهای بالغتر تأیید انسانی روی environment (مثلاً در GitHub Actions Environments).
سوال مالک محصول این نیست که «آیا ابزار fancy لازم است؟» بلکه: آیا یک نفر عصبانی یا خسته میتواند بدون شاهد Production را عوض کند؟ اگر جواب بله است، حداقل یک لایهٔ تأیید یا دو نفره کردن Deploy را جدی بگیرید — حتی اگر هنوز Kubernetes ندارید.
محیطهای بیشتر: Dev مشترک، QA، Preview
گاهی تیمها محیط چهارمی مثل Dev مشترک یا Preview per-PR اضافه میکنند. مفید است وقتی چند نفر همزمان روی یک بکاند کار میکنند یا میخواهید هر Pull Request یک URL موقت داشته باشد. هزینه: نگهداری Secret بیشتر، دیتابیس بیشتر، و پیچیدگی دیباگ «کدام محیط؟».
نامها مهمتر از تعداد نیستند. مهم این است که هر نام معنای دسترسی، داده و ریسک مشخص داشته باشد. Twelve-Factor هشدار میدهد که انفجار نامهای محیطی داخل کد (joes-staging و …) شکننده است؛ بهتر است env varهای granular per-deploy داشته باشید تا ماتریس عظیم تنظیمات داخل سورس.
چه زمانی Local + Production کافی است؟
برای MVP تکنفره با ترافیک کم و بدون پرداخت حساس، دو محیط گاهی پذیرفتنی است — بهشرط آگاهی از ریسک. مقالهٔ ۰۴۹ این تصمیم را باز میکند. نشانهٔ اینکه Staging لازم شده:
- باگهایی که فقط روی سرور دیده میشوند تکرار میشوند.
- بیش از یک نفر باید قبل از انتشار تأیید کند.
- migrate یا پرداخت دارید و نمیخواهید اولین بار روی مشتری واقعی باشد.
- هزینهٔ یک ساعت downtime از هزینهٔ ماهانهٔ یک سرور کوچک Staging بیشتر است.
چکلیست راهاندازی حداقلی
- سه مجموعهٔ Secret جدا با نام کلید یکسان.
- دامنه یا پورت جدا و جلوگیری از ایندکس شدن Staging.
- مسیر Deploy مستند: از کدام شاخه، با چه فرمان/pipeline.
- ممنوعیت اتصال روزمرهٔ Local به دیتابیس Production.
- حداقل یک healthcheck و پشتیبان برای Production.
- قانون تیمی: دادهٔ واقعی مشتری روی لپتاپ نمیآید مگر با ناشناسسازی.
پیکربندی و دامنه: نشانههای بصری محیط
اشتباه کلاسیک این است که Staging و Production از نظر ظاهر یکی باشند و فقط URL فرق کند — بعد کسی روی Staging خرید آزمایشی میکند یا برعکس، روی Production دادهٔ تست میسازد. نشانههای ارزان و مؤثر:
- رنگ یا بنر واضح «Staging» در هدر برای کارکنان.
- دامنهٔ جدا و robots.txt مسدودکننده برای محیط غیرتولید.
- عنوان صفحه یا favicon متفاوت تا در تب مرورگر قاطی نشود.
- غیرفعال بودن درگاه live و سرویس پیامک واقعی روی Staging.
برای Local هم مفید است برنامه بداند APP_ENV=local است تا مثلاً ایمیلها به mailbox آزمایشی بروند. اینها همه از همان Environment Variable میآیند که در مقالهٔ ۰۴۷ جدا کردیم: یک کد، سه مقدار.
همترازی نسخه: Staging عقبافتاده بیفایده است
اگر Production هفتهای چند بار جلو میرود و Staging ماهانه یکبار بهروز میشود، دیگر «پیشنمایش» نیست؛ یک موزه است. حداقل توافق تیمی:
- هر Release نامزد Production اول روی Staging بنشیند.
- فاصلهٔ نسخهٔ Staging از main/Production بیش از چند روز کاری نشود مگر توقف آگاهانه.
- پس از Deploy موفق Production، Staging را همانجا همتراز نگه دارید یا برای تست بعدی آماده کنید.
هزینهٔ همترازی کمتر از هزینهٔ باگی است که فقط بهخاطر نسخهٔ قدیمی Nginx یا فرق جزئی config روی Production دیده میشود. شباهت زیرساخت صددرصد لازم نیست؛ شباهت مسیر انتشار و نسخهٔ اپ معمولاً لازم است.
دادهٔ تست چطور ساخته شود؟
سه الگوی رایج وجود دارد و انتخاب بستگی به حساسیت دارد:
- دادهٔ مصنوعی از ابتدا (seed): امنترین برای بیشتر محصولات.
- ناشناسسازی از کپی Production: وقتی گزارشهای واقعی لازم است؛ نیاز به اسکریپت حذف PII دارد.
- کپی خام Production: فقط در شرایط استثنا با دسترسی محدود و عمر کوتاه — پیشفرض تیمهای بالغ نیست.
اگر محصولتان بازارگاه، پزشکی، یا مالی است، کپی خام را پیشفرض نگذارید. حتی در محصولات سادهتر، ایمیل و شماره تلفن واقعی روی Staging یعنی ریسک ارسال ناخواسته. یک سوئیچ «ارسال واقعی خاموش» در config غیرتولید ارزشش را دارد.
هماهنگی محصول و پشتیبانی با محیطها
زبان مشترک مهم است. وقتی پشتیبانی میگوید «روی سایت دیدم» باید روشن باشد کدام محیط. لینکهای داخلی مستند، و عادت نوشتن URL کامل در تیکت، از chaseهای بیهوده کم میکند. مالک محصول برای دموی مشتری از Production یا از Staging پایدار استفاده کند — نه از Local برنامهنویس روی VPN ناپایدار — مگر اینکه صریحاً دموی پیشنمایش باشد.
در تیمهای دورکار، دسترسی به Staging را با همان استاندارد حداقل دسترسی بدهید: پیمانکار موقت لازم نیست پنل Production ببیند فقط چون «میخواهد باگ را بازتولید کند»؛ اغلب Staging کافی است.
امنیت دسترسی بین محیطها
جدا بودن محیط فقط دربارهٔ سرور نیست؛ دربارهٔ هویت و دسترسی است. حساب ادمین Production نباید همان رمز و همان نشست Local باشد. VPN یا IP allowlist برای پنلهای حساس، احراز هویت دوعاملی روی ابر، و کلیدهای SSH جدا برای Staging و Production، فاصلهٔ یک اشتباه را زیاد میکنند.
در عمل بسیاری از رخدادها از «دسترسی بیش از حد برای راحتی» شروع میشود: همه sudo روی Prod، یک فایل inventory مشترک با IP و رمز، یا اسکریپت Deploy که روی هر سه محیط با یک کلید کار میکند. راحتی کوتاهمدت، بلاسترادیوس بلندمدت میسازد. اگر مجبورید ابزار مشترک داشته باشید، حداقل نقش و Secret را per-environment جدا کنید.
برای پیمانکاران: دسترسی زماندار به Staging معمولاً کافی است. کپی کردن.dump Production روی لپتاپ پیمانکار را در قرارداد و چکلیست امنیتی صریحاً ممنوع یا مشروط کنید. این تصمیم محصولی-حقوقی است، نه فقط سلیقهٔ DevOps.
نامگذاری و مستند یکصفحهای
یک صفحه در README یا ویکی داخلی با این سرفصلها بیشتر از یک ابزار گران قیمت ارزش دارد:
- URL هر محیط و اینکه عمومی است یا خیر.
- از کدام شاخه/pipeline به هر محیط میرود.
- چه کسی اجازهٔ Deploy Production دارد.
- داده از کجا میآید و چه چیزی ممنوع است.
- در رخداد، اول کجا را چک کنند (health، لاگ، نسخه).
وقتی نفر جدید یا جانشین on-call میآید، همین یک صفحه از «حدس زدن» جلوگیری میکند. محیطها وقتی در سر افراد زندانی باشند، با رفتن افراد از بین میروند.
ضدالگوهای روزمره محیط
چند صحنهٔ تکراری که مرز محیط را میشکنند: اجرای اسکریپت «یکباره» مستقیم روی Prod چون Staging خراب است؛ روشن کردن debug روی Prod و فراموش کردن خاموش کردن؛ استفاده از همان سطل فایل یا همان صف پیام برای تست و مشتری؛ و باز کردن موقت Production به IP عمومی «فقط برای دموی امروز». هرکدام کوتاه به نظر میرسند و ردپای بلند میگذارند.
قانون تیمی مفید: هر استثنای دسترسی به Production باید تاریخ انقضا و نام مسئول داشته باشد. اگر استثناها دائمی شدند، یا فرایند را درست کنید یا رسماً بپذیرید که دیگر Staging ندارید.
جمعبندی برای تصمیم
Local برای سرعت، Staging برای اطمینان، Production برای تعهد است. کد میتواند مشترک باشد؛ داده، Secret و حق Deploy نه. اگر امروز فقط یک سرور دارید، حداقل مرز ذهنی این سه را بکشید و هرچه زودتر Staging را وقتی ریسک مشتری بالا رفت اضافه کنید.
قدم بعدی منطقی: فهمیدن اینکه Deploy خودش چه مراحلی دارد (Build، Release، migrate، healthcheck، rollback) و چرا هزینهٔ چند محیط از هزینهٔ آزمایش روی Production کمتر است.
منابع و مراجع
- The Twelve-Factor App — III. Config (تفاوت config بین Deployها و هشدار دربارهٔ انفجار نام محیطها) — https://12factor.net/config
برای تصمیم مالک دربارهٔ تعداد محیط و برای جزئیات استقرار، مقالات ۰۴۹ و ۰۵۰ را بخوانید؛ برای Secret و .env مقالهٔ ۰۴۷.
Author
SE
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.