

Load Average در لینوکس: معنی اعداد و تفسیر درست
load average چیست، چرا با درصد CPU یکی نیست، نقش حالت D و I/O، و چگونه با nproc و top علت را جدا کنید.
Founder & product engineer
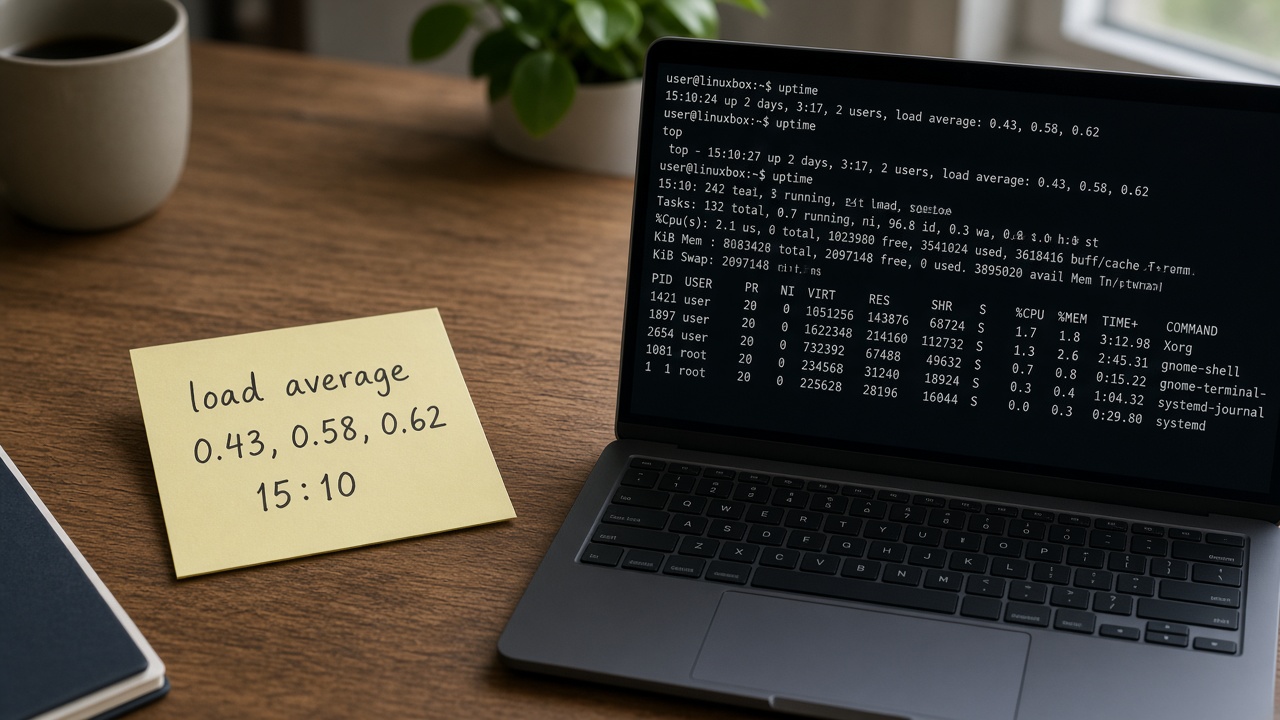
آلارم میگوید load از ۵ گذشته؛ کسی reboot میکند، کسی CPU را متهم میکند، کسی میگوید «نرمال است چون ۸ هسته داریم». هر سه ممکن است غلط باشند. Load average در لینوکس میانگین تعداد پروسسهایی است که در صف اجرا (runnable) یا خواب غیرقابلوقف (uninterruptible، اغلب منتظر I/O) هستند — نه درصد استفادهٔ CPU بهتنهایی.
بدون نرمالسازی نسبت به تعداد CPU و بدون جدا کردن CPU-bound از disk-bound، یا بیشواکنش میکنید یا فرصت را از دست میدهید.
پاسخ کوتاه
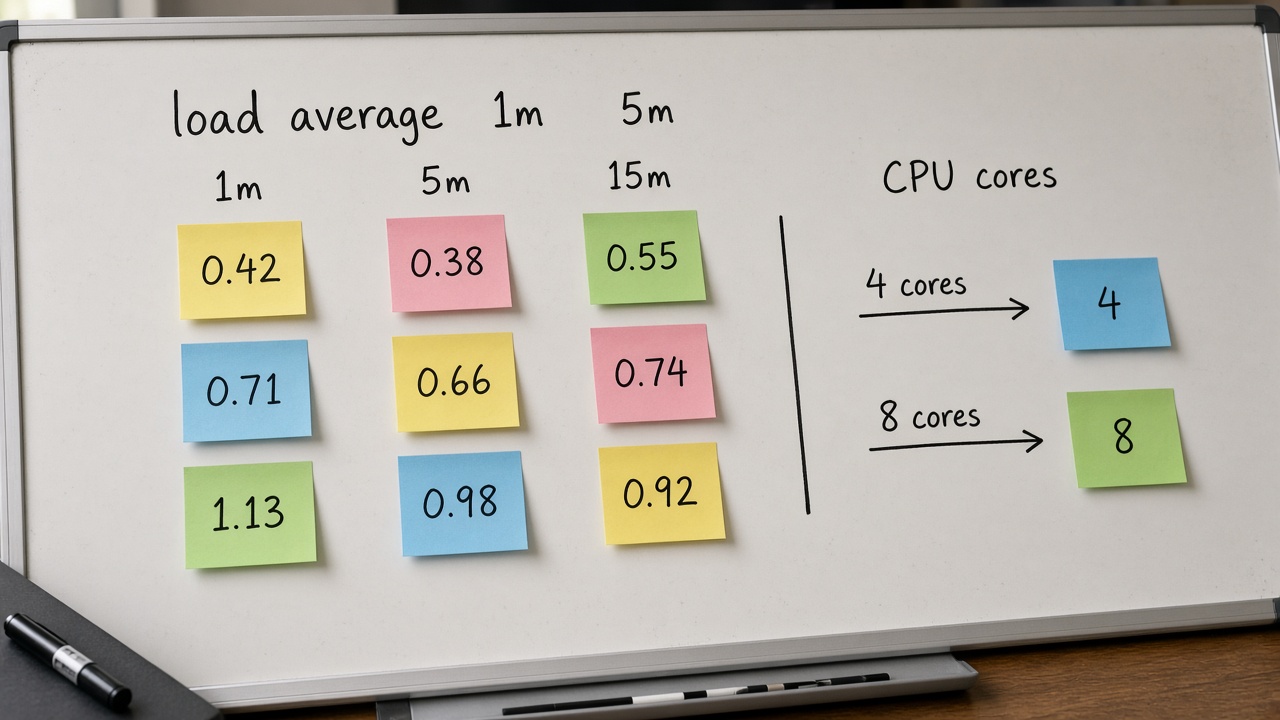
سه عدد در `uptime` میانگین ۱، ۵ و ۱۵ دقیقهاند. آنها را با تعداد CPU (`nproc`) مقایسه کنید: روی ۴ هسته، load حدود ۴ یعنی تقریباً اشباع اجرایی/منتظر. اگر load بالاست ولی CPU idle زیاد است، به I/O و حالت D در `ps` نگاه کنید. روند ۱ در برابر ۱۵ دقیقه میگوید اسپایک کوتاه است یا فشار پایدار.
Load متوسطِ برابر تعداد CPU نقطهٔ شروع تفسیر است، نه آستانهٔ جادویی ثابت برای همهٔ سرورها.
تعریف رسمیتر
طبق توضیح uptime(1) در خانوادهٔ procps: load averages میانگین تعداد پروسسهایی است که runnable هستند (در حال استفاده یا منتظر CPU) یا در حالت uninterruptible (مثلاً منتظر دیسک). این میانگین روی سه بازه گرفته میشود و برای تعداد CPU نرمال نمیشود. بنابراین load=۱ روی ماشین تکهسته یعنی تقریباً همیشه یک کار آماده/منتظر؛ روی چهار هسته یعنی حدود ۲۵٪ از ظرفیت صف.
bash
uptime cat /proc/loadavg nproc lscpu | rg '^CPU\(s\)|Thread|Core|Socket'
چرا با %CPU یکی نیست؟
- یک پروسس میتواند ۱۰۰٪ یک هسته را بگیرد در حالی که load نزدیک ۱ است و بقیهٔ هستهها بیکارند.
- چند پروسس منتظر قفل یا دیسک در حالت D به load اضافه میشوند بدون اینکه %user بالا برود.
- میانگین زمانی است؛ اسپایک کوتاه در میانگین ۱۵ دقیقه کمرنگ میشود.
- در کانتینر، load میزبان و سهمیهٔ CPU کانتینر داستان جدا دارند.
خواندن سه عدد با هم
اگر ۱ دقیقه خیلی بالاتر از ۱۵ دقیقه است، فشار تازه یا در حال اوج است. اگر هر سه نزدیک و بالایند، فشار مزمن دارید. اگر ۱ پایین و ۱۵ بالاست، تازه در حال بهبودید. این الگو برای تصمیم «همین حالا scale کنم یا صبر کنم» مفید است.
| الگو | تفسیر | قدم بعد |
|---|---|---|
| 1 ≫ 15، هر دو > nproc | اسپایک اخیر | top/iotop فوری |
| 1 ≈ 5 ≈ 15 > nproc | اشباع پایدار | ظرفیت یا بهینهسازی |
| 1 < nproc ولی latency بد | شاید قفل/اپ نه صف CPU | پروفایل اپ |
| load بالا، CPU %idle بالا | احتمال I/O wait | iostat، حالت D |
مسیر عیبیابی وقتی load بالاست
- nproc و uptime را ثبت کنید.
- با top یا htop ببینید %CPU، %wa (I/O wait) و پروسسهای برتر چیست.
- پروسسهای حالت D را لیست کنید: منتظر دیسک/nfs؟
- iostat -xz و df را برای دیسک اشباعشده چک کنید.
- اگر CPU اشباع است، پروفایل یا تقسیم بار؛ اگر I/O است، دیسک، الگو، یا حجم داده.
bash
uptime; nproc ps -eo state,pid,cmd | awk '$1 ~ /D/ {print}' | head # iostat نیاز به sysstat دارد: iostat -xz 1 3 2>/dev/null || true
Load در ماشین چندهستهای و VM
Steal time در VM (`%st` در top) یعنی هایپروایزر CPU را از شما گرفته؛ load مهمان ممکن است بالا برود در حالی که «سختافزار شما» مقصر نیست. در چنین حالتی ارتقای سایز instance یا بررسی noisy neighbor منطقیتر از tune کردن اپ است. همچنین SMT/hyperthread تعداد CPU منطقی را بالا میبرد؛ ظرفیت واقعی برای بارهای خاص کمتر از nproc خام حس میشود.
آستانههای هشدار معقول
بهجای «اگر load>۲ آلارم»، از نسبت به nproc استفاده کنید: مثلاً هشدار وقتی میانگین ۵ دقیقه از ۰.۷×nproc گذشت و critical نزدیک ۱.۰–۱.۲×nproc، همراه با شرط روی %wa یا latency اپ. آلارم فقط روی load بدون زمینه، صفحه را بیاعتبار میکند.
اشتباههای رایج
- مقایسهٔ load سرور ۱۶ هستهای با سرور ۲ هستهای بدون نرمالسازی.
- reboot بهعنوان اولین واکنش به load بالا.
- نادیده گرفتن I/O و NFS در تفسیر load.
- اتکا به میانگین ۱۵ دقیقه برای حادثهٔ دقیقهای.
- فرض اینکه load پایین یعنی سیستم سالم است در حالی که یک thread حیاتی بلاک شده.
چه زمانی مفید است / نیست؟
مفید بهعنوان سیگنال اشباع صف در سطح سیستمعامل. ناکافی بهعنوان تنها SLO؛ برای کاربر نهایی latency و error rate مهمترند. Load را با متریک اپ ترکیب کنید.
مثال عددی روی سرور ۴ هستهای
فرض کنید `nproc` برابر ۴ است و uptime نشان میدهد `load average: 6.20, 5.80, 3.10`. میانگین ۱ و ۵ دقیقه بالای ظرفیت است و ۱۵ دقیقه در حال بالا آمدن از سطح پایینتر؛ یعنی فشار جدی اخیر. اگر top نشان دهد `%wa` بالا و چند پروسس در حالت D منتظر دیسکاند، خرید CPU فوری اشتباه است — اول I/O. اگر `%wa` نزدیک صفر و چند پروسس CPU را پر کردهاند، مقیاس افقی یا بهینهسازی کد منطقیتر است.
حالا همان ماشین با `0.80, 0.70, 0.60`: زیر یک کار تماموقت به ازای هر هسته. ممکن است همچنان latency بد باشد اگر قفل نرمافزاری یا وابستگی بیرونی مشکل دارد؛ load پایین فقط میگوید صف OS اشباع نشده است.
Load و صفحهبندی / فشار حافظه
وقتی سیستم thrashing میکند، پروسسها بیشتر منتظر I/O صفحه میمانند و load میتواند بالا برود در حالی که «کار مفید CPU» کم است. ترکیب free/available، si/so و load تصویر کاملتری از «کندی» میدهد تا هر متریک بهتنهایی. اینجاست که مقالههای حافظه و دیسک به load وصل میشوند.
نمایش در مانیتورینگ
متریک `node_load1 / count(cpus)` یا معادل را بهعنوان gauge نرمالشده نگه دارید تا داشبورد بین ماشینهای ۲ و ۳۲ هستهای قابلمقایسه شود. آلارم خام روی load1>۲ روی ناوگان ناهمگن فقط نویز تولید میکند.
ارتباط load با صف کاربر نهایی
کاربر نهایی صف کرنل را نمیبیند؛ تأخیر و خطا میبیند. گاهی load پایین است ولی صف اپلیکیشن (worker pool) پر است — مثلاً همهٔ workerها منتظر قفل دیتابیساند و در حالت خواب قابلوقف که به load average به همان شدت حالت D اضافه نمیشود. بنابراین load را کنار latency صدک ۹۵، نرخ خطا، و طول صف اپ بخوانید. متریک OS نقطهٔ شروع است نه حکم نهایی.
در معماری میکروسرویس، load بالای یک گره ممکن است نشانهٔ وابستگی کند بیرونی باشد که threadها را نگه میدارد. قبل از scale افقی همان سرویس، وابستگی را پروفایل کنید؛ وگرنه فقط تعداد منتظرها را زیاد کردهاید.
برای ماشینهای build/CI، load بالا در بازهٔ کاری طبیعی است. آلارم را با تقویم یا برچسب نقش ماشین تنظیم کنید تا صفحهٔ on-call از نویج jobهای کامپایل پر نشود. برعکس، روی گره latence-sensitive پایگاه داده، همان سطح load میتواند قرمز باشد.
اگر پس از مهاجرت به پردازندهٔ جدید load ظاهراً عوض شد، اول nproc و نوع hypervisor و steal time را مقایسه کنید. مقایسهٔ خام load بین دو نسل سختافزار بدون نرمالسازی، تصمیم ظرفیت غلط میسازد.
تمرین عملی ۱۵ دقیقهای
روی یک سرور غیربحرانی: nproc را یادداشت کنید، uptime را ببینید، یک فشردهٔ CPU مصنوعی کوتاه با چند worker بسازید (مثلاً چند پروسس محاسبه)، دوباره uptime را بخوانید و مشاهده کنید میانگین ۱ دقیقه زودتر از ۱۵ دقیقه بالا میرود. سپس با ایجاد I/O سنگین کنترلشده (خواندن فایل بزرگ) تفاوت %wa و حالت D را حس کنید. هدف شکستن سرور نیست؛ ساختن شهود است تا آلارم بعدی را با چشم بسته تفسیر نکنید.
نتیجه را در دو ستون بنویسید: «آنچه load گفت» و «آنچه top/iostat گفت». اگر دو ستون همیشه یکی نیستند، دقیقاً به هدف تمرین رسیدهاید. این تفاوت همان چیزی است که در صفحهٔ on-call ارزش ساعتها را دارد.
همین تمرین را یکبار داخل کانتینر با CPU quota پایین تکرار کنید تا ببینید محدودیت cgroup چگونه با load میزبان تعامل میکند. بسیاری از سوءتفاهمهای ظرفیت از ندیدن همین لایه میآید.
در پایان تمرین، آلارمهای فعلی ناوگان را مرور کنید و حداقل یکی را از آستانهٔ مطلق به نسبت nproc تبدیل کنید. تغییر کوچک، سیگنال بهتر.
جمعبندی عملی برای on-call
وقتی صفحه دربارهٔ load بالا میآید، این ترتیب را داشته باشید: nproc را ببینید، نسبت load5 به nproc را حساب کنید، top را برای CPU در برابر wait نگاه کنید، حالت D را چک کنید، و فقط وقتی تصویر روشن شد تصمیم به scale، restart یا صبر بگیرید. اگر load5 کمتر از حدود ۰٫۵×nproc است و کاربر همچنان کندی گزارش میکند، مسیر را از اپ و وابستگیها ادامه دهید نه از خرید فوری CPU.
آلارم را طوری بنویسید که این نسبت را خودش حساب کند و لینک Runbook همین پاراگراف را داشته باشد. انسان خسته در نیمهشب به فرمول نیاز دارد نه به مقالهٔ بلند — ولی مقاله باید همان فرمول را از قبل در Runbook کاشته باشد.
دستکم یکبار در فصل، آلارم load را عمداً با بار مصنوعی تست کنید تا مطمئن شوید صفحه میرود و دستورالعمل درست است. آلارمی که هرگز تمرین نشده در حادثهٔ واقعی بیشتر گیج میکند تا کمک.
حد و مرز تفسیر load در کانتینر و VM
داخل کانتینر، `/proc/loadavg` اغلب load میزبان را نشان میدهد نه سهمیهٔ همان کانتینر. بنابراین تصمیم scale فقط بر اساس load دیدهشده از داخل پاد میتواند غلط باشد. متریکهای cgroup CPU و throttle را ترجیح دهید و load میزبان را در لایهٔ node ببینید. در VM، steal time را به همین اندازه جدی بگیرید؛ load بالا با steal بالا یعنی رقابت روی هایپروایزر، نه لزوماً کد شما.
این مرزها را در داشبورد برچسب بزنید تا on-call تازهوارد load کانتینر را با nproc میزبان جمع نکند و تصمیم ظرفیت را روی لایهٔ اشتباه نگیرد. مستند یکپاراگرافی کنار پنل مانیتورینگ کافی است.
اگر فقط یک کار بهبود این ماه انجام میدهید، آلارم load را با شرط steal یا cpu throttle غنی کنید تا صفحهٔ شبانه دقیقتر شود.
خلاصه
Load average شمارش میانگین کارهای آماده یا منتظر I/O است، نرمالنشده بر CPU. آن را با nproc، روند ۱/۵/۱۵، و تفکیک CPU در برابر I/O بخوانید. آنگاه میفهمید باید CPU بخرید، دیسک را درست کنید، یا اصلاً آلارم را نادیده بگیرید.
سوالات متداول
آیا load باید همیشه زیر ۱ باشد؟
خیر. روی ماشین ۸ هستهای load برابر ۴ اغلب سالم است. معیار نسبت به ظرفیت است.
تفاوت load و CPU utilization؟
Utilization درصد زمان مشغول بودن هستههاست؛ load طول صف (و خواب D) است. هر دو لازماند.
/proc/loadavg چهار فیلد دارد؛ سومی چیست؟
علاوه بر سه میانگین، فیلدهایی مثل تعداد runnable فعلی و آخرین pid دیده میشود؛ برای جزئیات همان نسخه، مستند proc را ببینید.
منابع و مراجع
- uptime(1) — load averages definition: https://man7.org/linux/man-pages/man1/uptime.1.html
- proc(5) — /proc/loadavg: https://man7.org/linux/man-pages/man5/proc.5.html
- top(1) / htop for %wa and process states
- iostat(1) from sysstat for I/O saturation
- Linux kernel scheduler and load accounting documentation
Author
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.




