

Deployment چیست و یک نرمافزار چگونه به Production میرسد؟
مسیر رسیدن نرمافزار به Production: Build، Release، migrate، healthcheck و Rollback — با ارجاع به ۱۲-Factor و Environments در GitHub Actions.
Founder & product engineer
Deployment (استقرار) یعنی رساندن یک نسخهٔ مشخص از نرمافزار به یک محیط اجرا — معمولاً Staging یا Production — طوری که کاربران همان نسخه را ببینند. «آپلود فایل روی سرور» ممکن است نوعی Deploy باشد، اما در کار حرفهای Deploy یک مسیر تکرارپذیر است: ساخت، بستهبندی با پیکربندی، اجرای migrate، بررسی سلامت، و در صورت نیاز برگشت.
Twelve-Factor App این مسیر را به سه مرحلهٔ Build، Release و Run جدا میکند. ابزارهایی مثل GitHub Actions هم با مفهوم Environment، concurrency و protection rule همان مسیر را در عمل کنترل میکنند: چه چیزی، به کجا، با تأیید چه کسی. جزئیات کامل CI/CD در مقالهٔ ۱۱۲ میآید؛ اینجا تصویر ذهنی استقرار است.
اگر مقالات ۰۴۸ و ۰۴۹ را خواندهاید، میدانید محیطها چرا جدایند. این صفحه میگوید وقتی تصمیم گرفتید به Production بروید، چه مراحلی بین «merge» و «کاربر میبیند» قرار دارد.
پاسخ کوتاه
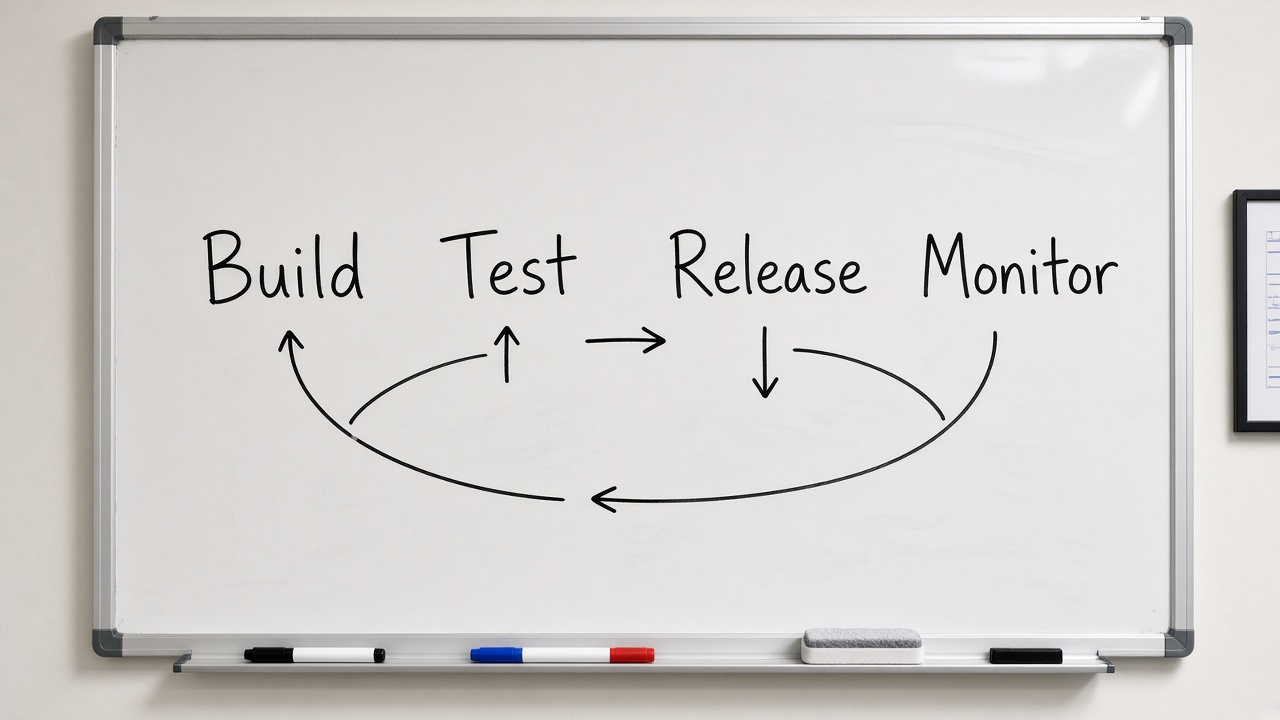
یک مسیر سالم معمولاً این شکل را دارد: از یک commit مشخص Build ساخته میشود (وابستگیها و داراییها آماده میشوند)؛ Release با ترکیب آن Build و config همان محیط ساخته میشود؛ migrateهای پایگاهداده در ترتیب درست اجرا میشوند؛ فرایندها بالا میآیند؛ healthcheck تأیید میکند سرویس جواب میدهد؛ اگر نه، Rollback به Release قبلی.
Deploy خوب تکرارپذیر، قابل مشاهده و برگشتپذیر است. Deploy بد وابسته به حافظهٔ یک نفر، بدون شناسهٔ نسخه، و بدون راه برگشت در نصفهشب است. طبق ۱۲-Factor، Releaseها ledger الحاقیاند: هر Release شناسه یکتا دارد و بعد از ساخته شدن تغییر نمیکند.
اگر نتوانید بگویید «الان دقیقاً کدام Release روی Production است»، هنوز استقرار را مدیریت نمیکنید — فقط فایل جابهجا میکنید.
Build، Release، Run — مدل ۱۲-Factor
صفحهٔ build-release-run در 12factor.net سه مرحله را اینگونه جدا میکند:
- Build: تبدیل یک نسخهٔ مشخص از مخزن به بستهٔ اجرایی (build) — دریافت وابستگیها، compile، ساخت asset.
- Release: ترکیب آن build با config فعلی همان Deploy؛ خروجی آمادهٔ اجرا با شناسهٔ یکتا.
- Run: اجرای فرایندهای اپ روی آن Release در محیط اجرا.
جداسازی سخت مهم است: در Runtime نباید کد را «همین الان روی سرور ادیت» کنید، چون راهی برای برگرداندن آن تغییر به Build وجود ندارد. ابزارهای استقرار معمولاً Rollback را با برگشت به Release قبلی ممکن میکنند. Run باید ساده بماند، چون ممکن است نیمهشب با reboot یا crash بدون حضور توسعهدهنده دوباره اجرا شود؛ پیچیدگی را در Build بگذارید که در حضور انسان است.
شناسهٔ Release
هر Release باید ID یکتا داشته باشد — timestamp یا شمارهٔ افزایشی مثل v100. Release پس از ایجاد mutate نمیشود؛ هر تغییر = Release جدید. این عادت، دیباگ «دیروز کار میکرد» را از حدس به مقایسهٔ دو شناسه تبدیل میکند.
مهاجرت پایگاهداده (migrate)
بسیاری از Deployها فقط کپی باینری نیستند؛ طرح دیتابیس هم عوض میشود. migrate باید بخشی از مسیر انتشار باشد، نه کار دستی فراموششدنی. اصول عملی:
- migrate را روی Staging با همان اسکریپت Production امتحان کنید.
- تا حد ممکن تغییرات را سازگار با نسخهٔ قبلی نگه دارید (expand/contract) تا Rollback کد بدون Rollback فوری DB ممکن باشد.
- پشتیبان قبل از migrateهای خطرناک.
- ترتیب: گاهی migrate جلوتر از کد، گاهی کد جلوتر — بستگی به سازگاری دارد؛ تصمیم را مستند کنید.
بدترین حالت: کد جدید روی Production با ستون جدیدی که migrate نشده. healthcheck ممکن است سبز باشد و خطاها فقط در مسیرهای خاص دیده شوند.
Healthcheck و مشاهدهپذیری حداقلی
Healthcheck یعنی نقطهٔ بررسی که بگوید «سرویس زنده است و به وابستگیهای حیاتی وصل است» — نه فقط اینکه پورت TCP باز است. بعد از Deploy، ترافیک را وقتی سویچ کنید که healthcheck سبز باشد. اگر از load balancer یا orchestrator استفاده میکنید، همین سیگنال مسیر ترافیک را عوض میکند.
حداقل مشاهدهپذیری: نسخه/Release ID در پاسخ یا لاگ؛ هشدار خطا؛ و کسی که بداند بعد از Deploy کجا را نگاه کند. مانیتورینگ عمیقتر در مقالات بعدی سری است؛ برای استقرار، «دانستن اینکه خراب شد» از «زیبا بودن داشبورد» مهمتر است.
Rollback: قبل از اولین Deploy سیمکشی کنید
Rollback یعنی برگشت به Release قبلی شناختهشده. ۱۲-Factor صریحاً مدیریت Release و امکان rollback را بخشی از ابزار استقرار میداند. اگر مسیر برگشت را بعد از اولین بحران طراحی کنید، در بحران طراحی نخواهید کرد.
- نگه داشتن N Release آخر قابل اجرا.
- فرمان یا دکمهٔ مشخص برای برگشت.
- آگاهی از اینکه کدام migrate برگشتپذیر نیست.
- تمرین یکبار Rollback روی Staging.
| مرحله | خروجی | شکست رایج |
|---|---|---|
| Build | بستهٔ نسخهٔ مشخص | وابستگی قفلنشده؛ «روی ماشین من build شد» |
| Release | Build + config محیط | Secret اشتباه محیط؛ config دستی فراموششده |
| Migrate | طرح DB همتراز کد | اجرای ناقص؛ قفل طولانی جدول |
| Run + healthcheck | سرویس پاسخگو | پورت باز اما وابستگی قطع |
| Rollback | Release قبلی | نبود بستهٔ قبلی؛ migrate یکطرفه |
نقش سبک CI و Environments در GitHub Actions
CI (Continuous Integration) معمولاً Build و تست را روی هر تغییر خودکار میکند تا Deploy روی پایهٔ سبز باشد. CD و جزئیات pipeline در مقالهٔ ۱۱۲؛ اینجا فقط پیوند مفهومی: Deploy نباید از لپتاپ «شاید تست شده» باشد اگر میتوانید همان Build را از سیستم مرکزی بگیرید.
مستندات GitHub دربارهٔ Deploying with GitHub Actions میگوید میتوانید workflow را با رویدادهایی مثل push، pull_request یا workflow_dispatch تریگر کنید. Environments نامهایی مثل production یا stagingاند با قانون حفاظتی: required reviewers، محدودیت شاخه، Secret مخصوص محیط. شغلی که environment را reference کند تا وقتی قانونها پاس نشوند شروع نمیشود و به Secretهای آن محیط دسترسی ندارد.
Concurrency کمک میکند در یک لحظه بیش از یک Deploy روی همان محیط روی هم نیفتند. اینها جایگزین فهم Build/Release نیستند؛ کنترل دسترسی و توالی را روی همان مفاهیم سوار میکنند.
مسیر مینیمال برای تیم کوچک
- شاخهٔ اصلی محافظتشده؛ Deploy Production فقط از آن.
- Build در CI با قفل وابستگی.
- Deploy خودکار یا یکدکمهای به Staging.
- تأیید انسانی کوتاه روی Staging.
- Deploy همان artifact به Production (ترجیحاً بدون rebuild جداگانه).
- healthcheck و آمادگی Rollback.
اگر هنوز CI ندارید، حداقل یک اسکریپت با نسخهٔ مشخص و فهرست فرمانهای migrate/healthcheck بنویسید تا Deploy وابسته به حافظه نباشد. کانتینر (مقالهٔ ۱۰۵) بستهبندی Build را یکدستتر میکند اما پیشنیاز درک استقرار نیست.
اشتباههای رایج استقرار
- ویرایش زنده روی سرور Production بدون commit.
- Deploy نیمهشب بدون healthcheck چون «کسی بیدار نیست ببیند».
- یک Build برای Staging و Build دیگر از روی لپتاپ برای Production.
- نداشتن Secret جدا و اشتباه گرفتن کلید Staging با Production.
- فرض اینکه سبز بودن تست واحد یعنی migrate و کانفیگ هم درستاند.
چه کسی Deploy را «تمامشده» اعلام میکند؟
تمامشدن آپلود فایل به معنی تمامشدن Deploy نیست. تعریف عملیاتی تمامشدن معمولاً شامل اینهاست:
- Release موردنظر روی همهٔ نمونههای لازم فعال است.
- healthcheckهای حیاتی سبزند.
- migrate با موفقیت و در زمان قابل قبول تمام شده.
- یک مسیر دود (smoke) کلیدی — مثلاً لاگین یا ایجاد سفارش تست — پاس شده.
- در صورت نیاز، اطلاع به پشتیبانی/محصول که نسخه عوض شده است.
بدون این تعریف، هر کسی معنای متفاوتی از «دیپلوی کردم» دارد. برای مالک محصول، یک چکلیست کوتاه روی Staging و Production از جلسهٔ طولانی وضعیت بهتر کار میکند.
استراتژیهای انتشار — فقط به اندازهٔ نیاز
لازم نیست از روز اول Blue-Green یا Canary پیاده کنید. اما خوب است بدانید گزینهها چه دردی را دوا میکنند:
- Rolling: نمونهها بهتدریج عوض میشوند؛ ساده روی چند instance.
- Blue-Green: دو محیط هماندازه؛ سویچ ترافیک؛ Rollback سریع با برگرداندن سویچ.
- Canary: درصد کمی از کاربران نسخهٔ جدید را میبینند؛ مناسب ریسک کنترلشده در Production.
برای یک VPS تکی، اغلب «متوقف کن، نسخه را عوض کن، healthcheck، برگرداندن در صورت شکست» کافی است — بهشرط پشتیبان و شناسهٔ Release. وقتی تعداد نمونه و حساسیت بالا رفت، سراغ الگوهای بالا بروید؛ ابزار را قبل از درد نخرید.
Artifact یکسان برای Staging و Production
یکی از قویترین عادتهای کمهزینه این است که همان بستهای که روی Staging تأیید شد به Production برود — نه اینکه Production دوباره از روی شاخه build شود و وابستگیها «شاید» فرق کنند. در دنیای کانتینر این یعنی همان image digest؛ در دنیای کلاسیک یعنی همان tarball یا همان شمارهٔ build CI.
GitHub Actions با جدا کردن jobهای build و deploy و استفاده از environmentهای جدا این الگو را پشتیبانی میکند: build یکبار، deploy به staging، سپس promote به production با تأیید. جزئیات workflow در ۱۱۲؛ اصلش این است که «بایت تأییدشده» جابهجا شود نه «دستور build دوباره».
ارتباط با خطاهای وب
بعد از Deploy، بخشی از خطاهای ۵xx و timeoutها اولین سیگنال شکست استقرارند. دانستن تفاوت خطای اپلیکیشن و خطای زیرساخت به تشخیص سریعتر کمک میکند؛ راهنمای جامعتر خطاهای وب در مقالهٔ ۰۲۲ است. از زاویهٔ Deploy: داشبورد خطا را در ۳۰ دقیقهٔ اول بعد از انتشار عمداً نگاه کنید.
چکلیست قبل از زدن دکمهٔ Production
- شناسهٔ Release/commit مشخص است و در لاگ ثبت میشود.
- Secret محیط Production جدا و کامل است.
- migrate روی Staging با همین اسکریپت موفق بوده.
- مسیر Rollback نوشته و اگر ممکن است یکبار تمرین شده.
- کسی مسئول نگاه کردن به healthcheck و خطاها در پنجرهٔ اول است.
- اگر تأیید انسانی لازم است، در environment یا فرایند تیمی جا دارد نه در چت شلوغ.
پنجرهٔ مراقبت بعد از انتشار
بسیاری از شکستها دقیقاً موقع Deploy دیده نمیشوند؛ ۱۵ تا ۶۰ دقیقه بعد با ترافیک واقعی ظاهر میشوند. برای انتشارهای غیرپیشپاافتاده یک پنجرهٔ مراقبت تعریف کنید: چه متریک یا لاگی، چه کسی بیدار است، و آستانهٔ Rollback چیست. بدون آستانه، بحث «شاید خودش درست شود» طول میکشد تا خسارت بزرگ شود.
مراقبت به معنی وحشت نیست. یعنی داشبورد خطا، latency، و یک مسیر دود از پیش تعیینشده. اگر تیم کوچک هستید، حتی یک checklist دستی در همان نیمساعت اول ارزش دارد. مقالهٔ مانیتورینگ جداگانه عمیقتر میشود؛ اینجا فقط پیوند استقرار و مشاهده است.
Deploy دستی در برابر خودکار — تصمیم مرحلهای
خودکارسازی زود هنگام روی مسیر اشتباه، خرابی را سریعتر به Production میرساند. ترتیب عقلانی برای خیلی از تیمها:
- مسیر دستی اما مستند و با شناسهٔ Release.
- Build و تست خودکار (CI) بدون Deploy خودکار.
- Deploy خودکار به Staging.
- Deploy به Production با تأیید یا از روی تگ/Release.
پرش از مرحلهٔ ۱ به «هر push روی main برود Prod» فقط وقتی دفاعپذیر است که تست، migrate و Rollback واقعاً پخته باشند. GitHub Actions این مراحل را ممکن میکند؛ اجبار نمیکند همه را روز اول روشن کنید.
زبان مشترک با افراد غیرتکنیکال
بهجای گفتن «pipeline شکست خورد» بگویید کدام مرحله: Build بسته نشد، Release با config غلط ساخته شد، migrate طول کشید، یا healthcheck بعد از Run قرمز شد. این واژگان ۱۲-Factor به محصول و پشتیبانی کمک میکند سوال درست بپرسند و فشار نابهجا روی «فقط سریع آپلود کنید» کم میشود.
Deployment موفق خروجی مهندسی alone نیست؛ توافق روی معنی «تمام شد»، آمادگی Rollback، و احترام به مرز محیطهاست. با این سه، حتی ابزار ساده قابل دفاع است؛ بدون آنها، ابزار پیچیده فقط سرعت حادثه را بالا میبرد.
قرارداد نسخه با پشتیبانی و محصول
بعد از هر Deploy Production، یک پیام کوتاه داخلی کافی است: شناسهٔ Release، زمان، تغییرات کاربرقابلمشاهده، و وضعیت Rollback. پشتیبانی نباید از توییتر کاربر بفهمد نسخه عوض شده. این عادت هزینهٔ نزدیک به صفر دارد و زمان تشخیص مشکل را کم میکند.
اگر انتشار بزرگ است، پنجرهٔ نگهداری از پیش اعلامشده بهتر از قطع ناگهانی است — حتی برای محصول کوچک. استقرار فقط مسئلهٔ لولهٔ فنی نیست؛ مسئلهٔ قول به کاربر دربارهٔ در دسترس بودن است. وقتی قول و لوله با هم هماهنگ باشند، Deployment از «آپلود استرسزا» به «تحویل قابل تکرار» تبدیل میشود.
جمعبندی برای تصمیم
Deployment مسیر کنترلشده از commit تا کاربر است: Build ثابت، Release شناسهدار با config محیط، migrate آگاهانه، healthcheck، Rollback آماده. Twelve-Factor این جداسازی را صورتبندی میکند؛ GitHub Actions Environments نمونهٔ عملی کنترل دسترسی و تأیید روی همان مسیر است.
اگر یک بهبود این هفته میخواهید: به هر Deploy یک شناسه بدهید، healthcheck اضافه کنید، و یکبار Rollback را روی Staging تمرین کنید. بعد سراغ خودکارسازی بیشتر در CI/CD بروید.
منابع و مراجع
- The Twelve-Factor App — V. Build, release, run — https://12factor.net/build-release-run
- GitHub Docs — Deploying with GitHub Actions — https://docs.github.com/en/actions/deployment/about-deployments/deploying-with-github-actions
برای مرز محیطها ۰۴۸ و ۰۴۹، برای Secret در مسیر Deploy مقالهٔ ۰۴۷، و برای pipeline کامل مقالهٔ ۱۱۲ را ببینید.
Author
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.




