تعیین اندازهٔ سرور: RAM، CPU و Storage بر اساس Workload
راهنمای تعیین اندازهٔ RAM، CPU و Storage بر اساس نوع بار کاری — بدون بنچمارک جعلی فروشنده؛ با منطق مشاهده، رشد تدریجی و ارجاع به مفاهیم رسمی انواع نمونه.
Founder & product engineer

سؤال «چقدر RAM بخریم؟» بدون دانستن Workload (بار کاری) مثل پرسیدن «چقدر بنزین؟» بدون دانستن مسیر است. فروشندهها بستهٔ آماده میفروشند؛ بنچمارکهای تبلیغاتی اغلب با Workload شما بیربطاند. این مقاله عمداً عدد جادویی و جدول جعلی برند ارائه نمیدهد.
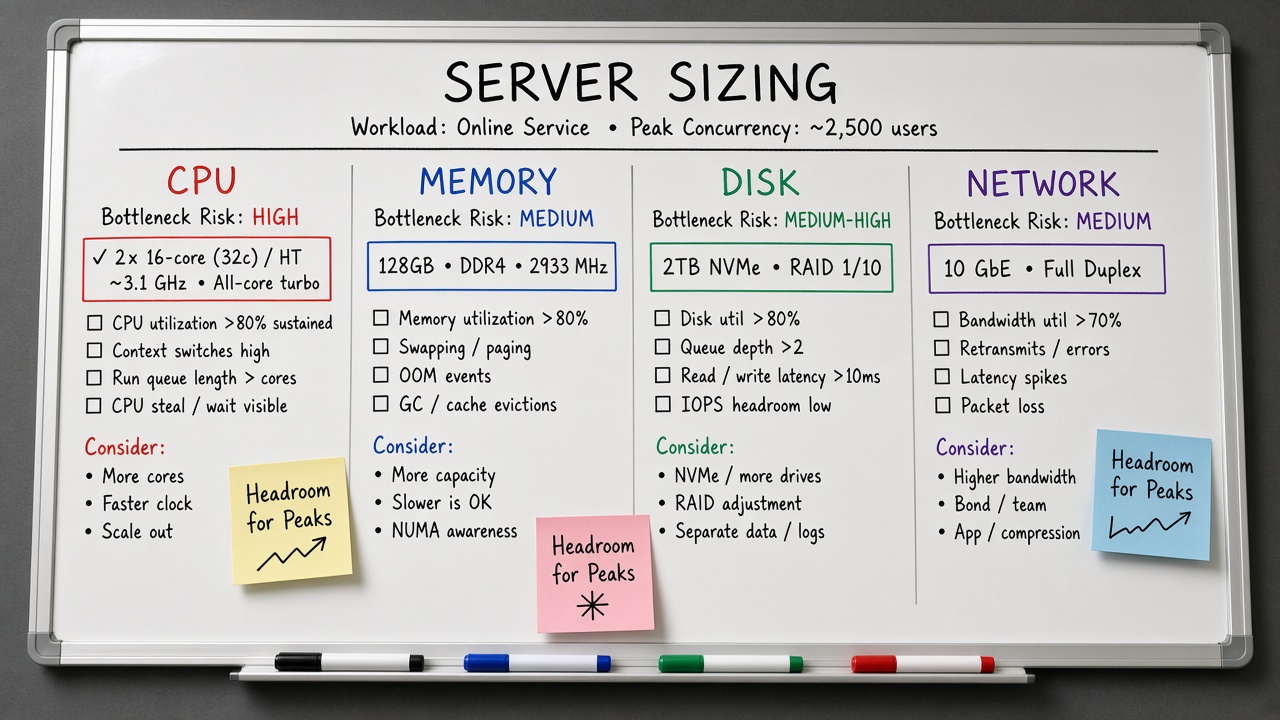
منطق درست: بار را به فشار روی CPU، حافظه، دیسک و شبکه تجزیه کنید؛ اندازه را از کوچک قابلمشاهده شروع کنید؛ با متریک واقعی رشد دهید. ابرها خانوادهٔ نمونهٔ عمومی، محاسبهسنگین، حافظهسنگین و ذخیرهسنگین دارند — همین دستهبندی مفهومی برای VPS هم مفید است حتی اگر نام خانوادهها فرق کند.
پیشنیاز: بدانید اپ شما I/Oمحور است یا CPUمحور (مقالهٔ ۱۱۷ و معرفی Node دربارهٔ تفاوت کار مسدودکننده). دیتابیس جدا یا همنشین است (۱۱۸). معماری مونولیت یا چند سرویس است (۱۲۰).
پاسخ کوتاه
CPU را برای کار محاسباتی و تعداد workerهای مفید اندازه بگیرید؛ RAM را برای مجموعهٔ کاری فعال (اپ + کش فرایند + بافر دیتابیس)؛ Storage را جدا برای ظرفیت و برای IOPS/latency. از حدس «۱۶ گیگ برای همه» پرهیز کنید. یک نمونهٔ کوچک با مانیتورینگ، زیر بار شبیه تولید، بیشتر از اسلاید فروش میگوید.
اگر فقط یک عدد میخواهید: عددی که با مشاهدهٔ Staging در اوج مورد انتظار بهعلاوهٔ حاشیهٔ ایمنی معقول بهدست آمده، نه عددی که در گروه تلگرام شنیدهاید.
ظرفیتگذاری بدون متریک، خرید احساس امنیت است نه مهندسی.
Workload را به چهار فشار بشکنید
| فشار | نشانه | اشتباه تفسیر |
|---|---|---|
| CPU | اشباع هسته، صف طولاتری درخواست، کندی پردازش | خرید RAM بیشتر وقتی محاسبه سنگین است |
| RAM | Swap، OOM، کش دیتابیس بیاثر | افزودن CPU وقتی حافظه تنگ است |
| Storage ظرفیت | دیسک پر، لاگ/بکاپ شکست | نادیده گرفتن رشد فایل و ایندکس |
| Storage I/O | انتظار دیسک، قفل، کندی کوئری با CPU بیکار | دیسک بزرگتر بهجای سریعتر/بهینهتر |
شبکه هم فشار پنجم است: پهنای باند و تعداد اتصال. برای API پراتصال، محدودیت file descriptor و اتصال همزمان را هم ببینید.
CPU: چه چیزی هسته میخواهد؟
کارهای CPUمحور: رندر پیچیده، رمزنگاری سنگین، پردازش تصویر/ویدئو، فشردهسازی، برخی aggregations. کارهای I/Oمحور: انتظار دیتابیس، HTTP بیرونی، خواندن فایل — اینجا هستهٔ زیاد بدون بهبود I/O کمتر کمک میکند.
در مدلهایی مثل Node که حلقهٔ رویداد با کار طولانی CPU آسیب میبیند، افزودن هسته alone کافی نیست مگر worker/cluster درست پیکربندی شود. در سرویسهای چندنخی، تعداد worker را با هسته و ماهیت کار همتراز کنید؛ کپی کورکورانه از «۲× تعداد هسته» بدون اندازهگیری افسانه است.
- متریک: CPU utilization، load average، زمان پردازش درخواست (نه فقط میانگین؛ صدک).
- آزمایش: افزایش تدریجی RPS تا شکستگی؛ ببینید CPU اشباع میشود یا انتظار I/O.
RAM: مجموعهٔ کاری فعال
حافظه باید اپ، runtime، بافر اتصال، و در صورت همنشینی دیتابیس، cache صفحات/ایندکس را جا بدهد. اگر دیتابیس جداست، RAM سرور اپ و RAM سرور داده را قاطی نکنید.
نشانهٔ کمبود: Swap مزمن،Restartهای OOM، سقوط hit rate کش داخلی. نشانهٔ زیادخری: حافظهٔ آزاد پایدار بزرگ بدون رشد مجموعهٔ کاری — پول روی میز، ولی خطرناک نیست؛ فقط ناکارآمد است.
برای لایهٔ Redis جدا، اندازه را از حجم دادهٔ داغ بهعلاوهٔ overhead ساختار و سیاست eviction بسازید؛ نه از روی «همان اندازهٔ اپ».
Storage: ظرفیت ≠ سرعت
دو سؤال جدا: چند گیگابایت لازم دارید؟ و چند عملیات I/O در ثانیه با چه تأخیری؟ لاگ، آپلود کاربر، ایندکس دیتابیس و بکاپ رشد ظرفیت را میسازند. کندی کوئری روی دیسک شلوغ اغلب شبیه «کمبود CPU» به نظر میرسد.
- دادهٔ پرتغییر دیتابیس را روی حجم با IOPS مناسب بگذارید.
- بکاپ و آرشیو را از مسیر I/O تولید جدا کنید تا اوج پشتیبانگیری کاربر را نزند.
- رشد لاگ را با چرخش و سقف حجم مهار کنید قبل از خرید دیسک ابدی.
روش عملی Right-sizing بدون عدد جعلی
- در Staging متریک CPU، RAM، دیسک، صف درخواست و تأخیر صدک را روشن کنید.
- یک سناریوی بار نزدیک به اوج واقعی بسازید (نه فقط صفحهٔ خانه).
- از اندازهٔ کوچک شروع کنید و فقط فشاری را که اشباع شده بالا ببرید.
- بعد از هر تغییر یک فرض بنویسید: «با این تغییر انتظار داریم متریک X کم شود».
- در Production همان داشبورد را نگه دارید و آستانهٔ هشدار تعریف کنید.
اگر ارائهدهنده خانوادهٔ نمونهٔ compute/memory/storage دارد، انتخاب خانواده را با نوع فشار انجام دهید؛ بعد داخل همان خانواده اندازه را جابهجا کنید. پرش بین خانوادهها بدون تشخیص فشار، تیر در تاریکی است.
الگوهای رایج بار وب
| الگوی تقریبی | فشار غالب | جهت سایز |
|---|---|---|
| API JSON سبک + DB جدا | اغلب I/O و اتصال | CPU متوسط؛ RAM برای اتصال/runtime؛ دقت روی DB |
| رندر یا پردازش فایل | CPU و گاهی دیسک | خانوادهٔ compute؛ صف جدا برای کار سنگین |
| دیتابیس همنشین روی یک VM | RAM و I/O دیسک | جدا کردن DB زودتر از خرید جعبهٔ عظیم |
| کش Redis جدا | RAM | اندازه از دادهٔ داغ؛ پایداری و persistence جدا تصمیم |
اینها نقطهٔ شروع مشاهدهاند نه نسخه. محصول شما ممکن است مخلوط باشد.
حاشیهٔ ایمنی و هزینه
حاشیهٔ ۲۰–۴۰٪ بالای اوج مشاهدهشده برای بسیاری از تیمهای کوچک معقول است؛ حاشیهٔ ۱۰× «برای احتیاط» معمولاً ترس قیمتگذارینشده است. در ابر، مقیاس افقی (نمونهٔ بیشتر) را وقتی کار بیوضعیت است با مقیاس عمودی (جعبهٔ بزرگتر) مقایسه کنید. در VPS ثابت، رشد عمودی و مهاجرت را از قبل تمرین کنید.
چه چیزهایی را در بنچمارک فروشنده باور نکنید؟
- عدد RPS بدون توضیح سناریو، اندازهٔ پاسخ و آیا DB در مسیر است.
- مقایسهٔ بین زبانها روی سختافزار نامشخص.
- ادعای «کافی برای ۱۰۰٬۰۰۰ کاربر» بدون تعریف کاربر فعال همزمان.
بنچمارک داخلی خودتان با همان کد و همان دادهٔ نزدیک به تولید، تنها بنچمارک معتبر برای سایز شماست.
جمعبندی
RAM، CPU و Storage را از روی Workload و متریک انتخاب کنید نه از روی بستهٔ پیشنهادی یا بنچمارک بیمنبع. فشار را تشخیص دهید، کوچک شروع کنید، یکمتغیر را تغییر دهید، و مشاهده کنید. دروغ بزرگ ظرفیتگذاری، عدد دقیق بدون سناریو است.
منابع و مراجع
- AWS — Amazon EC2 instance types (مفهوم خانوادهٔ بار): https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/instance-types.html
- AWS RDS — Choosing your database engine (تناسب موتور با کار؛ زمینهٔ بار داده): https://docs.aws.amazon.com/AmazonRDS/latest/gettingstartedguide/choosing-engine.html
- Node.js Learn — Introduction to Node.js (مدل I/O و پیامد کار مسدودکننده): https://nodejs.org/en/learn/getting-started/introduction-to-nodejs
این هفته روی Staging یک تست بار کوچک برای مسیر Checkout یا معادلش اجرا کنید و فقط یک متریک اشباع را بالای صفحهٔ داشبورد بگذارید.
Author
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.