

آمادهسازی سرور لینوکس برای Production: چکلیست عملی
از تصویر خام تا سرویس پایدار: کاربر، بهروزرسانی، زمان، SSH، فایروال، مانیتورینگ، بکاپ و rollback قبل از ترافیک واقعی.
Founder & product engineer
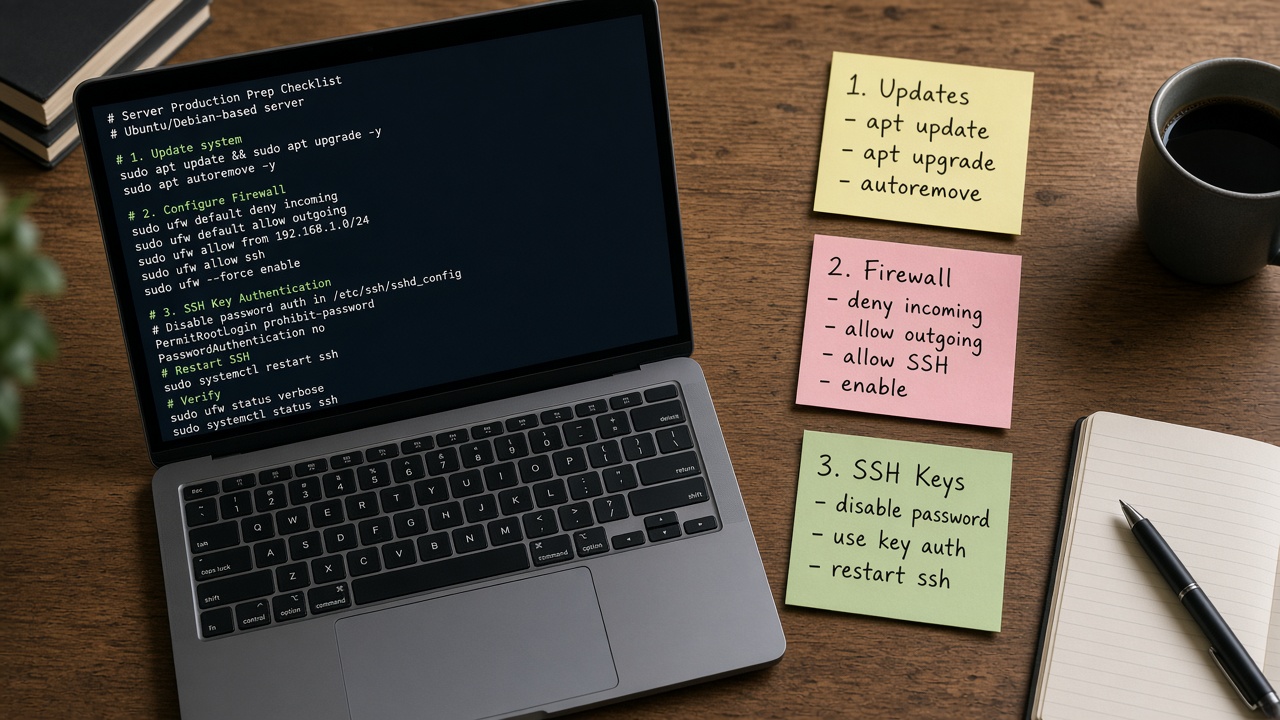
تصویر ابری تازه boot شده «کار میکند»، ولی برای production کافی نیست: ساعت ممکن است منحرف باشد، ورود root با رمز باز باشد، فایروال خاموش باشد، دیسک بدون هشدار پر شود، و هیچ مسیر rollbackای وجود نداشته باشد. آمادهسازی یعنی قبل از ترافیک واقعی، پایهٔ عملیاتی و امنیتی را عمداً بسازید — نه اینکه بعد از اولین حادثه وصله کنید.
این چکلیست توزیعآگاه است با تمرکز روی الگوهای رایج اوبونتو/دبیانمانند؛ اصول به RHEL-مانند هم ترجمه میشود.
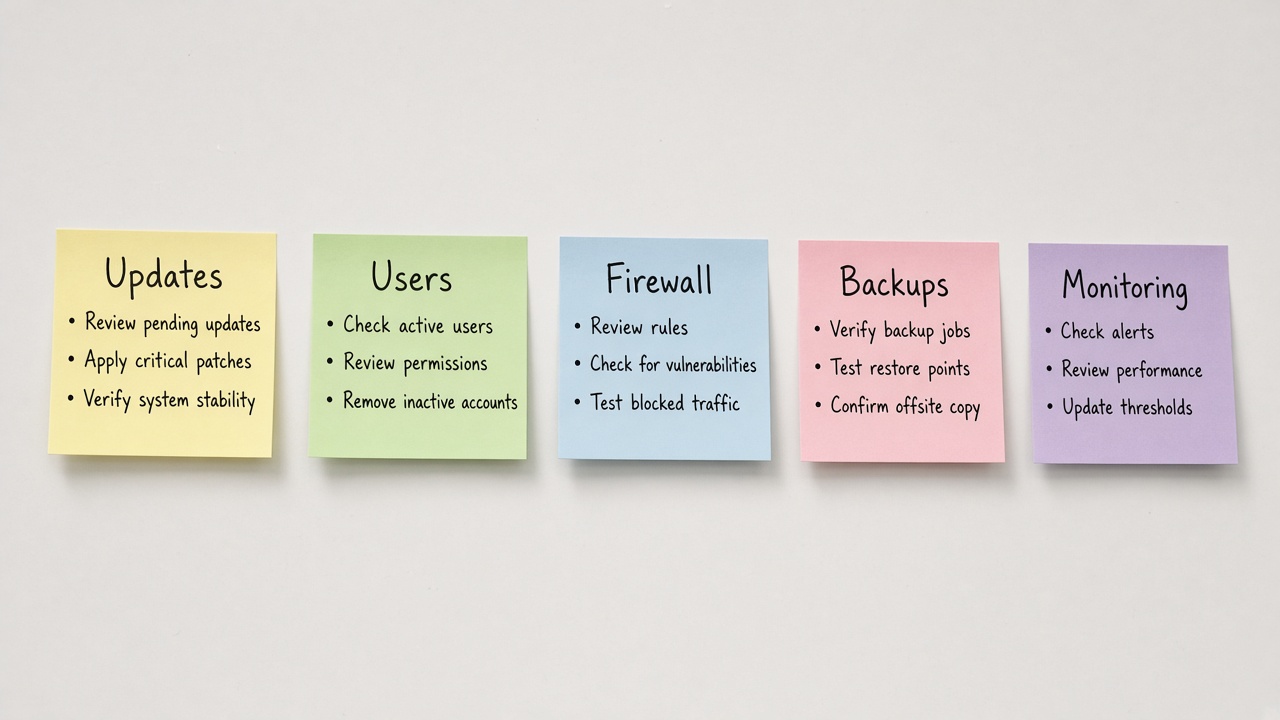
پاسخ کوتاه
ترتیب پیشنهادی: دسترسی امن (کاربر sudo + کلید SSH) → بهروزرسانی و زمان → حداقل پکیج → فایروال با اجازهٔ مدیریت → سرویس فقط روی پورتهای لازم → لاگ و مانیتورینگ → بکاپ و تمرین بازیابی → سپس دیپلوی اپ. هر مرحله را قبل از مرحلهٔ بعدی تأیید کنید تا خودتان را بیرون قفل نکنید.
Production یعنی بتوانید خراب شدن را ببینید، محدود کنید و برگردید — نه فقط اینکه سرویس یکبار 200 بدهد.
۱) هویت، دسترسی و SSH
- کاربر عادی با sudo بسازید؛ ورود روزمره با root را کنار بگذارید.
- کلید SSH را نصب و تست کنید؛ بعد password را ببندید.
- PermitRootLogin و PasswordAuthentication را طبق سیاست سخت کنید (مقالهٔ سختسازی SSH).
- دسترسی console ابر را قبل از آزمایشهای خطرناک تأیید کنید.
bash
whoami sudo -l sshd -T | grep -Ei 'permitrootlogin|passwordauthentication'
۲) زمان، نام میزبان و بهروزرسانی
گواهی TLS، لاگهای همبسته، و برخی پروتکلها به ساعت درست وابستهاند.
bash
sudo timedatectl set-timezone Asia/Tehran # نمونه؛ منطقهٔ واقعی تیم را بگذارید timedatectl status sudo hostnamectl set-hostname app-prod-1 sudo apt update && sudo apt -y upgrade
روی اوبونتو، `unattended-upgrades` معمولاً بهروزرسانی امنیتی را خودکار میکند؛ سیاست reboot و blacklist بستههای حساس را آگاهانه تنظیم کنید — نه اینکه غافلگیر شوید.
۳) سطح حملهٔ نرمافزاری
- بستهٔ غیرلازم را نصب نکنید؛ هر باینری یعنی CVE بالقوه و سطح نگهداری.
- سرویسهای پیشفرض ناخواسته را disable کنید.
- مخازن شخص ثالث را فقط با نیاز و امضای مشخص اضافه کنید.
bash
systemctl list-unit-files --state=enabled ss -tulpn
۴) شبکه و فایروال
پیشفرض: deny ورودی، allow خروجیِ لازم، allow صریح برای SSH و پورت اپ. اول SSH را allow کنید بعد enable.
bash
sudo ufw allow OpenSSH sudo ufw allow 443/tcp sudo ufw enable sudo ufw status verbose
Security Group ابر را همتراز کنید. سرویسهای داخلی را به localhost یا شبکهٔ خصوصی bind کنید.
۵) دیسک، حافظه و پایداری
- جدا بودن /var یا حداقل هشدار روی پر شدن ریشه.
- Swap متناسب با سایز (با فهم مقالهٔ حافظه).
- چرخش لاگ و سقف journal.
- فضای کافی برای رشد داده و فایلهای موقت استقرار.
bash
df -hT free -h journalctl --disk-usage
۶) مشاهدهپذیری حداقل
بدون متریک و لاگ، production تقلبی است. حداقل:
- heartbeat سرویس و health HTTP.
- هشدار دیسک، حافظهٔ available، و load نسبت به nproc.
- جمعآوری journal یا فایل لاگ اپ در جایی که با خود سرور نابود نشود.
- ساعت و timezone یکسان در همهٔ گرهها.
۷) بکاپ، رمز و بازیابی
بکاپ بدون تست بازیابی نمایشی است. مسیرهای پیکربندی (`/etc`)، دادهٔ اپ، و اسرار را جدا فکر کنید. اسرار را در git نگذارید؛ از مکانیزم secret مدیر ابر یا vault استفاده کنید.
۸) استقرار و rollback
- نسخهبندی artifact و ثبت نسخهٔ در حال اجرا.
- قابلیت برگشت سریع به نسخهٔ قبل.
- مهاجرت دیتابیس با جهتگیری جلو/عقب مشخص.
- پنجرهٔ تغییر و معیار abort.
جدول قبل از باز کردن ترافیک
| حوزه | تمام شد؟ | شاهد |
|---|---|---|
| SSH کلید-محور | ورود تست از ماشین دوم | |
| فایروال | ufw status + SG | |
| زمان | timedatectl | |
| بهروزرسانی | نیاز reboot؟ | |
| پورتهای listen | ss -tulpn | |
| هشدار دیسک/RAM | آلارم تستی | |
| بکاپ | بازیابی آزمایشی | |
| rollback | تمرین روی staging |
اشتباههای رایج در روز اول
- دیپلوی اپ قبل از بستن password SSH.
- باز کردن 0.0.0.0/0 روی همهٔ پورتها.
- نداشتن swap و مانیتور و تعجب از OOM.
- لاگ فقط روی همان دیسک داده بدون چرخش.
- تغییر تولید بدون staging همشکل.
چه چیزی عمداً این چکلیست نیست؟
اینجا جایگزین معماری HA، compliance صنعت، یا سختسازی کامل CIS نیست. پایهٔ «یک میزبان تنها که نباید در ۲۴ ساعت اول سوراخ شود» است. برای بار حساس، لایههای بیشتری از مقالهٔ امنیت اوبونتو و کنترلهای سازمانی اضافه کنید.
حداقل سند عملیاتی یکصفحه
قبل از ترافیک، یک صفحه در wiki تیم کافی است اگر واقعی باشد: چگونه SSH میکنیم، کجا بکاپ است، چگونه rollback میکنیم، چه آلارمهایی مهماند، و چه کسی on-call است. بدون این صفحه، چکلیست فنی در حادثهٔ نیمهشب به جستجوی پراکنده تبدیل میشود.
جداسازی محیطها
همان تصویر و همان چکلیست را روی staging اجرا کنید تا اولینبار روی production غافلگیر نشوید. تفاوتهای آگاهانه (سایز کوچکتر، دادهٔ مصنوعی) را بنویسید. کپی کردن دستی کانفیگ با scp بدون نسخه، ضدالگوی رایج است — حداقل یک مخزن IaC یا conf مدیریتشده داشته باشید.
سختگیری تدریجی بهتر از قفل یکجا
در روز اول همهٔ کنترلهای ممکن را یکجا اعمال نکنید. ترتیب ضدقفل مقالهٔ امنیت اوبونتو را رعایت کنید: اول دسترسی پایدار، بعد فیلتر شبکه، بعد سیاستهای سختتر. هر مرحله را با تست اتصال و healthcheck ببندید.
معیار «آمادهٔ ترافیک»
- Healthcheck سبز از خارج از سرور (از طریق مسیر واقعی کاربر).
- آلارم دیسک و سرویس حداقل یکبار عمداً تریگر و Acknowledge شده.
- نسخهٔ مستقر و commit/artifact در جایی ثبت شده.
- مسیر rollback در ۳۰ دقیقه روی staging زمانگیری شده.
امنیت در برابر سرعت تحویل
فشار «همین امروز برویم بالا» معمولاً همان چیزی است که چکلیست را نصفهکاره میگذارد. راه سازنده این است که حداقلهای غیرقابلمذاکره را از قبل ثابت کنید: SSH کلید-محور، فایروال، بهروزرسانی، ساعت، هشدار دیسک. بقیه را میتوان در اسپرینت بعد تکمیل کرد. اگر حداقلها تعریف نشده باشند، هر بار همهچیز مذاکرهپذیر میشود و هیچچیز تمام نمیشود.
برای سرویسهای مشتریپرداخت، معیار آماده بودن باید شامل مسیر پشتیبانی هم باشد: چگونه لاگ را پیدا میکنیم، چگونه نسخه را میفهمیم، چگونه rollback میکنیم. نبود اینها هزینهٔ پشتیبانی را بلافاصله بعد از لانچ نشان میدهد.
اتوماسیون را از روز اول حتی اگر با یک اسکریپت ساده باشد جدی بگیرید. سروری که با بیست فرمان دستی بالا آمده قابلبازتولید نیست و در مقیاس دو هم میشکند. چکلیست این مقاله را به نقشهای برای همان اسکریپت یا playbook تبدیل کنید.
در پایان، یک مرور بعد از لانچ در ۴۸ ساعت اول بگذارید: چه آلارمهایی نویز بودند، چه چیزی جا افتاد، چه دسترسی اضافهای باز ماند. production یک لحظه نیست؛ یک حالت نگهداشت است.
تصویر طلایی و تکرارپذیری
بهجای آمادهسازی دستی هر سرور از صفر، یک تصویر یا playbook طلایی بسازید که کاربر، sshd drop-in، ufw پایه، عامل مانیتورینگ و تنظیم زمان را از قبل دارد. لانچ production آنگاه بیشتر «نقش دادن» است تا «اختراع دوباره». هزینهٔ ساخت تصویر در هفتهٔ اول برمیگردد وقتی دومین و سومین محیط را میسازید.
تصویر طلایی را نسخه بزنید و تغییرات را changelog کنید. تصویری که بدون نسخه جلو میرود خیلی زود به همان آشوب دستی تبدیل میشود. هر تغییر امنیتی مهم باید شمارهٔ تصویر را بالا ببرد تا بدانید کدام ماشینها عقب ماندهاند.
برای دادههای پایدار، جدا از تصویر فکر کنید: volume داده، سیاست بکاپ، و رمزگذاری در سکون. قاطی کردن داده با تصویر سیستمعامل بازیابی را سخت میکند.
در نهایت، تمرین بازیابی کل محیط را دستکم سالی دو بار انجام دهید — حتی اگر فقط روی staging باشد. production آمادهاست وقتی میتوانید بدون قهرمانی دوباره بسازیدش.
جمعبندی مسیر ۳۰/۶۰/۹۰ دقیقهای
۳۰ دقیقهٔ اول: دسترسی و SSH و زمان و بهروزرسانی. ۶۰ دقیقه: فایروال، پورتها، سلامت دیسک/حافظه. ۹۰ دقیقه: مانیتورینگ حداقلی و تأیید بکاپ. اگر زمان کم دارید، از این برشها کوتاه نکنید تا به «دپلوی سریع» برسید؛ دپلوی بدون آنها فقط تعریف حادثه را جلو میاندازد.
هر مرحله را با یک شاهد ببندید و به صفحهٔ آمادهسازی تیک بزنید. تیم بعدی باید بتواند بدون پرسیدن از شما همان مسیر را تکرار کند. تکرارپذیری همان production است.
وقتی سرویس بالا آمد، ۴۸ ساعت اول را شیفت مراقبت حساب کنید: آلارمها، رشد دیسک، خطاهای نادر. لانچ پایان کار نیست؛ شروع مشاهده است.
معیار پذیرش نهایی قبل از DNS عمومی
قبل از اینکه رکورد عمومی را به سرور بچسبانید: از یک ماشین خارج از شبکهٔ خصوصی healthcheck بگیرید، گواهی را بررسی کنید، نرخ خطای مصنوعی صفر باشد، و rollback را یکبار خشک تمرین کرده باشید. باز کردن DNS عمومی بدون اینها یعنی کاربران اولین تسترهای شما میشوند.
اگر behind CDN یا WAF میروید، همان تستها را یکبار به origin و یکبار از لبه انجام دهید. هر لایه میتواند سلامت را پنهان یا خراب کند.
پس از اتصال DNS، ۲۴ ساعت اول را با حساسیت آلارم بالاتر بگذرانید و بعد آستانهها را به حالت عادی برگردانید. این شیفت مراقبت بخشی از آمادهسازی است نه کار اضافه.
در سند لانچ، زمان قطع DNS و مالک تصمیم abort را هم بنویسید تا در فشار، بحث مبهم شروع نشود.
وابستگیهای بیرونی را فراموش نکنید
سرور شما ممکن است آماده باشد ولی DNS، درگاه پرداخت، صف پیام مدیریتشده یا رجیستری ایمیج نه. در چکلیست لانچ، وابستگیهای بیرونی و مالک هر کدام را بنویسید و سلامتشان را قبل از ترافیک بسنجید. بسیاری از «لانچهای شکستخورده» در واقع میزبان سالم با وابستگی ناسالماند.
برای هر وابستگی یک رفتار شکست مشخص کنید: timeout، مدارشکن، یا حالت read-only. سکوت در برابر خطای بیرونی، کاربر را با اسپینر تنها میگذارد و شما را با تیکتهای مبهم.
اگر این معیارها را به قالب لانچ تیم تبدیل کنید، هر محیط جدید از همان روز اول کمتر شبیه استثنای دستی و بیشتر شبیه نسخهٔ قابلپشتیبانی از production خواهد بود.
خلاصه
Production با ترتیب ساخته میشود: دسترسی امن، سیستم بهروز و همزمان، سطح حملهٔ کم، شبکهٔ فیلترشده، ظرفیت قابلمشاهده، بکاپ آزموده، و مسیر برگشت. وقتی اینها سبز شدند، ترافیک را راه بدهید — نه زودتر.
سوالات متداول
آیا یک سرور تنها میتواند production باشد؟
بله برای بارهای کوچک، با پذیرش ریسک تکنقطهای. بکاپ و تصویر قابلبازسازی را جدیتر بگیرید.
اول Docker یا اول سختسازی میزبان؟
اول میزبان: SSH، فایروال، زمان، بهروزرسانی. کانتینر روی میزبان ناامن، حمله را جابهجا میکند نه حذف.
چقدر طول میکشد؟
برای یک VM ساده، با چکلیست آماده، اغلب کمتر از یک ساعت تا پایهٔ امن؛ مانیتورینگ و بکاپ ممکن است بیشتر بخواهد.
منابع و مراجع
- Ubuntu Server — Security overview: https://documentation.ubuntu.com/server/how-to/security/
- Ubuntu Server — Automatic updates: https://documentation.ubuntu.com/server/how-to/software/automatic-updates/
- Ubuntu Server — Firewalls: https://documentation.ubuntu.com/server/how-to/security/firewalls/
- OpenSSH sshd_config(5): https://man.openbsd.org/sshd_config.5
- systemd timedatectl: https://www.freedesktop.org/software/systemd/man/latest/timedatectl.html
Author
Soheil Ebrahimpour is the founder of FutureForge. He works on product design, architecture, and getting custom software into production.
Related notes
If you are unsure about architecture or the build path, we can talk about the project.
Describe the problem and the constraints. If there is a fit, we will schedule a conversation.




