

فضای دیسک در لینوکس: df، du و پیدا کردن مصرفکنندهها
وقتی دیسک پر میشود چه کنید: تفاوت inode و بلوک، خواندن df و du، پیدا کردن دایرکتوریهای سنگین، لاگها و اشتباههای رایج.
بنیانگذار و مهندس محصول
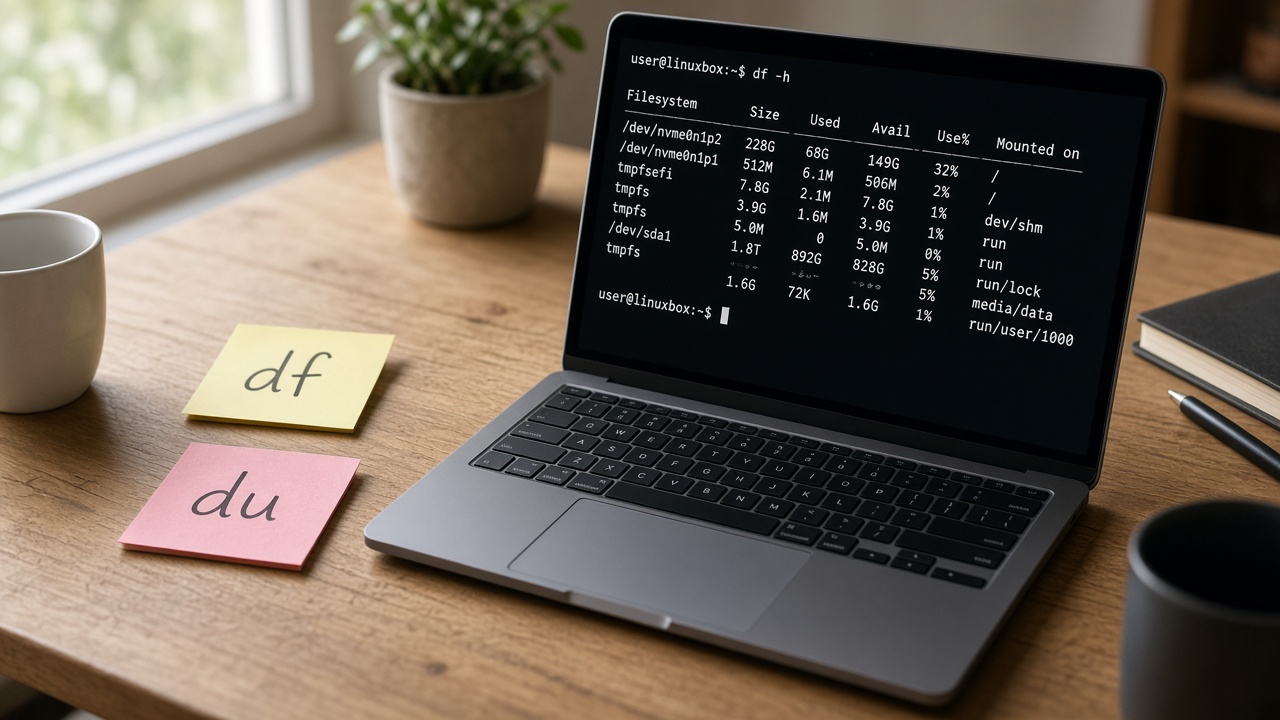
سرویس ناگهان خطای «No space left on device» میدهد، apt شکست میخورد، یا دیتابیس نمیتواند WAL بنویسد — اغلب قبل از اینکه مانیتورینگ «دیسک پر» را فریاد بزند. فضای دیسک در لینوکس فقط یک عدد درصد نیست: بلوکهای داده، inodeها، mountهای جدا، و فایلهای حذفشدهای که هنوز بازند، هر کدام میتوانند ظاهر «جا هست / جا نیست» را عوض کنند.
این مقاله از مشکل شروع میکند، ابزارهای استاندارد را با معنی واقعیشان توضیح میدهد، مسیر عیبیابی را مرحلهبهمرحله میچیند، و اشتباههایی را نشان میدهد که دیسک را دوباره پر میکنند.
پاسخ کوتاه
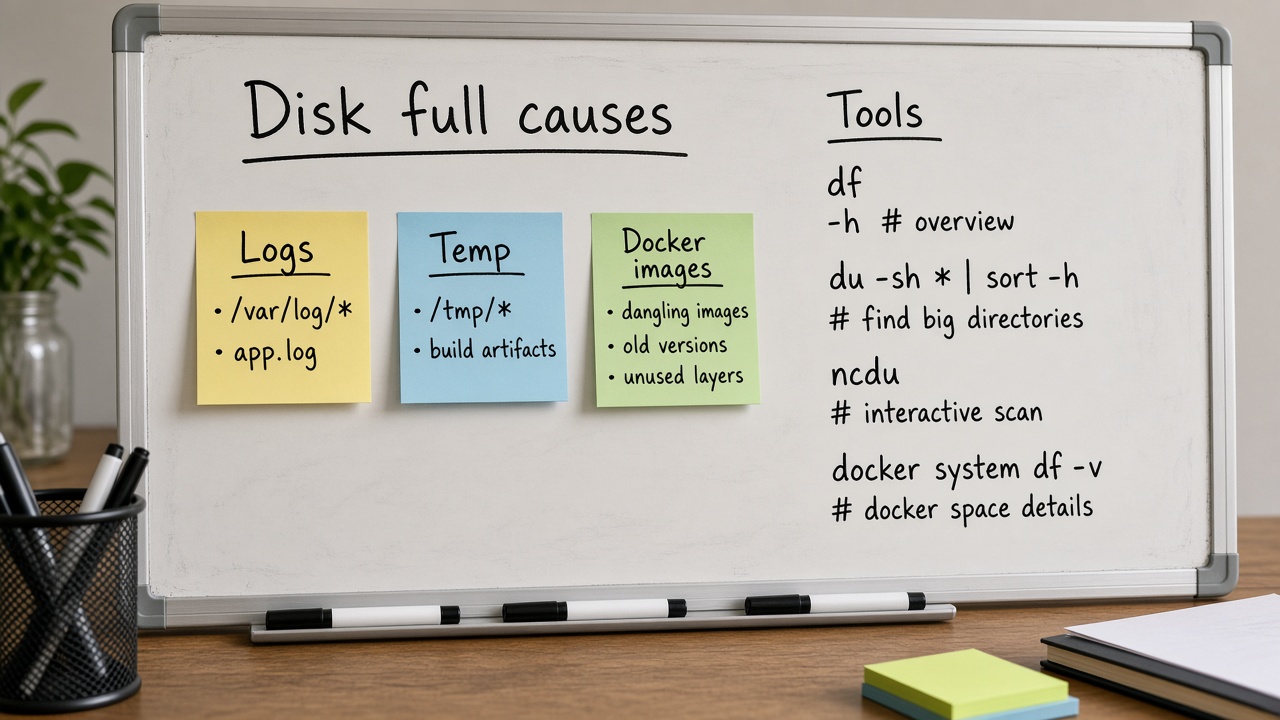
اول با `df -h` ببینید کدام فایلسیستم پر است؛ با `df -i` inode را چک کنید. بعد روی همان mount با `du -xh --max-depth=1` یا ابزار تعاملی مثل ncdu دایرکتوری سنگین را پیدا کنید. لاگهای `/var/log`، کش پکیج، بکاپهای قدیمی، Docker layers و فایلهای بزرگ کاربر را جدا بررسی کنید. اگر df پر نشان میدهد ولی du کم است، احتمالاً فایل حذفشده هنوز توسط پروسس باز است.
همیشه اول mount پر را مشخص کنید؛ du بدون دانستن ریشهٔ فایلسیستم زمان را میسوزاند.
مشکل واقعی چیست؟
روی یک VPS رایج، ریشه (`/`) ممکن است ۲۰ گیگ باشد و `/var` یا `/home` جدا نباشد. یک لاگ چرخشنشده، dump هسته، یا لایهٔ Docker کافی است تا ریشه پر شود. پیام خطا ممکن است از اپلیکیشن بیاید نه از کرنل؛ پس باید از لایهٔ فایلسیستم شروع کنید نه از حدس دربارهٔ کد.
- نصب بسته و نوشتن در /var/cache یا /var/lib شکست میخورد.
- لاگنویسی متوقف یا سرویس restart loop میشود.
- دیتابیس یا صف پیام نمیتواند دادهٔ جدید بنویسد.
- گاهی فقط یک پارتیشن خاص (مثلاً /tmp) پر است و بقیه آزادند.
مفهوم: بلوک، inode و mount
هر فایلسیستم (ext4، xfs، btrfs و …) دو منبع محدود دارد که اغلب با هم اشتباه گرفته میشوند:
- فضای داده (block space): بایتهایی که محتوای فایل را نگه میدارند — همان چیزی که df -h نشان میدهد.
- inode: ساختار فراداده برای هر فایل/دایرکتوری. اگر میلیونها فایل کوچک بسازید، inode تمام میشود در حالی که هنوز گیگابایت خالی دارید.
- mount point: هر پارتیشن یا volume جداگانه ظرفیت خودش را دارد. پر بودن /var ربطی به آزاد بودن /home ندارد.
رزرو root روی ext* معمولاً درصدی را برای کاربر root نگه میدارد؛ ممکن است کاربر عادی «پر» ببیند در حالی که root هنوز کمی جا دارد. این رفتار عمدی است تا سیستم در بحران قابل بازیابی بماند.
خواندن df درست
bash
df -hT df -i df -h /var /tmp /home
`df` مصرف را از دید فایلسیستم گزارش میکند، نه از جمع فایلهای قابلمشاهده. ستونهای مهم: Size، Used، Avail، Use%، Mounted on و با `-T` نوع فایلسیستم. وقتی Use% نزدیک ۱۰۰٪ است یا Avail نزدیک صفر، نوشتن شکست میخورد — حتی اگر Use% ظاهراً ۹۵٪ باشد و رزرو root فعال باشد.
برای inode، ستون IUse% را ببینید. اگر IUse% بالاست و Use% پایین، بهجای پاک کردن یک فایل غولپیکر باید تعداد فایلهای ریز را کم کنید (کشها، sessionها، thumbnailها، maildirهای قدیمی).
du: کجا حجم رفته؟
`du` حجم ظاهری درخت دایرکتوری را جمع میزند. روی سرور تولید، از ریشهٔ همان mount پر شروع کنید نه لزوماً از `/`.
bash
sudo du -xh --max-depth=1 /var 2>/dev/null | sort -h sudo du -xh --max-depth=1 / 2>/dev/null | sort -h | tail
- `-x` از عبور به فایلسیستم دیگر جلوگیری میکند — حیاتی وقتی / و /var جدا نیستند یا bind mount دارید.
- `-h` خوانایی انسانی؛ برای مرتبسازی پایدار گاهی `du -k` و `sort -n` بهتر است.
- مجوز: بدون sudo بسیاری از دایرکتوریهای سیستمی Permission denied میدهند و مجموع گمراهکننده میشود.
ابزارهای تعاملی مثل `ncdu` یا `dust` سرعت اکتشاف را بالا میبرند؛ اصل همان است: از سنگینترین شاخه به پایین بروید تا به فایل یا پوشهٔ مقصر برسید.
مسیر عیبیابی عملی
- df -hT و df -i را ذخیره کنید؛ mount پر و نوع محدودیت (block/inode) را بنویسید.
- روی همان مسیر mount، du سطحاول را اجرا کنید.
- نامزدهای رایج را جدا چک کنید: /var/log، /var/lib/docker، /var/cache/apt، /tmp، home کاربران، بکاپهای /var/backups.
- فایلهای بزرگ را با find محدود به همان فایلسیستم پیدا کنید.
- اگر هنوز تناقض دارید، فایلهای حذفشدهٔ باز را بررسی کنید.
bash
sudo find /var -xdev -type f -size +200M -printf '%s %p ' 2>/dev/null | sort -n | tail sudo lsof +L1 2>/dev/null | head
تناقض کلاسیک: df پر، du کم
وقتی فایلی را پاک میکنید ولی پروسس هنوز آن را باز دارد، فضای دیسک آزاد نمیشود تا پروسس ببندد یا restart شود. `df` کمبود را نشان میدهد؛ `du` دیگر آن فایل را در درخت نمیبیند. `lsof +L1` یا بررسی FDهای `/proc/<pid>/fd` این حالت را آشکار میکند. راهحل معمول: چرخش لاگ صحیح، یا restart کنترلشدهٔ سرویسی که فایل را باز نگه داشته، نه حذف کور دوباره.
bash
# نمونهٔ مفهومی: پیدا کردن فایل حذفشدهٔ باز sudo lsof 2>/dev/null | grep '(deleted)' | head
لاگها، journal و چرخش
پر شدن دیسک اغلب از لاگ است. journald فضای خودش را دارد؛ با `journalctl --disk-usage` ببینید و در صورت نیاز با vacuum کنترل کنید — اما سقف را در پیکربندی پایدار تنظیم کنید تا مجبور به پاکسازی اضطراری نشوید. برای فایلهای `/var/log`، logrotate باید فعال و درست باشد؛ truncate دستی بدون فهم سرویس میتواند فایل را خالی کند ولی پروسس همچنان به inode قدیمی بنویسد.
bash
journalctl --disk-usage sudo journalctl --vacuum-size=300M sudo du -sh /var/log/* 2>/dev/null | sort -h | tail
جدول علائم و اقدام
| علامت | احتمال | اقدام اول |
|---|---|---|
| df Use% ≈ ۱۰۰، du هم سنگین | مصرف واقعی فایلها | du و پاکسازی هدفمند |
| df Use% بالا، IUse% بالا | فایلهای زیاد کوچک | پاک کردن کش/session و شمارش |
| df پر، du کم | فایل deleted باز | lsof / restart سرویس |
| فقط /tmp پر | فایل موقت یا اپ بدرفتار | پاکسازی /tmp با احتیاط |
| Docker زیاد | image/volume/log کانتینر | prune حسابشده، نه کور |
پاکسازی امن در مقابل خطرناک
امنتر: پاک کردن کش apt (`apt clean`)، آرشیو لاگهای چرخششدهٔ قدیمی، artifactهای CI که خودتان ساختهاید، ایمیجهای Docker بلااستفاده با تأیید. خطرناک: حذف کور `/var/lib`، پاک کردن فایل دیتابیس، یا `rm -rf` روی چیزی که فقط «اسمش شبیه کش است». همیشه مسیر را دو بار بخوانید و روی staging تمرین کنید.
bash
sudo apt-get clean df -h /
اشتباههای رایج
- فقط به Use% نگاه کردن و Avail و inode را نادیده گرفتن.
- اجرای du از / بدون -x و قاطی شدن با NFS یا mountهای دیگر.
- پاک کردن لاگ فعال بهجای اصلاح logrotate.
- افزایش دیسک ابری بدون گسترش فایلسیستم/LVM — حجم بزرگ میشود ولی df عوض نمیشود.
- نادیده گرفتن اینکه مانیتورینگ روی یک mount است و حادثه روی mount دیگر رخ میدهد.
چه زمانی ظرفیت را افزایش دهید؟
اگر پس از پاکسازی معقول، رشد پایدار دارید (دادهٔ کسبوکار، مدیا، ایندکس جستجو)، افزایش volume + resize فایلسیستم درست است. اگر رشد از باگ لاگ یا نشت موقت است، اول علت را ببندید؛ وگرنه دیسک بزرگتر فقط زمان تا حادثهٔ بعدی را زیاد میکند.
سناریوی واقعی: ریشه پر از لاگ اپ
فرض کنید اپ Node یا Python بدون چرخش، روزانه صدها مگابایت در `/var/log/app` مینویسد. `df -h /` به ۹۸٪ میرسد، استقرار جدید شکست میخورد، و تیم اول سراغ افزایش دیسک ابر میرود. مسیر درست: تأیید mount، `du` روی `/var/log`، دیدن فایل فعال با `lsof`، اصلاح تنظیمات لاگر یا logrotate، و فقط در صورت رشد دادهٔ واقعی resize. افزایش حجم بدون بستن علت، صورتحساب را بالا میبرد و هفتهٔ بعد همان آلارم را برمیگرداند.
اگر اپ داخل Docker است، لاگ درایور JSON ممکن است لایههای حجیم در `/var/lib/docker/containers` بسازد. سقف `max-size` و `max-file` را در daemon یا compose بگذارید؛ `docker system df` را در مانیتورینگ بگنجانید تا غافلگیر نشوید.
LVM، رشد دیسک ابر و فراموشی resize
در بسیاری از VPSها بعد از افزایش volume در پنل ابر، هنوز باید پارتیشن و فایلسیستم را گسترش دهید (growpart، lvextend، resize2fs یا xfs_growfs بسته به چیدمان). اگر فقط از پنل بزرگ کنید و df عوض نشود، مشکل «دیسک» نیست — مشکل تکمیلنشدن زنجیرهٔ ذخیرهسازی است. قبل از تولید، Runbook یکصفحهای برای رشد دیسک همان تصویر ابریتان بنویسید و یکبار روی staging تمرین کنید.
bash
# مفهومی — فرمان دقیق به تصویر/فایلسیستم بستگی دارد lsblk df -hT / # سپس ابزار رشد پارتیشن/LV و فایلسیستم مطابق مستند ابر
مانیتورینگ و آستانه
هشدار فقط روی Use%>۹۰ روی ریشه کافی نیست. Avail کمتر از چند گیگ برای دیتابیس خطرناکتر از ۹۲٪ روی دیسک ۲۰ ترابایتی است. برای inode هم آستانه جدا بگذارید. هشدار را به مسیر playbook وصل کنید: چه کسی du میکند، چه چیزهایی را هرگز rm نمیکند، و چه زمانی تیکت به تیم اپ میرود نه فقط زیرساخت.
تفکیک داده، لاگ و سیستمعامل
یکی از درسهای پایدار عملیات این است که ریشهٔ سیستمعامل، دادهٔ اپلیکیشن و لاگها اگر ممکن است مسیر رشد جدا داشته باشند. روی ابر این میتواند چند volume باشد؛ روی یک دیسک، حداقل با دایرکتوریهای با سهمیه یا هشدار جدا. وقتی همه چیز روی یک فایلسیستم ۲۰ گیگابایتی است، یک خطای لاگنویسی استقرار و دیتابیس را با هم میخواباند. طراحی جداسازی هزینهٔ کمی در روز اول و صرفهجویی بزرگی در حادثه دارد.
برای دیتابیسها، فضای WAL/journal و بکاپ موقت را در ظرفیتسنجی بگنجانید. بسیاری از پر شدنهای «ناگهانی» در واقع اسپایک بکاپ یا نگهداری ایندکس است که در تقویم عملیات دیده نشده است. تقویم را کنار مانیتورینگ دیسک بگذارید تا آلارم معنی بدهد.
اگر از snapshot ابری استفاده میکنید، به یاد داشته باشید snapshot جای پاکسازی و جای بکاپ منطقی اپ را کاملاً نمیگیرد؛ ولی برای برگشت سریع از اشتباه انسانی روی دیسک سیستم مفید است. سیاست نگهداشت snapshot را طوری نگذارید که خودش موجودی را پر یا صورتحساب را بیصدا منفجر کند.
در تیمهای کوچک، یک Runbook نیمصفحهای با سه فرمان اول (df -hT، df -i، du -xh --max-depth=1 روی mount پر) ارزش بیشتری از داشبورد زیبا بدون اقدام دارد. هر عضو on-call باید بدون پرسوجو همان سه فرمان را اجرا کند و خروجی را به تیکت بچسباند.
خلاصه
عیبیابی فضای دیسک سه سؤال دارد: کدام mount؟ بلوک یا inode؟ فایل روی دیسک است یا فقط FD باز؟ df و du و lsof با هم جواب میدهند. پاکسازی هدفمند، چرخش لاگ، و هشدار روی Avail و IUse% جلوتر از بحران کار میکنند.
سوالات متداول
چرا بعد از حذف فایل هنوز df پر است؟
احتمالاً پروسسی فایل را باز نگه داشته، یا روی mount دیگری پاک کردهاید، یا کش فایلسیستم/ابزار نمایش تأخیر کوتاه دارد. lsof و مسیر mount را چک کنید.
ncdu لازم است؟
خیر؛ du و sort کافیاند. ncdu فقط اکتشاف تعاملی را سریعتر میکند.
آیا پر بودن ۸۰٪ خطرناک است؟
بستگی به نرخ رشد و نوع بار دارد. برای دیسکهای کوچک VPS و دیتابیسهای نوشتنی، آستانهٔ هشدار را زودتر بگذارید و به Avail مطلق هم نگاه کنید نه فقط درصد.
منابع و مراجع
- df(1) — report file system disk space usage: https://man7.org/linux/man-pages/man1/df.1.html
- du(1) — estimate file space usage: https://man7.org/linux/man-pages/man1/du.1.html
- find(1): https://man7.org/linux/man-pages/man1/find.1.html
- lsof(8) documentation (file descriptors / deleted files)
- systemd-journald vacuum options — journalctl(1): https://www.freedesktop.org/software/systemd/man/latest/journalctl.html
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.




