تست نرمافزار با هوش مصنوعی؛ از تولید Test تا پیدا کردن Bug
چگونه از AI برای تولید تست، گسترش پوشش و یافتن باگ در لایههای Unit/Integration/E2E استفاده کنیم؛ محدودیتها و ارجاع OWASP/NIST/Copilot/Cursor.
بنیانگذار و مهندس محصول
تولید کد با AI بدون تست معادل شتابدادن به بدهی است. برعکسش هم افراط دارد: انبوه تستی که فقط پیادهسازی فعلی مدل را قفل میکند و باگ را در آغوش میگیرد. سؤال مفید این است که در هر لایه—Unit، Integration، E2E—AI کجا پیشنویس میسازد، کجا باگ را پیدا میکند، و کجا باید انسان معیار درستی را نگه دارد.
محصولها صریحاً تست را جزو کار Agent میدانند: Cursor Agent ترمینال و مرورگر دارد؛ GitHub Copilot cloud agent میتواند پوشش تست را بهبود دهد و حتی custom agent مخصوص testing بسازید. این مقاله لایه به لایه، با مرزهای امنیتی OWASP و نظارت NIST پیش میرود.
پاسخ کوتاه
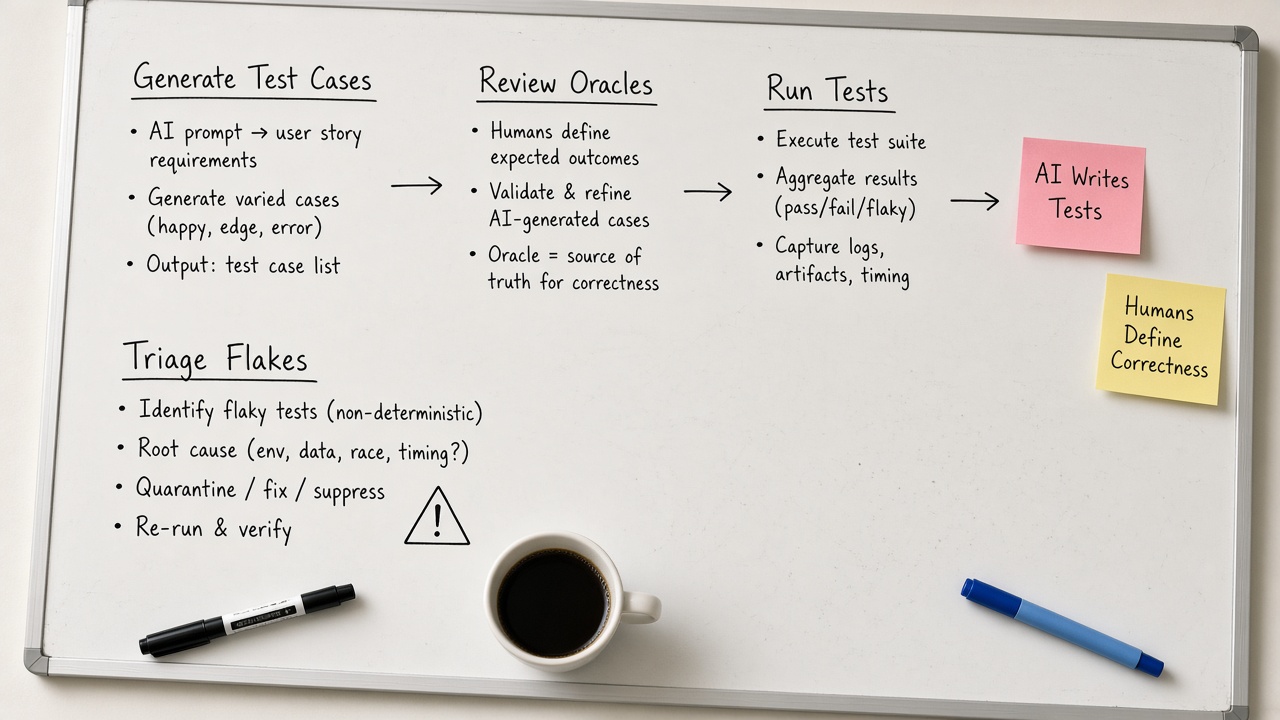
از AI برای پیشنهاد caseها، تولید اسکلت Unit، پر کردن تستهای مرزی، بازتولید باگ با شکست تست، و کمک به اسکریپتهای Integration/E2E استفاده کنید. همیشه تست را طوری بنویسید که رفتار مطلوب را قفل کند نه کد فعلی را. تست تولیدشده را Review کنید؛ آن را تنها دروازهٔ کیفیت ندانید. یافتن باگ با AI شروع خوبی است؛ تأیید با بازتولید قطعی و assertion روشن تمام میشود.
تست خوب باید بتواند پیادهسازی غلط را قرمز کند—حتی اگر همان مدل نوشته باشد.
چرا تست با AI متفاوت است؟
- مدل به کد تحت تست دسترسی دارد و ممکن است همان فرضهای غلط را در تست تکرار کند.
- پوشش خط بالا ≠ پوشش رفتار.
- E2E تولیدشده شکننده (flaky) و وابسته به زمانبندی UI است.
- اجرای خودکار تست توسط Agent بدون ایزوله، ریسک جانبی روی داده دارد.
LLM10 هشدار میدهد خروجی مدل را بدون اعتبارسنجی به سیستمهای پاییندستی نسپارید؛ تستی که بدون Review وارد CI میشود میتواند حس امنیت کاذب بسازد یا حتی در setup خود فرمان خطرناک اجرا کند.
جدول لایهها
| لایه | کمک قوی AI | ریسک اصلی | نقش انسان |
|---|---|---|---|
| Unit | اسکلت، مرزی، mock پیشنهاد | تست همسو با باگ | assertion و مثال طلایی |
| Integration | قرارداد API، تست DB با fixture | دادهٔ واقعی/مخرب | مرز تراکنش و پاکسازی |
| E2E | سناریوی کاربر، سلکتور اولیه | flaky، شکنندگی UI | مسیرهای حیاتی کسبوکار |
| بازتولید باگ | کاهش از گزارش/لاگ به تست | علت غلط مطمئن | تأیید ریشه قبل از Fix |
Unit: از تولید Test تا قفل رفتار
بهترین نقطهٔ شروع. پرامپت مؤثر: امضای تابع، پیششرط، پسشرط، مثالهای ورودی/خروجی، و صریحاً «تستهایی که با تغییر اشتباه قرمز میشوند». بخواهید جدول تصمیم یا propertyهای ساده پیشنهاد دهد.
- خوب: توابع خالص، پارسرها، محاسبهٔ مالیات با جدول مشخص.
- بد بدون مراقبت: تستی که فقط implementation detail (نام متد خصوصی) را قفل میکند.
- ضدالگو: کپی assertion از خروجی فعلی بدون oracle مستقل.
بعد از تولید، یک بار رفتار را عمداً بشکنید و ببینید تست قرمز میشود. اگر سبز ماند، تست شما داور نیست؛ تماشاگر است.
Integration: قراردادها و مرز سیستم
اینجا Agent میتواند کلاینت HTTP تست، قرارداد JSON schema، و سناریوی پایگاهداده با تراکنش برگشتپذیر پیشنهاد دهد. Copilot cloud agent در محیط Actions میتواند تستها را اجرا کند—مفید برای حلقهٔ observe. اما:
- به Production DB وصل نشود.
- Secret واقعی در fixture نیاید.
- تست موازی با قفل و دادهٔ ایزوله طراحی شود.
انسان باید مرزهای idempotency، ترتیب پیامها، و سازگاری نسخه را در assertionها ببیند—جایی که مدل اغلب خوشبین است.
E2E: سناریوی کاربر با احتیاط
Cursor امکان کنترل مرورگر برای تعامل و گرفتن وضعیت صفحه را در Agent دارد؛ برای تأیید بصری تغییرات UI مفید است. با این حال E2E کامل تولیدشده توسط مدل معمولاً شکننده است: سلکتور بد، انتظارهای زمانی، وابستگی به دادهٔ seed.
- فقط مسیرهای درآمدزا/ورود/پرداخت را E2E کنید.
- از AI بخواهید سناریو را به زبان Given/When/Then بنویسد؛ شما پایداری سلکتورها را تضمین کنید.
- E2E را جایگزین Unit نکنید؛ هرم تست را برعکس نکنید.
- flaky را فوراً قرنطینه کنید تا CI بیاعتماد نشود.
پیدا کردن Bug با AI
الگوی مؤثر:
- گزارش باگ، لاگ، یا تست قرمز را به Agent بدهید.
- بخواهید حداقل یک تست بازتولیدکنندهٔ شکست بنویسد قبل از Fix.
- Fix را روی همان تست سبز کند.
- یک تست رگرسیون منفی اضافه کند.
- انسان Diff و فرض ریشه را Review کند.
خطر: مدل علت را اشتباه حدس میزند و با «اصلاح» ظاهری تست را طوری عوض میکند که همیشه سبز شود. قانون: تغییر تست و تغییر کد محصول در یک PR بدون توضیح جداگانه ممنوع مگر برای اصلاح oracle غلط مستند.
پوشش تست و custom agent
GitHub اشاره میکند cloud agent میتواند پوشش را بهبود دهد و میتوانید agent تخصصی testing بسازید. متریک پوشش را هدف تبلیغاتی نکنید: دستور «پوشش را به ۸۰٪ برسان» بدون اولویت مسیرهای ریسکی، تستهای بیارزش تولید میکند. بهجای درصد، فهرست مسیرهای حیاتی و وضعیت قرمز/سبز آنها را معیار کنید.
گردشکار پیشنهادی در پروژه
- AC را به مثالهای تستپذیر برگردانید (انسان یا با کمک Assistant).
- Unit را همزمان با کد—ترجیحاً oracle اول.
- Agent برای پر کردن مرزها و اجرای محلی/ابری تست.
- Integration برای قراردادهای خارجی روی محیط تست.
- E2E دود روی مسیرهای حیاتی در pipeline.
- Review تست مثل Review کد (مقاله ۱۳۰).
- Merge فقط با دروازههای CI؛ نه با ادعای چت.
امنیت در تستهای AI-assisted
- Fixture بدون PII واقعی؛ دادهٔ مصنوعی.
- ممنوعیت اجرای فرمانهای مخرب در setup پیشنهادی مدل.
- جدا کردن credential تست از Production.
- اگر Agent مرورگر را باز میکند، به حسابهای واقعی و پرداخت واقعی ندهید.
Excessive Agency اینجا یعنی دادن shell باز برای «هرچه برای سبز شدن لازم است»—دقیقاً خلاف حداقل ابزار OWASP.
اشتباههای رایج
- تولید صدها Unit بدون یک Integration برای مسیر پول.
- اعتماد به «همه تستها سبز» وقتی Agent هم تست هم کد را در یک حلقه همراستا کرده.
- E2E برای هر دکمهٔ UI.
- حذف تستهای قرمز بهجای فهماندن علت.
- نبود مالک برای تستهای flaky تولیدشده.
نمونهٔ پرامپتهای کوتاه و مفید
- «برای تابع X جدول مثال ورودی/خروجی و سه تست مرزی بنویس؛ از mock شبکه استفاده نکن.»
- «از روی این stack trace یک تست واحد بازتولیدکننده بساز؛ کد محصول را هنوز عوض نکن.»
- «سناریو E2E ورود تا افزودن به سبد را Given/When/Then بنویس؛ سلکتورها را data-testid فرض کن.»
- «این PR چه مسیرهایی را بدون تست جدید گذاشته؟ فهرست کن.»
سوالات متداول
آیا AI میتواند جایگزین QA شود؟
خیر. QA مالک ریسک محصول، داده، و اکتشاف است. AI سرعت پیشنویس و بازتولید را بالا میبرد.
تست ملکولی (property-based) را پیشنهاد بدهیم؟
برای پارسرها و invariants مفید است اگر انسان invariant را درست تعریف کند. مدل alone اغلب invariant ضعیف مینویسد.
چطور بفهمیم تستهای AI مفیدند؟
Mutation آزمایشی: یک باگ عمدی بکارید. اگر هیچ تستی قرمز نشد، پوشش واقعی ندارید.
خلاصه
AI در تولید Unit، کمک Integration، پیشنویس E2E محدود، و بازتولید باگ تواناست—به شرط Review، oracle مستقل، و هرم تست سالم. آن را موتور درصد پوشش نکنید؛ ابزار رسیدن به اطمینان قابل دفاع روی رفتارهای مهم بدانید. خروجی تست هم مثل کد باید قبل از Production از دروازهٔ انسان و CI بگذرد.
استراتژی دادهٔ تست
از AI بخواهید برای هر موجودیت مهم، کارخانهٔ دادهٔ مصنوعی با مقادیر مرزی بسازد: تهی، بیشینه، یونیکد، و توالی تکراری. هرگز دادهٔ واقعی مشتری را برای «واقعگرایی» در مخزن نگذارید. اگر به anonymized نیاز دارید، فرایند جدا و تأیید امنیتی لازم است—نه یک پرامپت.
برای Integration، seed و teardown را صریح کنید تا Agent در حلقهٔ سبز کردن، دادهٔ باقیمانده نسازد که تست بعدی را flaky کند.
تست قرارداد و سازگاری
وقتی Agent API را عوض میکند، بخواهید consumer-driven contract یا حداقل تست سازگاری نسخه را بهروز کند. بسیاری از رگرسیونهای Production از همین نقطه میآیند. انسان باید نسخهٔ عمومی و سیاست deprecation را تأیید کند؛ مدل معمولاً فقط «الان کامپایل میشود» را میبیند.
اندازهگیری ارزش تستهای AI-assisted
- تعداد باگهای واقعی یافتشده قبل از Merge که بدون تست جدید جا میماندند.
- زمان بازتولید Incident با تست اضافهشده پس از حادثه.
- نرخ flaky در سی روز.
- نسبت تستهای حذف/بازنویسیشده بهخاطر بیارزشی.
اگر فقط تعداد تست بالا رفت و Incident کم نشد، استراتژی را عوض کنید نه مدل را.
همترازی با Review و Production
تست و Review دو دروازهٔ مکملاند (مقالههای ۱۲۹ و ۱۳۰). تست بدون Review میتواند oracle غلط را قفل کند؛ Review بدون تست نظر است. Deploy بدون هر دو، قمار است. در سیاست تیم بنویسید: مسیر قرمز نیاز به هر دو دارد.
پس از انتشار، مانیتورینگ و آلارم را بخشی از «تست در Production» کنترلشده ببینید—نه جایگزین تست پیش از Merge.
کارگاه نیمروزه برای تیم
- یک تابع خالص را با AI Unitنویسی و mutation آزمایشی کنید.
- یک باگ واقعی قبلی را فقط با لاگ به تست بازتولید تبدیل کنید.
- یک مسیر UI حیاتی را Given/When/Then کنید بدون سلکتور شکننده.
- یک PR تستمحور را با Rubric Review جمعی ببینید.
خروجی کارگاه: فهرست مسیرهای حیاتی و وضعیت پوشش واقعی—نه درصد خام.
فلکیها (Flaky) و نقش Agent
Agent گاهی برای سبز کردن CI، sleep بیشتر یا retry بیمهار به E2E اضافه میکند. این سبز شدن را میخرد و اعتماد را میفروشد. سیاست: flaky باید قرنطینه یا ریشهدار شود؛ افزایش کور timeout بدون Issue جدا ممنوع. از Agent بخواهید علت فلکی را دستهبندی کند (race، داده، شبکه، سلکتور) و برای هر دسته یک اصلاح ساختاری پیشنهاد دهد—نه فقط sleep.
تست امنیت سبک با کمک AI
میتوانید بخواهید فهرست موردهای منفی دسترسی را پیشنهاد دهد: کاربر بدون نقش، توکن منقضی، ID دیگری. اجرای آنها در Integration روی محیط تست مفید است. جایگزین penetration test کامل نیست. یافتهها را مثل هر پیشنهاد دیگر Review کنید و با ابزار SAST/DASA تکمیل کنید.
هرگز خروجی مدل را برای «اسکن امنیتی» روی Production با payload واقعی بدون مجوز و محدوده اجرا نکنید.
مستندسازی تست بهعنوان دارایی
تست خوب مستند زندهٔ رفتار است. از AI بخواهید برای ماژولهای حیاتی یک README تست بنویسد: چگونه اجرا شود، چه دادهای لازم است، کدام مسیرها عمداً پوشش داده نشدهاند. این شکافها را صادقانه نشان میدهد و از توهم پوشش جلوگیری میکند.
برنامهٔ سیروزهٔ پذیرش
- روز ۱–۷: فقط Unit با mutation آزمایشی روی یک سرویس.
- روز ۸–۱۴: Integration قرارداد برای یک API عمومی.
- روز ۱۵–۲۱: یک E2E دود پایدار؛ فلکی صفر.
- روز ۲۲–۳۰: اتصال به CI و Review اجباری تستهای جدید؛ گزارش متریک به تیم.
اگر در روز ۳۰ فقط تعداد فایل تست بالا رفته و هنوز مسیر پول بدون منفیتست است، هدف را از نو تنظیم کنید.
خط آخر برای QA و توسعه
AI نویسندهٔ کمکی تست است نه صاحب کیفیت. مالک کیفیت کسی است که میتواند بگوید کدام رفتار باید قرمز شود و چرا. وقتی این مالکیت روشن باشد، تولید تست با Agent شتاب بیخطر است؛ وقتی نباشد، فقط فایلهای سبزِ بیمعنا زیاد میشود.
منابع و مراجع
- Cursor Agent overview (tools: shell, browser) — https://cursor.com/docs/agent/overview
- Cursor Agent modes — https://cursor.com/help/ai-features/agent
- GitHub Copilot cloud agent (improve test coverage, custom agents) — https://docs.github.com/en/copilot/concepts/agents/cloud-agent/about-cloud-agent
- OWASP GenAI LLM Top 10 2026 — LLM10 Improper Output Handling / LLM03 Excessive Agency — https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
- NIST AI RMF — https://www.nist.gov/itl/ai-risk-management-framework
- NIST AI 600-1 — https://doi.org/10.6028/NIST.AI.600-1
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.