انواع دیتابیس چیست و هرکدام چه زمانی مناسب هستند؟
انواع پایگاه داده را با معیار تناسب و محدودیت مقایسه کنید — رابطهای، سند، کلید-مقدار، گراف و سریزمانی — بدون ادعای بهترین مطلق.
سا
11 دقیقه مطالعهسهیل ابراهیمپور
بنیانگذار و مهندس محصول
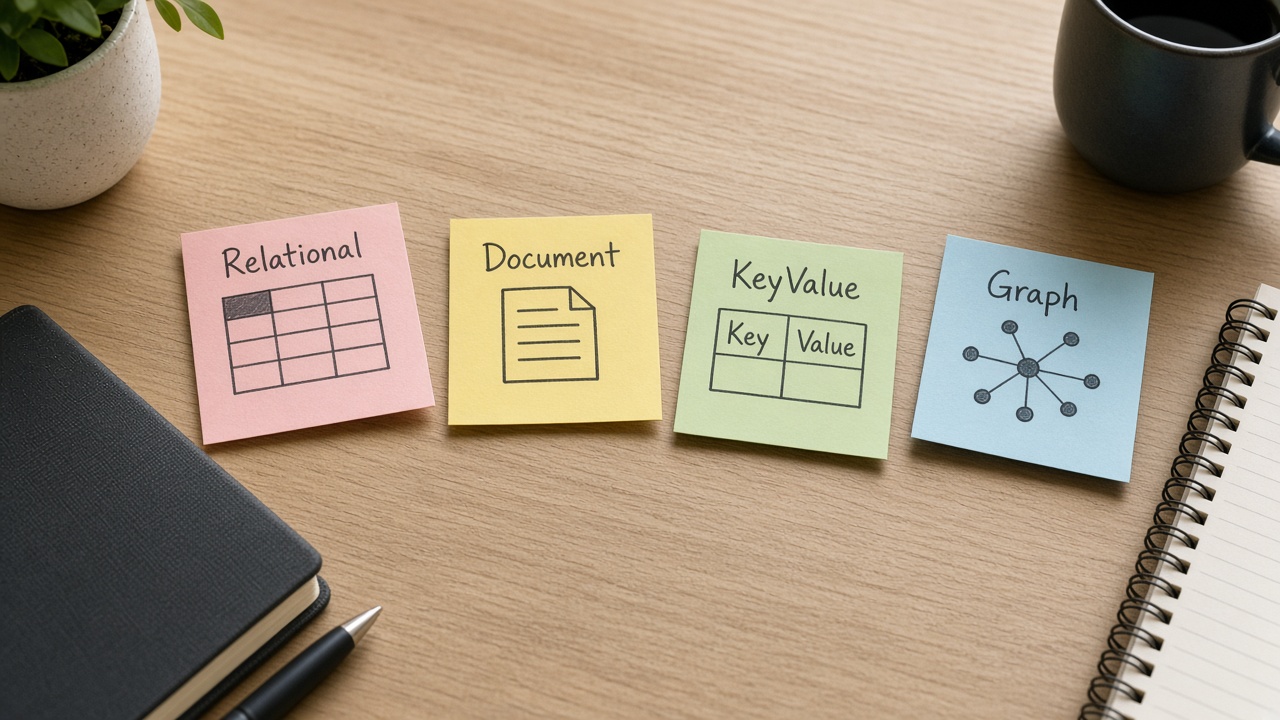
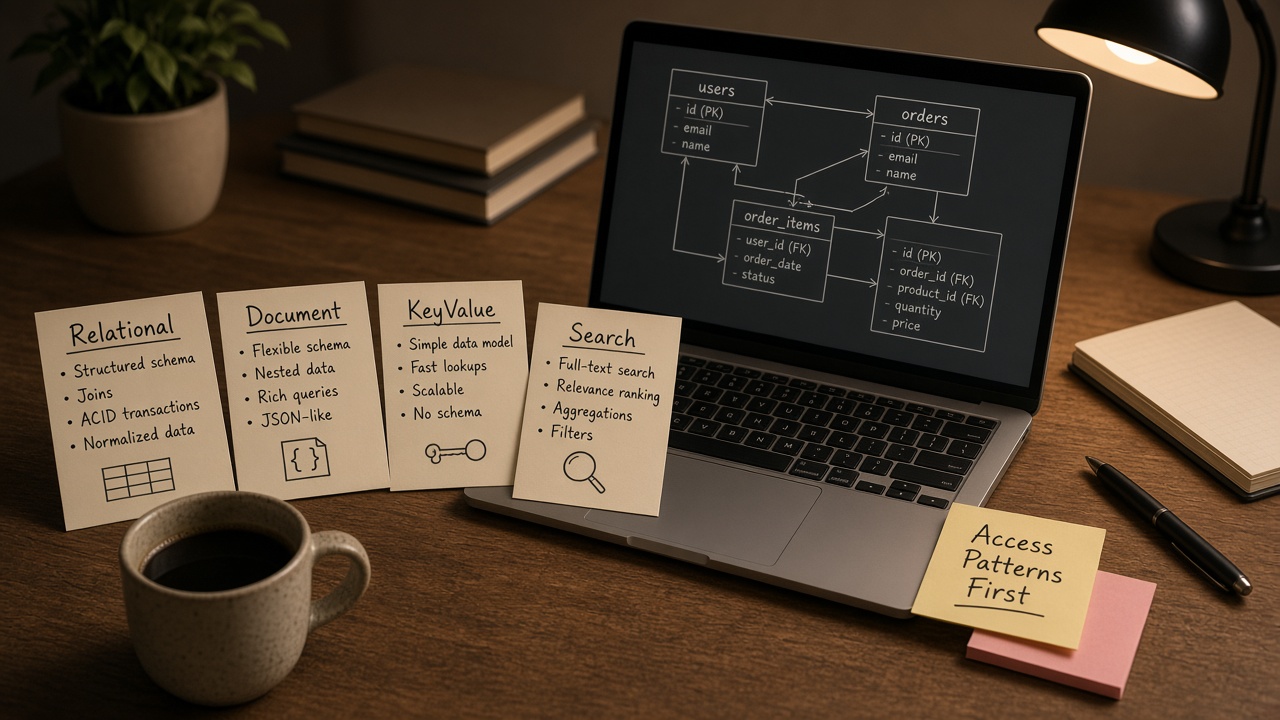
پرسش «کدام دیتابیس را بگیریم؟» معمولاً زودتر از پرسش مفیدتر مطرح میشود: دادهٔ ما چه شکلی دارد، چه پرسوجوهایی غالباند، و چه چیزی را حاضر نیستیم قربانی کنیم — یکپارچگی تراکنشی، انعطاف اسکیما، تأخیر کم، یا پیمایش رابطهٔ پیچیده؟ انواع پایگاه داده پاسخهای متفاوتی به این قیدها میدهند.
این راهنما خانوادهٔ رایج را پوشش میدهد: پایگاه رابطهای مبتنی بر SQL، چتر NoSQL، مدل سند (Document)، کلید-مقدار (Key-Value)، گراف (Graph) و سریزمانی (Time-Series). هدف معرفی «برندهٔ مطلق» نیست؛ ساختن جدول تناسب و محدودیت است تا بتوانید با معیار حرف بزنید.
تعاریف را به صفحات مفهومی رسمی وصل میکنیم: PostgreSQL برای جهان رابطهای/SQL، MongoDB برای سند، Redis برای ذخیرهٔ ساختاردادهٔ درونحافظه و کاربردهای نزدیک به کلید-مقدار، Neo4j برای گراف، و مستندات TimescaleDB/Tiger Data برای تحلیل سریزمانی روی PostgreSQL.
پاسخ کوتاه
نوع دیتابیس را از شکل داده و الگوی دسترسی انتخاب کنید، نه از مد روز:
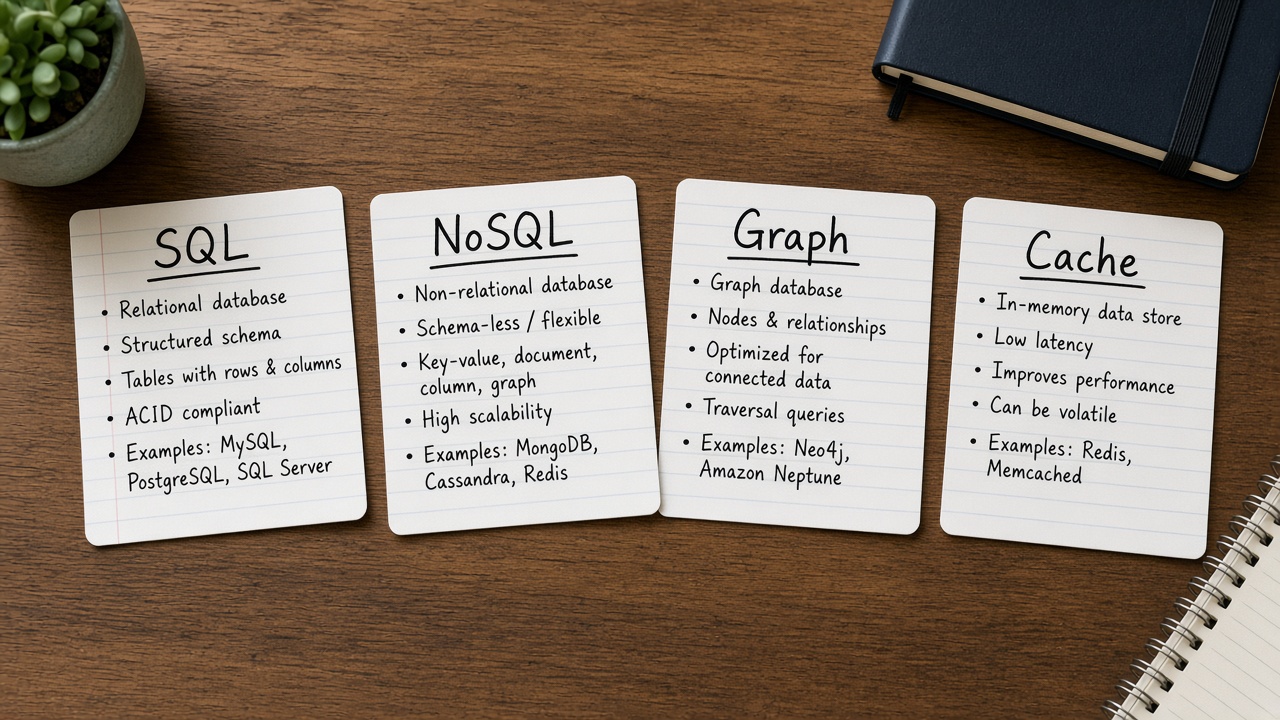
- رابطهای / SQL: دادهٔ جدولی با رابطه، گزارش، یکپارچگی و اکوسیستم بالغ.
- Document: اسناد JSONمانند با اسکیمای منعطف و خواندن تجمیعی سند.
- Key-Value / درونحافظه: جستوجوی خیلی سریع با کلید معلوم؛ اغلب کش یا نشست.
- Graph: وقتی «رابطه بین موجودیتها» خودِ مسئله است (پیشنهاد، تقلب، شبکه).
- Time-Series: حجم بالای نقاط زمانی (متریک، سنسور، رویداد) با تجمیع روی زمان.
هیچ نوعی همهکارهٔ بیقید نیست؛ ترکیب چند موتور در یک سامانهٔ واقعی عادی است — به شرطی که منبع حقیقت هر دامنه روشن باشد.
SQL و NoSQL: برچسبها را درست بخوانید
SQL در اصل نام یک زبان پرسوجو است، ولی در گفتوگوی روزمره «دیتابیس SQL» معمولاً یعنی موتور رابطهای که جدول، ردیف، ستون و JOIN دارد. PostgreSQL خود را ORDBMS میداند که بخش بزرگی از استاندارد SQL و قابلیتهایی مثل کلید خارجی و یکپارچگی تراکنشی را ارائه میدهد.
NoSQL برچسب چتری است برای مدلهایی که الزاماً جدول رابطهای کلاسیک نیستند — سند، کلید-مقدار، ستونی، گراف و غیره. «NoSQL» بهمعنی «بدون نظم» یا «بدون تراکنش» نیست؛ فقط میگوید مدل و API ممکن است با SQL جدولی یکی نباشد. بسیاری از محصولات NoSQL امروزه پرسوجوی غنی، ایندکس و حتی تراکنش محدود دارند.
اشتباه رایج: فرض اینکه NoSQL همیشه مقیاسپذیرتر و SQL همیشه امنتر است. مقیاس و ایمنی به طراحی، سختافزار، الگوی نوشتن و تیم عملیاتی بستگی دارد. معیار را از workload بگیرید.
پایگاه رابطهای (Relational / SQL)
داده در جدولها سازمان مییابد؛ رابطهها با کلید و قیود تعریف میشوند. MySQL در مستند رسمیاش توضیح میدهد مدل منطقی با database، table، view، row و column محیط برنامهنویسی انعطافپذیری میسازد و قواعد رابطه را enforce میکند تا برنامه دادهٔ ناسازگار نبیند.
تناسب معمول: سیستم سفارش، مالی، هویت کاربر، هر جایی که گزارش JOINدار و صحت بینجدولی مهم است. محدودیت رایج: مدلسازی دادهٔ بسیار تو در تو یا گراف عمیق با JOINهای زیاد میتواند پیچیده یا کند شود؛ اسکیمای سختگیرانه برای تیمهایی که دادهٔ ناهمگون سریعتغییر دارند اصطکاک ایجاد میکند — هرچند JSON داخل PostgreSQL این مرز را نرمتر کرده است.
Document (سند)
MongoDB در Introduction رسمی میگوید هر رکورد یک document است؛ ساختاری از جفت فیلد-مقدار شبیه اشیاء JSON. مقادیر میتوانند سند تو در تو، آرایه و آرایهٔ سند باشند. مزایایی که همان صفحه میشمارد: تطبیق با نوعدادههای زبانهای برنامهنویسی، کاهش نیاز به JOINهای گران با embedding، و اسکیمای پویا برای polymorphism.
سندها در collection ذخیره میشوند — آنالوگ جدول در جهان رابطهای. تناسب معمول: پروفایل محصول با ویژگیهای متغیر، محتوا، رویدادهایی که بیشتر بهصورت یک سند کامل خوانده میشوند. محدودیت: اگر دادهٔ نرمالشده و تراکنش چندسند پیچیده غالب شود، یا گزارشهای رابطهای سنگین نیاز دارید، یا باید مدل را با دقت طراحی کنید یا موتور رابطهای را جدیتر ببینید.
Key-Value و ذخیرهٔ درونحافظه
در سادهترین شکل، هر کلید به یک مقدار نگاشت میشود: ایدهآل وقتی همیشه میدانید کلید چیست (session:abc، user:42:cart). Redis در مستندات Get Started خود را یک in-memory data store معرفی میکند که میلیونها توسعهدهنده آن را بهعنوان cache، vector database، document database، streaming engine و message broker به کار میبرند؛ replication داخلی و سطوح مختلف persistence روی دیسک دارد و ساختاردادههای پیچیدهتر از رشتهٔ ساده (hash، list، set، sorted set، JSON و …) را با عملیات اتمی پشتیبانی میکند.
تناسب معمول: کش نتیجهٔ پرسوجو، شمارنده، قفل توزیعشدهٔ سبک، صف ساده، نشست. محدودیت: اگر همهٔ حقیقت کسبوکار را فقط در حافظه بگذارید، باید صریحاً دربارهٔ ازدسترفتن داده، هزینهٔ RAM و مدل پایداری تصمیم بگیرید. Redis جایگزین گزارش مالی پیچیده نیست؛ مکمل سرعت است.
Graph (گراف)
مستند Neo4j با عنوان What is a graph database توضیح میدهد داده بهصورت node، relationship و property ذخیره میشود — شبیه کشیدن ایده روی وایتبورد — نه جدول یا سند صرف. Nodeها برچسب و ویژگی میگیرند؛ Relationship بین دو node جهتدار است، نوع دارد و میتواند property داشته باشد.
همان صفحه تأکید میکند گراف برای JOINهای گران رابطهای در پیمایش عمیق طراحی نشده؛ رابطهها بهصورت بومی کنار داده ذخیره میشوند تا پیمایش میلیونها اتصال در ثانیه ممکن شود. تناسب: شبکهٔ اجتماعی، توصیه، تشخیص تقلب، مدیریت دسترسی تو در تو، نقشهٔ وابستگی سرویسها. محدودیت: برای گزارشهای جدولی ساده یا بار OLTP صرفاً جدولی، پیچیدگی اضافه میآورد؛ تیم باید مدل گراف و زبان پرسوجو (مثل Cypher) را یاد بگیرد.
Time-Series (سریزمانی)
دادهٔ سریزمانی دنبالهای از نقاط است که با زمان ایندکس شدهاند: متریک سرور، سنسور صنعتی، قیمت سهام، ضربان قلب. InfluxDB در Get Started مثالهایی از این دست میآورد و مدل خود را حول bucket، measurement، tag، field و timestamp توضیح میدهد.
مسیر دیگر: ماندن روی PostgreSQL با افزونهٔ بهینهشده برای زمان. مستند معماری Tiger Data / TimescaleDB میگوید TimescaleDB افزونهٔ متنباز PostgreSQL برای تحلیل بلادرنگ روی دادهٔ سریزمانی است؛ hypertables داده را خودکار پارتیشن میکنند، ذخیرهٔ هیبرید ردیفی-ستونی ingest و آنالیتیکس را جمع میکند، و SQL کامل حفظ میشود.
تناسب: مانیتورینگ، IoT، داشبورد متریک، رویدادهای پرتراکم زمانی. محدودیت: اگر مسئلهٔ اصلی رابطهٔ غنی بین موجودیتهای کسبوکار است نه محور زمان، سریزمانی خالص ممکن است مدل را پیچاند. برعکس، ریختن میلیاردها نقطهٔ متریک در جدول رابطهای بدون پارتیشنبندی زمانی معمولاً دردسر نگهداری و هزینه میآورد.
جدول مقایسه: نوع / تناسب معمول / محدودیت
| نوع | تناسب معمول | محدودیت رایج |
|---|---|---|
| رابطهای / SQL | سفارش، مالی، هویت، گزارش JOINدار، قیود قوی | گراف عمیق یا سند بسیار متغیر ممکن است اصطکاک داشته باشد |
| Document | پروفایل/محتوای JSONمانند، خواندن سند کامل، اسکیمای در حال تغییر | تراکنش و گزارش بینمجموعهای پیچیده سختتر میشود |
| Key-Value / درونحافظه | کش، نشست، شمارنده، دسترسی با کلید معلوم | منبع حقیقت مالی بلندمدت یا پرسوجوی غنی بدون طراحی اضافه |
| Graph | پیشنهاد، تقلب، شبکه، پیمایش رابطه | سربار مدل/یادگیری؛ گزارش جدولی ساده گاهی سادهتر در SQL است |
| Time-Series | متریک، سنسور، رویداد زمانی پرتراکم | مدل رابطهٔ کسبوکار غنی؛ نیاز به ابزار/افزونهٔ تخصصی |
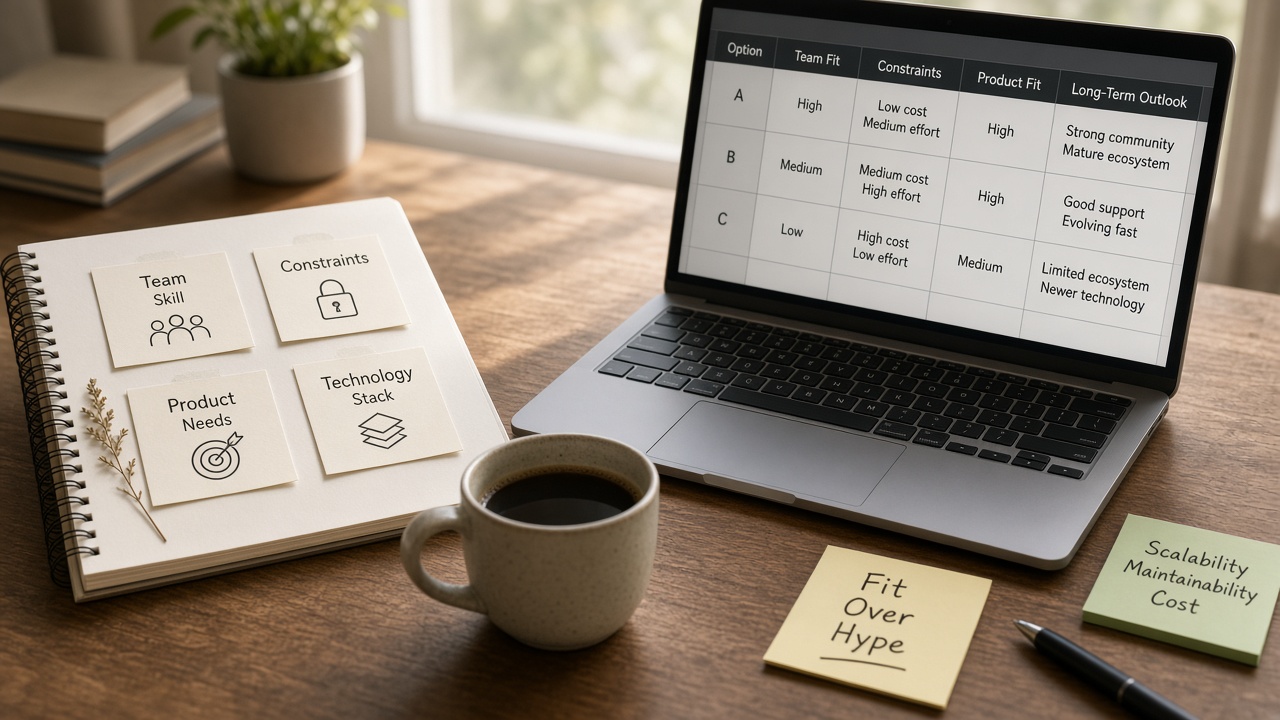
معیارهای تصمیم — بدون کلمهٔ «بهترین»
قبل از انتخاب برند، این سؤالها را روی کاغذ بیاورید:
- واحد خواندن غالب چیست: ردیف JOINشده، یک سند کامل، یک کلید، یک مسیر گراف، یا پنجرهٔ زمانی؟
- چقدر نوشتن همزمان و چقدر نیاز به تراکنش چندردیفی دارید؟
- اسکیما ثابتتر است یا هفتهبههفته فیلد جدید میآید؟
- تیم با SQL راحتتر است یا با API سند/گراف؟
- آیا یک موتور کافی است یا الگوی CQRS/کش جدا منطقی است؟
- پشتیبانگیری، مشاهدهپذیری و نیروی عملیاتی برای این موتور وجود دارد؟
مثال فروشگاه: Users/Products/Orders/Payments غالباً روی رابطهای مینشیند. جلسهٔ کاربر و کش صفحهٔ محصول میتواند Key-Value باشد. گراف توصیهٔ «کاربرانی که این را خریدند» جداست. متریک تأخیر API سریزمانی است. چند نوع در یک محصول، اگر مرز مسئولیت روشن باشد، نشانهٔ بلوغ است نه تناقض.
اشتباههای رایج در دستهبندی
- انتخاب Document فقط چون «مدرن است» در حالی که گزارش مالی JOINدار روزانه دارید.
- گذاشتن همه چیز در Redis چون benchmark روی localhost درخشان بود.
- ساختن گراف برای دادهٔ عملاً جدولی یکبهچند ساده.
- نادیده گرفتن سریزمانی تا وقتی جدول متریک میلیارد ردیفی قفل شود.
- فرض اینکه یک دسته NoSQL همهٔ زیرنوعها را یکی میکند.
دسته را بهعنوان فرضیهٔ اولیه ببینید؛ با یک نمونهٔ واقعی از پرسوجوهای پربسامد و یک آزمایش بار کوچک فرضیه را باطل یا تأیید کنید.
چطور از این مقاله به انتخاب موتور برسید؟
اینجا نوع را شناختید. قدم بعد نام محصول است: PostgreSQL در برابر MySQL، MongoDB در برابر سند روی PostgreSQL، Redis در برابر کش داخلی فریمورک، Neo4j در برابر گسترش گراف روی SQL، Timescale در برابر Influx. مقالهٔ «چگونه دیتابیس انتخاب کنیم» همان لایه را با قیود پروژه جمع میکند.
اگر هنوز مفهوم persistence و منبع حقیقت روشن نیست، اول ۰۳۳ را بخوانید؛ اگر میخواهید زبان واسط جهان رابطهای را بفهمید، ۰۳۵.
چند موتور در یک محصول — الگوی رایج
سامانههای واقعی غالباً یک «دیتابیس همهکاره» ندارند. الگوی متداول فروشگاه آنلاین میتواند چنین باشد: PostgreSQL یا MySQL برای سفارش و پرداخت؛ Redis برای نشست و کش؛ یک انبار یا جدول سریزمانی برای متریک تأخیر؛ و گاهی سرویس جستوجو جدا برای کاتالوگ. این ترکیب وقتی سالم است که هر موتور دامنهٔ حقیقت مشخصی داشته باشد و همگامسازی بین آنها طراحی شده باشد — نه کپی بیبرنامه.
خطر ترکیبزدگی وقتی است که تیم هر مشکل عملکردی را با اضافه کردن تکنولوژی جدید «حل» میکند بدون اینکه منبع حقیقت قبلی را خلوت کند. قبل از افزودن گراف یا سریزمانی، بپرسید آیا ایندکس، پارتیشن، یا کش کنار همان موتور رابطهای کافی نیست.
اسکیما ثابت در برابر اسکیمای در حال تغییر
اگر فیلدهای محصول هفتهبههفته عوض میشوند و تیم فرانت میخواهد ویژگیهای دلخواه را بدون migration سنگین بفرستد، مدل Document جذاب به نظر میرسد — همان مزیت dynamic schema که MongoDB در Introduction برجسته میکند. اگر برعکس، گزارش مالی و قیود سخت دارید، اسکیمای رابطهای با migration نسخهبندیشده معمولاً هزینهٔ بلندمدت کمتری دارد.
راه میانه هم وجود دارد: ستون JSON داخل موتور رابطهای برای بخشهای متغیر، و ستونهای معمولی برای چیزهایی که JOIN و قیود لازم دارند. این یعنی لازم نیست برای کمی انعطاف، کل مدل را Document کنید؛ و لازم نیست برای کمی گزارش، Document را به زور به JOINهای دردناک بکشانید.
عملکرد، مقیاس و هزینه را از نوع جدا کنید
نوع داده دربارهٔ شکل مدل حرف میزند؛ مقیاس دربارهٔ حجم، نرخ نوشتن، و الگوی جغرافیایی. میتوانید یک PostgreSQL را با پارتیشن و سختافزار مناسب خیلی جلو ببرید، یا یک MongoDB را با مدل بد زود به دیوار بزنید. Redis سریع است چون عمدتاً در حافظه کار میکند — هزینهٔ RAM و سیاست persistence را باید در همان تصمیم ببینید، نه بعد از حادثه.
TimescaleDB/Tiger نشان میدهد حتی روی خانوادهٔ SQL هم میتوان با hypertable و ذخیرهٔ هیبرید برای سریزمانی بهینه شد؛ یعنی «SQL بودن» مانع بهینهسازی تخصصی نیست. برچسب نوع را با بنچمارک workload خودتان پر کنید.
از نظر تیم و هزینهٔ عملیاتی: هر موتور جدید یعنی پشتیبانگیری، مانیتورینگ، ارتقا و نیروی آشنای جدا. گاهی انتخاب نوع «دومبهینه» از نظر مدل، بهخاطر مهارت تیم و ابزار موجود، در مجموع درستتر است.
چکلیست یکصفحهای قبل از خرید/نصب
- سه پرسوجوی پربسامد را با دادهٔ نمونه نوشتهاید؟
- نیاز تراکنش چندردیفی را مشخص کردهاید؟
- حجم رشد یکساله را حدس زدهاید (حتی تقریبی)؟
- مهارت تیم روی SQL، سند، گراف یا سریزمانی چقدر است؟
- نقشهٔ منبع حقیقت و کش را یک پاراگراف نوشتهاید؟
- خروجی (exit) را فکر کردهاید: اگر موتور را عوض کنیم داده چطور بیرون میآید؟
اگر نتوانستید سه پرسوجوی پربسامد را بنویسید، هنوز برای انتخاب نوع زود است؛ اول دامنه را بشناسید.
جمعبندی
انواع دیتابیس پاسخهای متفاوتی به شکل داده و الگوی دسترسیاند. SQL/رابطهای برای ساختار و یکپارچگی جدولی، Document برای سند منعطف، Key-Value برای سرعت کلیدمحور، Graph برای خودِ رابطه، Time-Series برای محور زمان. جدول تناسب/محدودیت را ملاک گفتوگو بگذارید؛ برچسب «بهترین» بدون معیار، تصمیم را مبهم میکند.
در عمل، سامانهٔ سالم اغلب چند ابزار دارد و یک منبع حقیقت برای هر دامنهٔ حیاتی.
منابع و مراجع
- PostgreSQL Documentation — What Is PostgreSQL?: https://www.postgresql.org/docs/current/intro-whatis.html
- MongoDB Manual — Introduction to MongoDB: https://www.mongodb.com/docs/manual/introduction/
- Redis Documentation — Get started (Open Source): https://redis.io/docs/latest/get-started/
- Neo4j Docs — What is a graph database: https://neo4j.com/docs/getting-started/graph-database/
- Tiger Data Docs — Architecture for real-time analytics (TimescaleDB): https://docs.tigerdata.com/about/latest/whitepaper
- InfluxDB Docs — Get started with InfluxDB (مفهوم سریزمانی): https://docs.influxdata.com/influxdb/v2/get-started/
برای تعریف پایهٔ پایگاه داده به ۰۳۳ و برای زبان SQL به ۰۳۵ سر بزنید؛ انتخاب موتور مشخص را در ۱۱۸ دنبال کنید.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.