

sed و awk: ویرایش جریان و پردازش متن ستونی در لینوکس
تفاوت sed و awk، جایگزینی امن، فیلدها، گزارشگیری از لاگ و اشتباههای رایج ویرایش جریان در لینوکس.
بنیانگذار و مهندس محصول
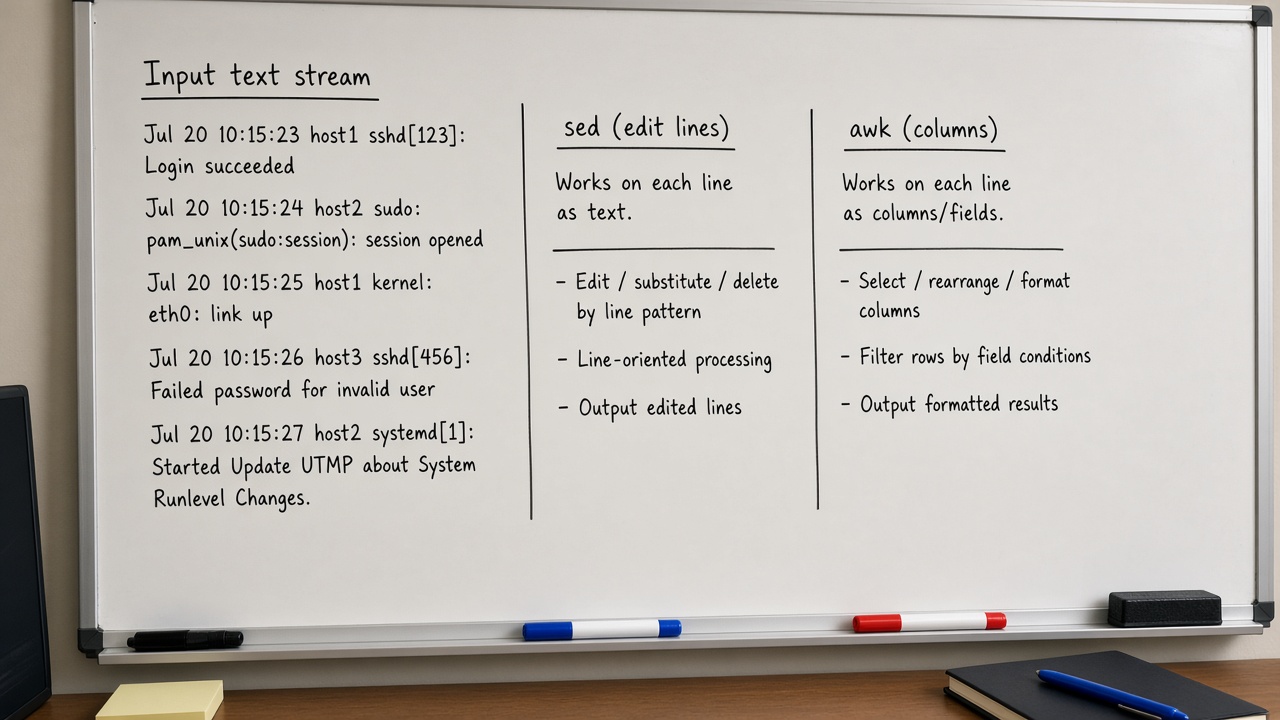
وقتی باید در هزاران خط یک جایگزینی کوچک انجام دهید یا از لاگ فقط ستون سوم و کد وضعیت را بیرون بکشید، باز کردن فایل در ادیتور مقیاسپذیر نیست. sed ویرایشگر جریان است: خط را میخواند، دستوری اعمال میکند، مینویسد. awk بیشتر شبیه زبان کوچک پردازش رکورد/فیلد است: الگو و عمل، با متغیر و جمع و گزارش.
هر دو از دههٔ یونیکس آمدهاند و هنوز در یکخطیهای عملیات، CI و بازسازی فایل پیکربندی ظاهر میشوند. جایگزینهای مدرن (Python، jq) گاهی خواناترند؛ ولی sed/awk روی سرور مینیمال بدون وابستگی اضافه کار میکنند.
پاسخ کوتاه
برای جایگزینی یا حذف ساده روی جریان/فایل: sed. برای کار با ستونها، جمع، و شرط روی فیلدها: awk. قبل از sed -i روی فایل مهم، بکاپ یا dry-run بدون -i بگیرید. برای CSV پیچیده با نقلقول تودرتو، ابزار تخصصیتر از awk یکخطی امنتر است. زنجیرهٔ رایج: `grep` برای فیلتر خطوط → `awk` برای فیلد → گاهی `sed` برای تمیزکاری.
sed چاقوی برش خط است؛ awk ماشین حساب فیلدها — هر دو بدون تست روی کپی، اسلحهٔ خودزنیاند.
sed: جایگزینی پایه
bash
echo 'colour color' | sed 's/colour/color/' echo 'a_b_c' | sed 's/_/-/g' sed -n '1,5p' /etc/hosts sed '/^#/d' config.ini | head
s/الگو/جایگزین/ یک بار در خط؛ با g همهٔ رخدادهای خط. -n جلوی چاپ پیشفرض را میگیرد تا فقط pهای صریح دیده شوند. حذف خطوط توضیح با '/^#/d' نمونهٔ کلاسیک است.
sed روی فایل: احتیاط -i
bash
cp important.conf important.conf.bak sed -i 's/Listen 80/Listen 8080/' important.conf # GNU sed بکاپ کنار: sed -i.bak 's/Listen 80/Listen 8080/' important.conf
بدون بکاپ، یک الگو اشتباه فایل را خراب میکند. در اسکریپت قابلحمل، رفتار -i بین BSD sed (مک) و GNU sed فرق دارد — روی لینوکس سرور معمولاً GNU است؛ در مستند تیم قید کنید.
آدرسها و محدود کردن دامنه
bash
sed -n '/^\[database\]/,/^\[/p' app.ini sed '10,20s/foo/bar/g' file.txt sed -n '100p' file.txt
میتوانید فقط روی بازهای از خطوط یا بین دو الگوی نشانگر بخش کار کنید. این برای فایلهای iniگونه بدون پارسر کامل مفید است — ولی شکننده است؛ اگر فرمت عوض شود میشکند.
awk: فیلدها و جداکننده
bash
echo 'alice 32 tehran' | awk '{print $1, $3}' awk -F: '{print $1}' /etc/passwd | head ps aux | awk 'NR==1 || $3+0 > 5.0 {print $0}' ss -tlnp | awk 'NR>1 {print $4}'
پیشفرض جداکننده فاصله/تب است؛ -F: برای passwd. NR شمارهٔ رکورد؛ $NF آخرین فیلد. مقایسهٔ عددی را با +0 یا صراحت عددی از رشته جدا کنید.
awk برای جمع و گزارش
bash
awk '{sum+=$1} END {print sum}' numbers.txt awk '{c[$1]++} END {for (k in c) print c[k], k}' access.log | sort -nr | head
الگوی شمارش IP یا کد وضعیت در لاگ access با awk چند خطی کوتاه و سریع است. برای لاگ JSON، jq معمولاً درستتر است.
جدول تصمیم sed در برابر awk
| کار | ترجیح |
|---|---|
| جایگزینی رشته در خط | sed |
| حذف خطوط مطابق الگو | sed یا grep -v |
| چاپ ستون ۲ و ۵ | awk (یا cut) |
| جمع یک ستون | awk |
| گزارش گروهبندیشده | awk |
| پارسر زبان کامل | نه این دو — زبان واقعی |
cut و tr در کنار آنها
bash
cut -d: -f1,7 /etc/passwd | head echo 'A B C' | tr ' ' '\n' echo 'hello' | tr 'a-z' 'A-Z'
برای جداکنندهٔ تککاراکتر ثابت، cut سادهتر از awk است. tr برای تبدیل نویسه. ابزار کوچک را وقتی مسئله کوچک است انتخاب کنید.
لولهٔ واقعی عملیات
bash
journalctl -u myapp -n 1000 --no-pager \ | grep -i error \ | awk '{print $1, $2, $5}' \ | sed 's/\[[0-9]*\]//' \ | sort | uniq -c | sort -nr | head
هر مرحله یک مسئولیت: فیلتر، برش فیلد، تمیزکاری، آمار. خوانایی مهمتر از فشردن همه در یک awk غولآساست.
نقلقول و شل
اسکریپتهای sed/awk داخل شل بهخاطر $ و بکاسلش میشکنند. عادت سالم: اسکریپتهای غیریکخطی را در فایل جدا با تکنقلقول یا heredoc نگه دارید.
bash
awk -f report.awk access.log sed -f transforms.sed config.in > config.out
نمونهٔ sed پیشرفتهتر (هنوز کاربردی)
bash
sed -E 's/([0-9]{1,3}\.){3}[0-9]{1,3}/[IP]/g' app.log | head sed 's/[[:space:]]\+$//' file.txt > file.stripped
-E برای ERE در GNU sed خوانایی را بالا میبرد. حذف فاصلهٔ ته خط قبل از commit Diffهای نویزی را کم میکند.
نمونهٔ awk: میانگین و شرط
bash
awk -F, 'NR>1 {sum+=$3; n++} END {if(n) print sum/n}' data.csv awk -F, 'NR>1 && $3+0 > 100 {print $1,$3}' data.csv
اگر CSV شما فیلد داخل نقلقول با ویرگول دارد، این یکخطیها دروغ میگویند — از پارسر CSV واقعی استفاده کنید.
اشتباههای رایج
- sed -i بدون بکاپ روی فایل production.
- فرض یکسان بودن BSD sed و GNU sed.
- awk روی JSON با regex شکننده.
- فراموش اینکه جداکنندهٔ پیشفرض awk فقط فاصله نیست بلکه FS پیشفرض است.
- نوشتن برنامهٔ ۲۰۰ خطی awk وقتی Python خواناتر است.
چه زمانی به ابزار دیگر بروید؟
- JSON/YAML: jq / yq.
- جدول پیچیده و join: Python+pandas یا csvkit.
- بازنویسی ساختاریافتهٔ AST کد: ابزار زبان نه sed.
sed/awk برای چسب عملیات عالیاند؛ برای منطق کسبوکار بلندمدت، کد تستپذیر بهتر است.
قابلحمل بودن در CI
ایمژ alpine گاهی sed/awk BusyBox با زیرمجموعهٔ پرچمها دارد. اگر به -i.bak یا gawk خاص وابستهاید، در Dockerfile بستهٔ GNU را نصب یا از ایمیج کاملتر استفاده کنید و در README قید کنید.
تمرین ذهنی قبل از اجرا
- روی ۱۰ خط نمونه با echo/heredoc بیازمایید.
- روی کپی فایل واقعی بدون -i.
- diff با اصل.
- بعد روی هدف با بکاپ.
ویرایش امن پیکربندی با نشانگر
به جای جایگزینی سراسری یک کلمه، بخش را با نشانگر محدود کنید تا تغییر جانبی کم شود. بعد با diff و تست سرویس تأیید کنید. اگر ابزار رسمی `edit-config` دارید، همان را ترجیح دهید.
bash
cp nginx.conf nginx.conf.bak sed -i.bak '/# FEATURE_X_BEGIN/,/# FEATURE_X_END/s/off/on/' nginx.conf diff -u nginx.conf.bak nginx.conf | head
awk برای گزارش دسترسی وب
نمونهٔ آموزشی شمارش کد وضعیت در لاگ ترکیبی فاصلهدار:
bash
awk '{code=$9; c[code]++} END {for (k in c) printf "%s %d\n", k, c[k]}' access.log | sort -k2 -nr | head
شمارهٔ فیلد به فرمت لاگ وابسته است؛ اول یک خط را با awk '{print NF,$0}' ببینید. این گزارش جایگزین سیستم تحلیلی نیست ولی برای حادثهٔ سریع کافی است.
مرز مسئولیت در لوله
اگر دیدید یک awk هم فیلتر میکند هم جایگزین میکند هم آمار میگیرد، احتمالاً زمان شکستن به مراحل است. نگهداری و تست جداگانه ارزانتر از یکخطی افسانهای است.
تست رگرسیون برای یکخطیها
یکخطیهای عملیات اگر وارد مسیر تولید شدند باید نمونهٔ ورودی ثابت داشته باشند. کنار اسکریپت یک fixtures کوچک بگذارید و خروجی را با diff طلایی مقایسه کنید. این کار مانع «دیروز درست بود» بدون شاهد میشود.
bash
mkdir -p /tmp/fx && printf 'a 1\nb 2\n' > /tmp/fx/in.txt awk '{print $2}' /tmp/fx/in.txt > /tmp/fx/out.txt diff -u <(printf '1\n2\n') /tmp/fx/out.txt && echo ok
هزینهٔ کم برای جلوگیری از تغییر خاموش فیلد لاگ که ناگهان ستون را جابهجا میکند.
اگر تیم بیش از دو بار در ماه همان sed را دستی زده، وقت بستهبندیاش به اسکریپت نامدار با تست است.
خلاصه
sed برای تبدیل خطمحور و جایگزینی؛ awk برای فیلد، آمار و گزارش. با grep و لوله ترکیبشان کنید، روی فایل مهم بدون بکاپ -i نزنید، و وقتی داده ساختیافتهٔ پیچیده شد به ابزار تخصصیتر مهاجرت کنید. تسلط سبک بر این دو، سرعت عیبیابی روی سرور را بالا میبرد.
سوالات متداول
آیا awk زبان کامل است؟
برای بسیاری کارها بله توریگ کامل است؛ ولی اکوسیستم، کتابخانه و خوانایی تیم معمولاً شما را به زبان عمومی میکشاند.
تفاوت awk و gawk؟
gawk پیادهسازی GNU با افزونههاست؛ روی لینوکس اغلب awk به gawk پیوند است. برای اسکریپت قابلحمل به ویژگیهای مشترک تکیه کنید.
چطور فقط خطوط ۵۰ تا ۸۰ را ویرایش کنم؟
`sed '50,80s/foo/bar/' file` یا با -i پس از بکاپ.
منابع و مراجع
- GNU sed Manual: https://www.gnu.org/software/sed/manual/sed.html
- sed(1): https://man7.org/linux/man-pages/man1/sed.1.html
- GNU Awk User's Guide: https://www.gnu.org/software/gawk/manual/gawk.html
- awk(1): https://man7.org/linux/man-pages/man1/awk.1.html
- cut(1): https://man7.org/linux/man-pages/man1/cut.1.html
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.




