Logging چیست؟ ثبت رویداد برای تشخیص و پاسخ به حادثه
لاگ رکورد زماندار رویداد است؛ ساختیافته برای Production، همبسته با trace — بر اساس OpenTelemetry Logs و Observability primer.
بنیانگذار و مهندس محصول

Logging (لاگگذاری) یعنی ثبت رویدادهای زماندار دربارهٔ آنچه در نرمافزار و زیرساخت رخ میدهد تا بعداً بتوانید بفهمید چه شد، برای چه کسی، و با چه زمینهای. OpenTelemetry لاگ را «رکورد متنی زماندار، ساختیافته یا غیرساختیافته، با فرادادهٔ اختیاری» تعریف میکند — و یادآوری میکند لاگ قدیمیترین و رایجترین سیگنال telemetry است.
در Observability primer آمده لاگها لزوماً به یک درخواست کاربر وصل نیستند؛ همهجا هستد و سالها تکیهگاه اصلی تشخیص بودهاند. اما بدون زمینه (مثل trace/span) برای دنبال کردن مسیر اجرا ضعیفاند. لاگ وقتی قوی میشود که ساختیافته باشد و با دیگر سیگنالها همبسته شود.
این مقاله نقش لاگ، سطوح شدت، ساختیافتگی، همبستگی، و ضدالگوهای امنیتی/هزینهای را پوشش میدهد و به مانیتورینگ (۱۱۳) پیوند میدهد.
پاسخ کوتاه
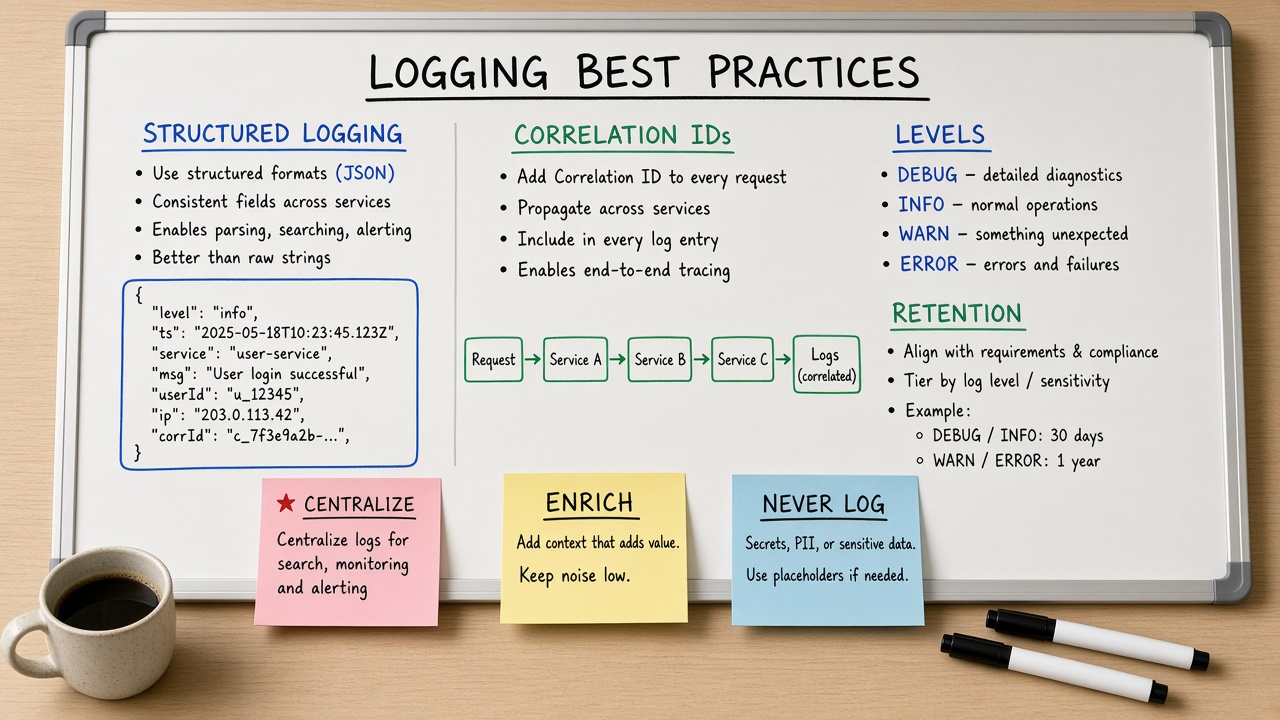
لاگ خوب در Production: رویداد را با زمان، سطح شدت، سرویس، محیط، پیام پایدار، و شناسههای همبستگی (مثل request/trace id) ثبت میکند؛ ترجیحاً با طرحوارهٔ ثابت (structured). لاگ بد: متن آزاد بدون فیلد، پر از دادهٔ حساس، بدون امکان جستجوی سریع، یا آنقدر پرحجم که کسی نگهش نمیدارد.
مانیتورینگ میگوید «نرخ خطا بالا رفت»؛ لاگ کمک میکند ببینید کدام endpoint، کدام کد خطا، و کدام کاربر/درخواست نمونه درگیر است. هر دو را لازم دارید.
اگر برای پیدا کردن یک خطا باید SSH بزنید و فایل را با چشم اسکن کنید، هنوز سامانهٔ لاگ ندارید — فقط فایل دارید.
لاگ در مدل Observability
OpenTelemetry سه سیگنال اصلی را کنار هم میگذارد: traces مسیر درخواست، metrics اندازهگیری عددی، logs ثبت رویداد. لاگ بهتنهایی برای ردیابی اجرای کد کافی نیست چون معمولاً محل فراخوانی و پیوند درخواست را کامل ندارد؛ وقتی بخشی از span شود یا با trace و span همبسته شود ارزشش چند برابر میشود.
در اپها، OpenTelemetry طوری طراحی شده که با کتابخانههای لاگ موجود کار کند و با auto-instrumentation یا SDK، شناسههای trace/span را به لاگهای فعلی شما وصل کند. یعنی لازم نیست همهچیز را از صفر بنویسید؛ پل بزنید.
ساختیافته، نیمهساختیافته، غیرساختیافته
مستندات Logs در OpenTelemetry تفاوت مهم را روشن میکند:
- Structured: طرحواره یا فیلدهای تایپشدهٔ پایدار که سیستم پاییندستی میتواند به آن تکیه کند — encoding میتواند JSON باشد ولی JSON alone کافی نیست اگر فیلدها هر بار عوض شوند.
- Unstructured: متن آزاد خوانا برای انسان؛ در توسعه رایج؛ در Production تحلیل مقیاسپذیر سخت و پرهزینه.
- Semistructured: جفت کلید/مقدار یا فیلدهای جداشده بدون تضمین طرحوارهٔ پایدار در همهٔ تولیدکنندهها.
ترجیح Production: لاگ ساختیافته با فیلدهای توافقشده (مثلاً timestamp، level، service، message، error.code، user.id هششده در صورت نیاز). Collector میتواند از فایل بخواند، پارس کند و صادر کند؛ اما از ابتدا ساختیافته نوشتن ارزانتر از پارس پیچیدهٔ بعدی است.
json
{ "timestamp": "2024-08-04T12:34:56.789Z", "level": "INFO", "service": "user-authentication", "message": "User login successful", "context": {"userId": "12345"}, "transactionId": "abcd-efgh-ijkl-mnop" }
جدول نقشها
| هدف | Logging | Monitoring |
|---|---|---|
| کشف سریع ناهنجاری عددی | ضعیفتر بهتنهایی | قوی |
| ریشهیابی یک درخواست | قوی با id همبستگی | ضعیف برای جزئیات |
| ممیزی امنیتی/فعالیت | قوی | معمولاً ناکافی |
| هزینه در مقیاس بالا | میتواند خیلی بالا باشد | معمولاً قابلپیشبینیتر |
| هشدار on-call | با احتیاط (نویز) | طبیعیتر روی متریک |
سطوح شدت و چه چیزی را بنویسید
- ERROR/FATAL: شکست نیازمند توجه؛ با کد خطا و زمینهٔ کافی بدون Secret.
- WARN: غیرعادی ولی ادامهٔ کار؛ برای روندهای در حال خراب شدن.
- INFO: رویدادهای کسبوکاری/عملیاتی مهم (شروع درخواست، پایان موفق).
- DEBUG: جزئیات توسعه؛ در Production پیشفرض خاموش یا نمونهبرداریشده.
پیام را پایدار و قابلگروهبندی نگه دارید؛ جزئیات متغیر را در فیلد بگذارید تا «۳۰۰ شکل مختلف یک خطا» داشبورد را نشکند.
همبستگی و شناسهٔ درخواست
حداقل عملی: یک request id یا transaction id که از لبه (API gateway/load balancer) تا سرویسهای داخلی در لاگ تکرار شود. اگر tracing دارید، TraceId و SpanId را طبق مدل OpenTelemetry همراه لاگ کنید. آنگاه از متریک قرمز به یک نمونهٔ لاگ و سپس به آبشار trace میرسید.
امنیت لاگ: خط قرمزها
- رمز عبور، توکن، کلید API، کوکی جلسه را لاگ نکنید.
- دادههای حساس شخصی را حداقلسازی یا ماسک کنید.
- بدنهٔ کامل درخواست را بهصورت پیشفرض در Production نریزید.
- دسترسی به سامانهٔ لاگ را مثل دسترسی به دیتابیس محدود کنید.
- retention و حذف را سیاستگذاری کنید؛ لاگ ابدی هم هزینه است هم ریسک.
نمونهٔ JSON در مستندات OpenTelemetry فیلد password را با ستاره نشان میدهد — الگو بگیرید نه کپی از دادههای واقعی.
جمعآوری در عمل
الگوی رایج کانتینری: اپ به stdout/stderr مینویسد؛ agent یا OpenTelemetry Collector میخواند، پارس و غنیسازی میکند، به backend میفرستد. Kubernetes راهحل لاگ واحد تحمیل نمیکند؛ شما انتخاب و نگهداری میکنید. برای شروع کوچک حتی یک سامانهٔ متمرکز ساده بهتر از فایل پراکنده روی چند VM است.
OpenTelemetry یادآوری میکند اولین قدم پذیرش اغلب استقرار Collector بهعنوان عامل لاگ عمومی است — قبل از بازنویسی همهٔ اپها.
مسیر مینیمال تیم کوچک
- کتابخانهٔ لاگ استاندارد زبان با خروجی JSON.
- فیلدهای اجباری: time، level، service، message، request_id.
- ممنوعیت لاگ Secret در code review.
- تجمیع متمرکز حداقل برای Production و Staging.
- پیوند بعد از Deploy: پنجرهٔ مراقبت روی ERROR.
- بعداً: همبستگی trace، نمونهبرداری DEBUG، سیاست retention.
اشتباههای رایج
- لاگ کردن داخل حلقهٔ شلوغ بدون نرخمحدود — دیسک و هزینه منفجر میشود.
- پیامهای غیرقابلجستجو با املای متغیر.
- تکیه فقط به لاگ برای هشدار بدون متریک.
- نگه داشتن DEBUG در Production برای همهٔ کاربران.
- SSH بهعنوان تنها روش دسترسی به لاگ در مقیاس چند میزبان.
جمعبندی برای تصمیم
Logging ثبت رویداد زماندار برای فهم رفتار سیستم است. در Production ساختیافته بنویسید، با شناسه همبسته کنید، Secret را راه ندهید، و کنار متریک از آن استفاده کنید. OpenTelemetry مدل و پل همبستگی را استاندارد میکند؛ backend را خودتان انتخاب میکنید.
اگر یک تغییر این هفته کافی است: خروجی JSON با request_id روی سرویس اصلی و قطع لاگ توکنها. همان دو کار زمان تشخیص را ملموس کم میکند.
منابع و مراجع
- OpenTelemetry — Logs — https://opentelemetry.io/docs/concepts/signals/logs/
- OpenTelemetry — Observability primer — https://opentelemetry.io/docs/concepts/observability-primer/
- OpenTelemetry — What is OpenTelemetry? — https://opentelemetry.io/docs/what-is-opentelemetry/
- Kubernetes Docs — What Kubernetes is not (logging) — https://kubernetes.io/docs/concepts/overview/what-is-kubernetes/
برای پایش عددی مقالهٔ ۱۱۳ و برای مسیر انتشار مقالهٔ ۰۵۰ را ببینید.
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.