Context Window چیست و چرا برای برنامهنویسی با AI اهمیت دارد؟
7 دقیقه مطالعه
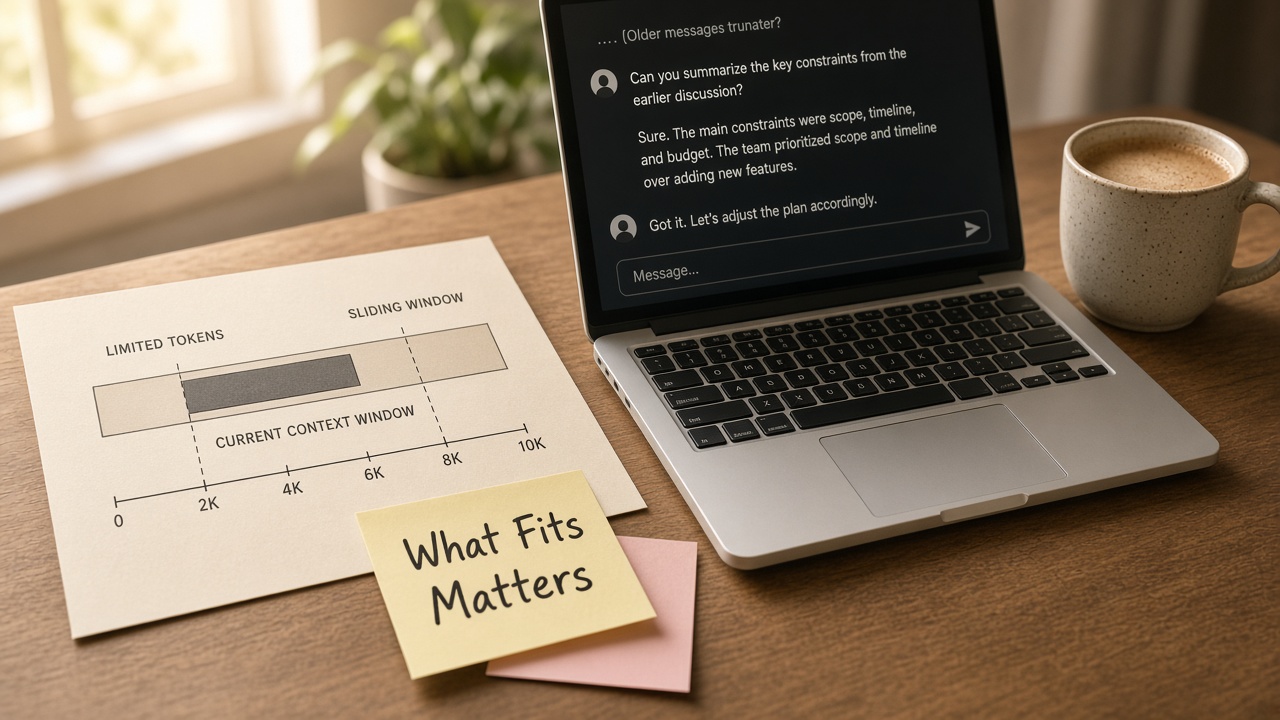
تعریف عملی context window، توکن، افت کیفیت با زمینه شلوغ، و مثال واقعی زمینه ناقص → خروجی ضعیف — با ارجاع به مستندات Anthropic و پژوهش Lost in the Middle.
وقتی از دستیار کدنویسی میپرسید «چرا این سرویس timeout میدهد؟» و جوابی عمومی میگیرید که به کد شما بیربط است، اغلب مدل «تنبل» نیست — چیزی که برای پاسخ لازم بود اصلاً داخل پنجرهٔ زمینه (Context Window) نبوده، یا بوده و در میانهٔ شلوغی گم شده است.
مستندات Anthropic پنجرهٔ زمینه را همهٔ متنی تعریف میکند که مدل هنگام تولید پاسخ میتواند به آن ارجاع دهد — شامل خود پاسخ. این با پیکرهٔ عظیم آموزش فرق دارد؛ نزدیک به «حافظهٔ کاری» برای همان درخواست است. پنجرهٔ بزرگتر اجازه میدهد پرامپت پیچیدهتر و طولانیتری بدهید، اما بیشتر بودن خودکار بهتر نیست: با رشد تعداد توکن، دقت و بازیابی افت میکند؛ پدیدهای که Anthropic آن را context rot مینامد.
برای برنامهنویس، فهم این محدودیت مهمتر از حفظ عدد بازاریابی «۱ میلیون توکن» است.
پاسخ کوتاه
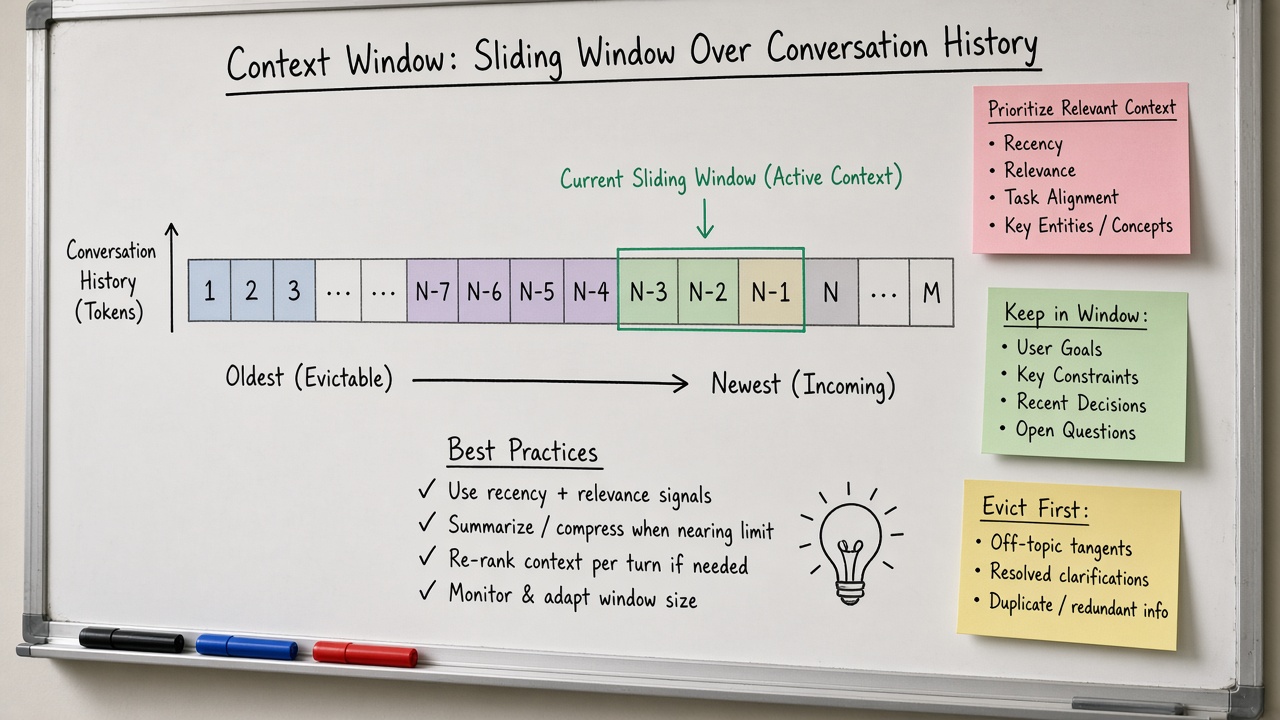
Context Window سقف توکنهایی است که در یک نوبت — ورودی بهعلاوهٔ خروجی — مدل میتواند در نظر بگیرد. سیستمپرامپت، تاریخچهٔ چت، فایلهای الصاقشده، تعریف ابزارها، و پاسخ تولیدشده همه از همین بودجه مصرف میکنند. اگر قرارداد مهم در فایل غایب باشد، خروجی ضعیف یا ساختگی میشود. اگر همهچیز را بدون اولویت بریزید داخل زمینه، سیگنال مفید در میانه گم میشود — پژوهشی که به «Lost in the Middle» معروف است.
بودجهٔ زمینه را مثل RAM محدود ببینید: چه چیزی لایق ماندن است؟
توکن چیست و چرا عدد فایل با عدد توکن یکی نیست؟
مدلها متن را به توکن میشکنند — تکههای زیربخش کلمه یا نماد. طبق توضیح Tokenizer رسمی OpenAI، برای متن انگلیسی رایج تقریباً هر ۱۰۰ توکن حدود ۷۵ کلمه است (تقریباً ۴ کاراکتر به ازای یک توکن). کد، JSON، و فارسی اغلب نسبت متفاوتی دارند؛ پس «این فایل ۲۰۰ خط است پس جا میشود» حساب دقیقی نیست.
ابزارهای شمارش توکن (مثل tokenizer وب OpenAI یا API شمارش Anthropic) قبل از ارسال درخواست بزرگ جلوی خطا را میگیرند. وقتی ورودی از سقف بگذرد، API معمولاً خطا میدهد یا در برخی مدلها تولید زود قطع میشود.
چه چیزهایی بودجه را میخورند؟
- سیستمپرامپت و Rules پروژه
- پیامهای قبلی گفتوگو
- فایلها، Diffها، لاگها و تصاویر
- تعریف ابزارها (tool schemas) در حالت Agent
- نتایج ابزار (خروجی تست، محتوای فایل خواندهشده)
- فکر/thinking مدل در صورت فعال بودن
- خود پاسخ نهایی
Anthropic صریح میگوید همهچیز در درخواست شمرده میشود؛ حتی prompt caching هزینهٔ پنجره را حذف نمیکند — فقط نحوهٔ صورتحساب را تغییر میدهد. در عمل یعنی یک Agent که ده فایل بزرگ و سه بار خروجی تست پرحجم را برمیگرداند، سریع به سقف نزدیک میشود.
مثال واقعی: زمینهٔ ناقص → خروجی ضعیف
فرض کنید سرویس سفارش این قرارداد را دارد:
python
# src/orders/api.py @router.get("/orders") def list_orders(user_id: str, cursor: str | None = None, limit: int = 50): """صفحهبندی مبتنی بر cursor؛ limit حداکثر ۱۰۰.""" ...
توسعهدهنده فقط فایل UI را باز کرده و میپرسد: «برای صفحهٔ سفارشها فراخوانی API را بنویس.» مدل — بدون دیدن api.py — ممکن است endpoint فرضی /api/v1/user/orders با page و page_size بسازد، فیلدهایی اختراع کند که بکاند ندارد، و خطاهای ۴۲۲ را اشتباه هندل کند. کد «درست به نظر میرسد»، حتی تست جعلی مینویسد، اما در یکپارچهسازی میشکند.
اگر همان سوال با ارجاع صریح به api.py و نمونهٔ کلاینت موجود /users باشد، احتمال همراستایی بالا میرود. تفاوت اصلی مدل نبود؛ تفاوت محتوایی بود که داخل پنجرهٔ زمینه قرار گرفت.
پنجرهٔ بزرگتر همیشه بهتر نیست
Anthropic هشدار میدهد که با رشد توکن، accuracy و recall افت میکند (context rot)؛ مهندسی محتوا به اندازهٔ ظرفیت مهم است. مقالهٔ دانشگاهی «Lost in the Middle» (Liu و همکاران، ۲۰۲۳) نشان داد عملکرد مدلها وقتی اطلاعات مرتبط در میانهٔ زمینهٔ طولانی باشد افت میکند و در ابتدا/انتهای زمینه بهتر است — منحنی U شکل.
پیام عملی برای کدنویسی: ۱۰ فایل متوسط نامرتبط بدتر از ۳ فایل درست است. لاگ ۵۰۰۰ خطی را کامل paste نکنید؛ بخش خطا بهعلاوهٔ ۲۰ خط اطراف را بدهید. در بازیابی اسناد، اسناد طولانی را بالاتر و پرسش را نزدیک انتها قرار دادن — طبق راهنمای Anthropic — میتواند کیفیت را بهتر کند.
اعداد زمینه در عمل (تقریبی و وابسته به مدل)
اعداد دقیق با نسخه عوض میشوند؛ همیشه جدول رسمی ارائهدهنده را چک کنید. در مستندات Anthropic، برخی مدلهای Claude زمینهٔ حدود ۲۰۰k توکن و برخی تا حدود ۱M دارند. در جدول مدلهای Cursor نیز برای مدلهای مختلف default/max context گزارش شده (مثلاً ۲۰۰k تا ۱M بسته به مدل و حالت). این ارقام ظرفیت خاماند، نه مجوز ریختن کل مونوریپو در یک چت.
| سیگنال | تفسیر برای برنامهنویس |
|---|---|
| سقف توکن | حد سخت درخواست؛ تجاوز = خطا یا قطع |
| کیفیت در میانه | ممکن است حتی با جا شدن فیزیکی ضعیف باشد |
| هزینه | ورودی بزرگ = پول و تأخیر بیشتر |
| تاریخچهٔ چت | نشست طولانی بودجه را بیصدا میخورد |
استراتژیهای عملی برای کدنویسی با AI
- هدف را کوچک کنید؛ یک معیار پذیرش در هر نشست.
- فایلهای قرارداد، تست و نمونهٔ مشابه را اول بیاورید.
- بهجای paste کل مخزن، بگذارید Agent با جستجو فایل مرتبط را پیدا کند.
- خروجی تست را خلاصه کنید: شکست + assertion، نه کل لاگ سبز.
- وقتی موضوع عوض شد، چت تازه باز کنید تا تاریخچه نویز نشود.
- قواعد پروژه را کوتاه و اجرایی نگه دارید؛ Rules رمانمانند بودجه را میبلعد.
Context window در برابر حافظهٔ بلندمدت
پنجرهٔ زمینه برای یک گفتوگو/درخواست است. دانش آموزشدیدهشدهٔ مدل «حافظهٔ پارامتری» است و ممکن است قدیمی یا عمومی باشد. برخی ابزارها حافظهٔ پروژه، ایندکس برداری یا خلاصهسازی (compaction) دارند تا کار طولانی ادامه یابد؛ اما خلاصه ممکن است جزئیات حیاتی را حذف کند. برای حقیقت منبع، فایل و تست مخزن را به خلاصهٔ مدل ترجیح دهید.
اشتباههای رایج
- فرض اینکه چون مدل ۱M توکن دارد، کل شرکت را یکجا بفهمد
- چسباندن secrets داخل زمینه «چون فقط همین چت است»
- نشست ۸ ساعته بدون پاکسازی با کیفیت نزولی
- گذاشتن اطلاعات حیاتی فقط در میانهٔ پرامپت بسیار بلند
- نادیده گرفتن سهم tool results در بودجه
سوالات متداول
اگر زمینه پر شود چه میشود؟
بسته به ارائهدهنده: خطای «prompt too long»، قطع تولید با دلیل سقف زمینه، یا خلاصهسازی سمت سرور (compaction) در محصولات جدیدتر. روی خطا تکیه نکنید؛ beforehand بشمارید و کوتاه کنید.
آیا تصویر و PDF هم توکن مصرف میکنند؟
بله. مستندات Anthropic تأکید میکند تصاویر و اسناد در شمارش میآیند و ممکن است قبل از سقف توکن به محدودیت تعداد صفحه/حجم برخورد کنید.
برای ریفکتور بزرگ چه کنم؟
کار را برش بزنید، وضعیت را در فایل پیشرفت/تست ساختیافته نگه دارید، و بین نشستها از git بهعنوان منبع حقیقت استفاده کنید — نه از حافظهٔ چت.
خلاصه
Context Window بودجهٔ حافظهٔ کاری مدل در هر درخواست است. کیفیت برنامهنویسی با AI بیشتر از عدد سقف، به انتخاب محتوای داخل بودجه وابسته است. زمینهٔ ناقص خروجی ضعیف میسازد؛ زمینهٔ شلوغ سیگنال را در میانه گم میکند. عمداً انتخاب کنید، برش بزنید، و حقیقت را در مخزن و تست نگه دارید.
منابع و مراجع
- Anthropic Docs — Context windows: https://docs.anthropic.com/en/docs/build-with-claude/context-windows
- OpenAI — Tokenizer: https://platform.openai.com/tokenizer/
- arXiv — Lost in the Middle: How Language Models Use Long Contexts: https://arxiv.org/abs/2307.03172
- Cursor Docs — Models (context columns): https://cursor.com/docs
- Anthropic Docs — Prompt engineering best practices (long context): https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/claude-prompting-best-practices
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.