Cache چیست؟ انواع Cache و دلیل اهمیت آن در وب
تعریف Cache در وب: Browser cache، CDN/shared cache، Application cache و DB cache؛ تفاوت Fresh/Stale، Invalidation و Cache-Control بر اساس RFC 9111، MDN و web.dev.
سا
10 دقیقه مطالعهسهیل ابراهیمپور
بنیانگذار و مهندس محصول
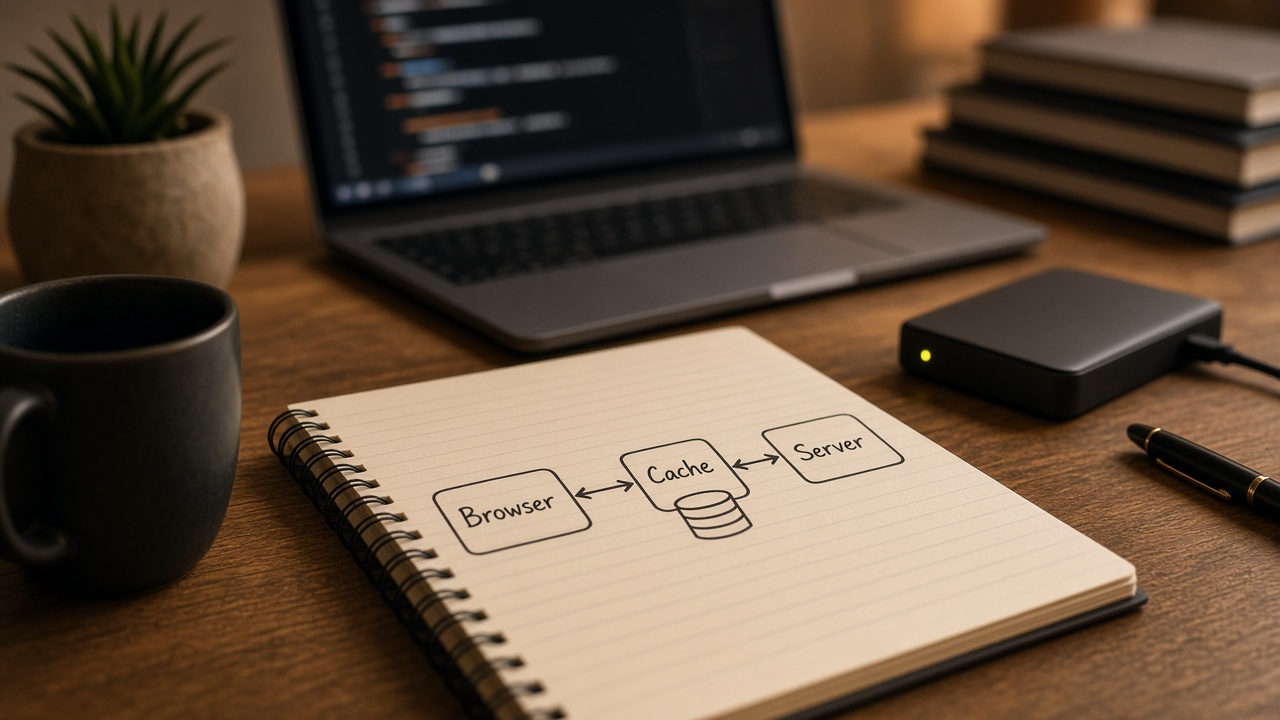
وقتی صفحهای را دوباره باز میکنید و فوری بالا میآید، معمولاً بخشی از پاسخ از قبل جایی ذخیره شده است. در وب، به این ذخیرهٔ موقت و قابلاستفادهٔ مجدد Cache (کش) میگویند: نگهداشتن یک پاسخ یا نتیجهٔ محاسبهشده تا درخواست بعدی مجبور نباشد همان کار گران را از اول تکرار کند.
Cache فقط یک «فایل در مرورگر» نیست. لایههای متفاوتی وجود دارد: کش مرورگر روی دستگاه کاربر، کش اشتراکی روی CDN یا پروکسی، کش داخل خود اپلیکیشن، و کش جلوی پایگاهداده. هر لایه هدف، دامنهٔ اشتراک، و ریسک کهنگی خودش را دارد. RFC 9111 استاندارد رسمی HTTP Caching است و MDN و web.dev همان مفاهیم را برای پیادهسازی روزمره توضیح میدهند.
این مقاله تعریف لایهها، تفاوت Fresh و Stale، نقش Invalidation، و این را میگوید که Cache همیشه «خوب» نیست: اگر سیاست اشتباه باشد، کاربر یا ربات نسخهٔ قدیمی میبیند، یا دادهٔ شخصی بین کاربران نشت میکند. هدف کمک به تصمیم است؛ نه تشویق به کش کردن کور همه چیز.
پاسخ کوتاه
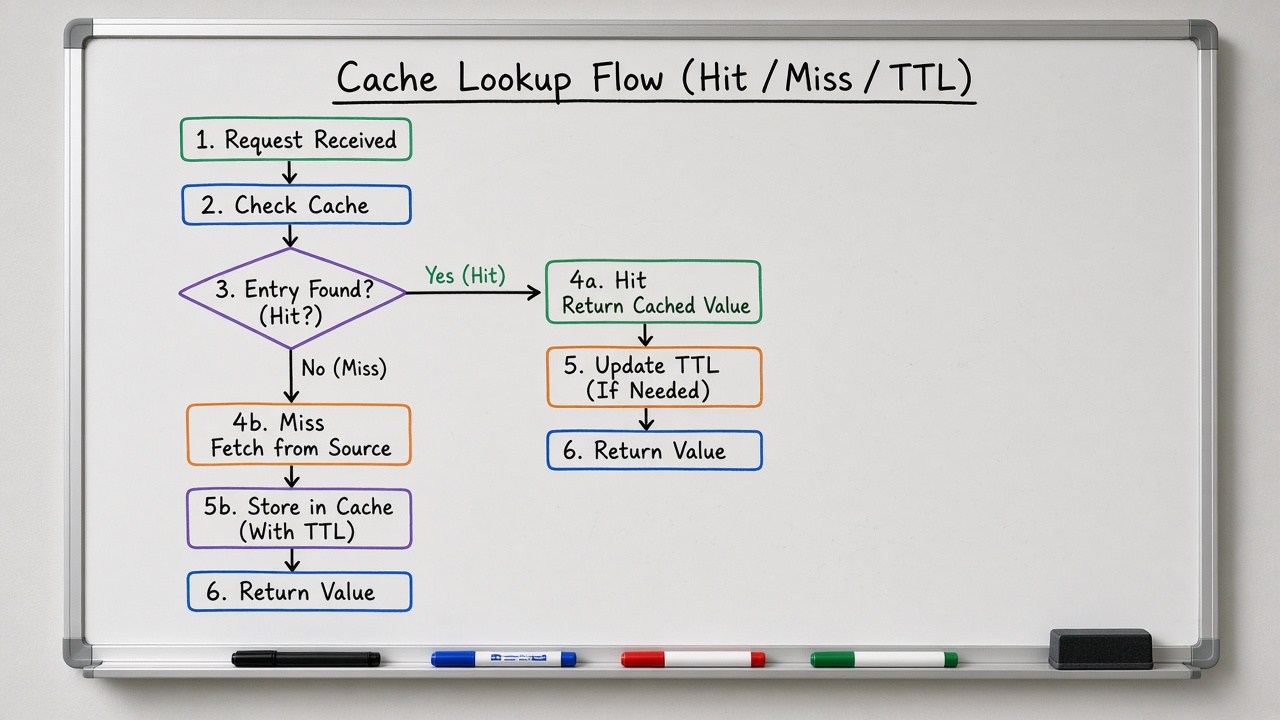
Cache یعنی نگهداشتن پاسخ یا نتیجه برای استفادهٔ دوباره، تا تأخیر شبکه، بار سرور مبدأ (Origin)، و هزینهٔ پردازش کم شود. در HTTP طبق RFC 9111، پاسخ ذخیرهشده تا وقتی Fresh است بدون تماس با Origin قابل استفاده است؛ وقتی Stale شد معمولاً باید Validation (اعتبارسنجی) شود یا از نو گرفته شود.
چهار لایهٔ رایج: Browser/private cache روی یک کاربر؛ Shared cache مثل CDN بین چند کاربر؛ Application cache داخل منطق برنامه (حافظه، Redis و مشابه)؛ و DB/query cache جلوی پایگاهداده. موفقیت یعنی سیاست درست برای هر نوع محتوا — نه اینکه «همهچیز را تا ابد کش کنید».
کش خوب سرعت میدهد؛ کش بدون سیاست، کهنگی و گاهی نشت داده میسازد.
Cache در HTTP دقیقاً چه کاری میکند؟
طبق MDN و RFC 9111، HTTP cache پاسخ مرتبط با یک درخواست را ذخیره میکند و برای درخواستهای بعدی معادل، همان پاسخ را بازاستفاده میکند. فایده دو لایه است: نزدیکتر بودن به کلاینت یعنی پاسخ سریعتر؛ و وقتی پاسخ قابل استفاده باشد، Origin لازم نیست دوباره درخواست را پارس کند، نشست را بسازد، به دیتابیس برود یا قالب را رندر کند.
استاندارد تأکید میکند Caching اختیاری است، اما رفتار پیشفرض سیستمها معمولاً «اگر ممنوع نشده، بازاستفاده مطلوب است». بنابراین قواعد HTTP بیشتر روی جلوگیری از ذخیره یا استفادهٔ نامناسب تمرکز دارند تا اجبار به کش کردن همه چیز. MDN صریح میگوید عملکرد درست کش برای سلامت سیستم حیاتی است.
web.dev میگوید اولین خط دفاع در برابر درخواست شبکهٔ غیرضروری، HTTP Cache مرورگر است: همهٔ مرورگرهای رایج از ترکیب هدرهایی مثل Cache-Control، ETag و Last-Modified پشتیبانی میکنند. بدون Cache-Control صریح، مرورگر ممکن است Heuristic caching انجام دهد — یعنی خودش حدس بزند چقدر نگه دارد؛ برای کنترل واقعی، هدر را صریح تنظیم کنید.
کلید کش در سادهترین شکل، ترکیب متد و URI است؛ بسیاری از کشهای عملی فقط GET را نگه میدارند. اگر محتوا بر اساس مذاکرهٔ محتوا (زبان، encoding) فرق کند، هدر Vary به کش میگوید کدام هدرهای درخواست را هم در کلید لحاظ کند. Vary اشتباه یا بیش از حد گسترده، Hit ratio را میکشد.
Private در برابر Shared: Browser و CDN
RFC 9111 دو نوع اصلی تعریف میکند: Private cache مخصوص یک کاربر (معمولاً Browser cache) و Shared cache که پاسخ را برای بیش از یک کاربر نگه میدارد (پروکسی، CDN، reverse proxy).
Browser cache (Private)
کش مرورگر روی دستگاه همان کاربر میماند و میتواند پاسخ شخصیسازیشده را نگه دارد. اگر محتوا شخصی است و نباید در کش اشتراکی دیده شود، پاسخ باید با دستور Cache-Control: private مشخص شود. MDN هشدار میدهد صرف وجود Cookie بهتنهایی پاسخ را private نمیکند؛ باید صریح اعلام کنید.
کاربر با Reload و Force Reload رفتار متفاوتی میبیند: Reload معمولاً اعتبارسنجی میخواهد؛ Force Reload اغلب با no-cache در درخواست، پاسخ تازهٔ کامل میگیرد. اینها ابزار اشکالزداییاند، نه جایگزین سیاست سرور.
CDN و shared / managed cache
کش اشتراکی بین کلاینت و Origin مینشیند و یک پاسخ عمومی را برای کاربران متعدد بازاستفاده میکند. MDN زیرعنوان Managed caches از reverse proxy، CDN و ترکیب Service Worker با Cache API نام میبرد: اینها را تیم سرویس مستقر میکند تا Origin سبک شود و تحویل کارآمدتر شود.
نکتهٔ عملی: در کش مدیریتشده اغلب میتوانید با API یا داشبورد، ورودی را Purge کنید — چیزی که استاندارد خام HTTP برای حذف فعال در میانیها تعریف نکرده است. به همین دلیل سیاست «TTL بلند + ابطال صریح» روی CDN رایج است. بعضی CDNها هدرهای اختصاصی مثل Surrogate-Control دارند؛ کار استانداردسازی CDN-Cache-Control هم در جریان بوده است.
Application cache و Database cache
علاوه بر HTTP، برنامهها لایهٔ Application cache دارند: نتیجهٔ یک محاسبه، پاسخ یک API داخلی، یا شیء پرکاربرد را در حافظهٔ فرایند، یا در سامانهای مثل Redis نگه میدارند. این لایه تحت کنترل مستقیم تیم است و میتواند کلید، TTL و Invalidation را دقیقتر از HTTP تعریف کند — اما باید با Consistency کسبوکار همخوان باشد.
Database cache یا Query cache یعنی نتیجهٔ پرسوجو یا ردیفهای پرتکرار را نزدیک اپ نگه دارید تا فشار روی دیسک و CPU دیتابیس کم شود. فایده در ترافیک خواندن بالا مشخص است؛ ریسک وقتی است که داده عوض شده و کش هنوز نسخهٔ قبلی را میدهد. اینجا هم «کش همیشه خوب» نیست: برای موجودی انبار لحظهای یا موجودی حساب، TTL کوتاه یا ابطال رویدادمحور معمولاً امنتر از کش بلندمدت کور است.
این لایهها جایگزین HTTP Cache نیستند؛ مکملاند. صفحهٔ HTML ممکن است با no-cache به مرورگر برود، در حالی که لیست محصولات داخل اپ چند ثانیه در Redis بماند، و فایل CSS نسخهدار یک سال در مرورگر و CDN بماند. اگر هر لایه را جدا نفهمید، با یک مشکل کندی، «کش را خاموش کنید» را روی همه چیز اعمال میکنید و ریشه را گم میکنید.
Fresh، Stale، Validation و Invalidation
در مدل RFC 9111، پاسخ ذخیرهشده Fresh است اگر Age آن از freshness lifetime نگذشته باشد؛ وگرنه Stale است. عمر تازه معمولاً با max-age یا Expires مشخص میشود. پاسخ Stale فوراً دور ریخته نمیشود: اغلب با درخواست شرطی (If-None-Match با ETag یا If-Modified-Since با Last-Modified) Validation میشود و سرور ممکن است 304 Not Modified برگرداند تا بدنه دوباره منتقل نشود.
MDN تفاوت مهم no-cache و no-store را روشن میکند: no-cache اجازهٔ ذخیره میدهد ولی قبل از بازاستفاده Validation اجباری است؛ no-store میگوید اصلاً ذخیره نکن. برای محتوای شخصی که باید بهروز بماند، ترکیب no-cache و private اغلب مفیدتر از پاشیدن no-store بیرویه است — چون no-store بعضی مزایای پلتفرم مثل bfcache را هم محدود میکند.
Invalidation یعنی بیاعتبار کردن پاسخ ذخیرهشده پس از تغییر حالت. در HTTP، متدهای ناامن مثل POST/PUT/DELETE میتوانند URI هدف را در کشهای مسیر Invalidate کنند؛ اما این تضمین جهانی همهٔ کشهای اینترنت نیست. در CDN، Purge/Invalidation صریح ابزار اصلی «محتوا عوض شد، نسخهٔ کهنه را بردار» است. تفاوت Stale با Invalidation: Stale یعنی عمر تازگی تمام شده؛ Invalidation یعنی قبل از انقضا هم عمداً بیاعتبار شده.
RFC 9111 همچنین یادآوری میکند کش جداشده از Origin در شرایطی ممکن است پاسخ Stale سرو کند؛ دستورهایی مثل must-revalidate این رفتار را برای پاسخهای حساس محدود میکنند. برای تراکنش مالی یا وضعیت حساس، سیاست سختگیرانهتر از «TTL بلند و امید» لازم است.
Cache-Control: چند الگوی کاربردی
| الگو | نمونه دستور | مناسب برای |
|---|---|---|
| نسخهدار و تغییرناپذیر | max-age بلند + immutable (در پشتیبانی مرورگر) | JS/CSS/تصویر با hash در URL |
| همیشه چک با Origin | no-cache (+ private اگر شخصی) | HTML اصلی، API حساس بدون نسخه |
| ذخیره نشود | no-store | پاسخهای بسیار حساس وقتی ذخیره محلی هم نامطلوب است |
| فقط مرورگر | private, max-age کوتاه | صفحهٔ بعد از لاگین |
| اشتراکی با عمر جدا | s-maxage برای shared | تنظیم متفاوت CDN نسبت به مرورگر |
web.dev برای URLهای fingerprintشده پیشنهاد میکند Cache-Control: max-age=31536000 تا یک سال از شبکه بینیاز شوید؛ برای URL بدون نسخه، revalidation با ETag/Last-Modified را توصیه میکند. Cache busting یعنی با عوض شدن محتوا، URL عوض شود تا کلید کش عوض شود — چون کش اساساً با URL (و در صورت Vary، با هدرهای نامبرده) کلید میخورد.
الگوی رایج دیگر: HTML با no-cache تا همیشه بتواند نسخهٔ جدید داراییها را معرفی کند؛ داراییهای داخل HTML با نام هششده و max-age بلند. اگر HTML را هم یک سال کش کنید بدون Purge، کاربر تا انقضا همان باندل قدیمی را میبیند.
چرا Cache مهم است — و چرا همیشه خوب نیست
اهمیت عملی سه چیز است: کاهش Latency برای کاربر، کاهش بار و هزینهٔ Origin، و تحمل بهتر اوج ترافیک وقتی پاسخ از لبه یا حافظه میآید. بدون کش، هر بازدید همان مسیر گران را تکرار میکند؛ با کش نادرست، یا همیشه Origin شلوغ است، یا کاربر نسخهٔ غلط میبیند.
سناریوهای خطرناک رایج:
- کش کردن پاسخ شخصی در Shared cache بدون private → نشت اطلاعات بین کاربران.
- TTL خیلی بلند روی HTML بدون Purge → قیمت یا موجودی کهنه در صفحه.
- فرض «Cache همیشه سرعت و SEO میآورد» بدون اندازهگیری — کش بد میتواند تجربه را خراب کند.
- نادیده گرفتن Vary وقتی محتوا بر اساس زبان یا encoding فرق میکند → سرو نسخهٔ اشتباه.
- Kitchen-sink از دستورهای متناقض بدون فهم no-cache در برابر no-store → رفتار غیرقابل پیشبینی.
RFC 9111 در ملاحظات امنیتی از Cache poisoning و نشت اطلاعات حساس از کش نام میبرد. درک محل ذخیره (private در برابر shared) بخش دفاع است، نه جزئیات فرعی.
تصمیم درست این است: برای هر کلاس منبع بپرسید عمومی است یا خصوصی، چقدر تغییر میکند، و اگر کهنه شد هزینهٔ کسبوکار چیست. سپس لایه و دستور مناسب را انتخاب کنید — نه شعار «هرچه بیشتر کش بهتر».
چکلیست عملی برای تیم
- برای هر مسیر مهم مشخص کنید لایهٔ هدف چیست: مرورگر، CDN، اپ، یا دیتابیس.
- دارایی استاتیک را نسخهدار کنید و max-age بلند بدهید؛ HTML را جدا سیاستگذاری کنید.
- پاسخ بعد از لاگین را private یا غیرقابلکش اشتراکی کنید.
- مسیر Purge/Invalidation روی CDN را قبل از روز انتشار بزرگ تمرین کنید.
- بعد از تغییر سیاست، با ابزار شبکهٔ مرورگر Hit/Miss و Age را ببینید — حدس نزنید.
جمعبندی برای تصمیم
Cache در وب یک مفهوم لایهای است: مرورگر، CDN/shared، اپلیکیشن، و پایگاهداده. استاندارد رفتار HTTP را RFC 9111 میدهد؛ MDN واژگان Fresh/Stale/Validation را جا میاندازد؛ web.dev الگوی عملی نسخهٔ دارایی و revalidation را خلاصه میکند.
اگر یک کار این هفته انجام میدهید: برای داراییهای استاتیک نسخهدار max-age بلند بگذارید، برای HTML اصلی no-cache (و در صورت شخصی بودن private) تنظیم کنید، و مسیر Purge روی CDN را برای انتشار محتوا تمرین کنید. برای نقش CDN در تحویل و نکات خزش، مقالهٔ ۰۴۰ را بخوانید.
منابع و مراجع
- RFC 9111 — HTTP Caching — https://www.rfc-editor.org/rfc/rfc9111
- MDN — HTTP caching — https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching
- MDN — Cache-Control header — https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Cache-Control
- web.dev — Prevent unnecessary network requests with the HTTP Cache — https://web.dev/articles/http-cache
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.