AI در شرکت چه زمانی واقعاً بهرهوری را بالا میبرد؟
شرایط واقعی افزایش بهرهوری با GenAI در توسعه نرمافزار: نوع کار، وضوح مسئله، ظرفیت Review و کیفیت — با ارجاع به پژوهشهای GitHub و METR، بدون آمار ساختگی.
بنیانگذار و مهندس محصول
داشتن لایسنس مدل یا دستیار کدنویسی بهخودیخود بهمعنای تیم سریعتر نیست. گاهی زمان نوشتن کم میشود و زمان Review، دیباگ، و بازنویسی زیاد میشود. گاهی هم حس «سریعتر شدن» با اندازهگیری واقعی همخوان نیست. سؤال درست این نیست که «AI خوب است یا بد؟»؛ این است که در کدام کار، با کدام فرایند، واقعاً خروجی مفید در واحد زمان بالا میرود.
پژوهشهای منتشرشده تصویر یکنواختی نمیدهند: در آزمایشهای کنترلشدهٔ GitHub روی وظایف مشخص، گروه با Copilot سریعتر به پایان رسید؛ در RCT منتشرشدهٔ METR روی توسعهدهندگان باتجربهٔ متنباز روی مخازن خودشان، اجازهٔ استفاده از ابزارهای AI در بازهٔ early-2025 با افزایش زمان تکمیل همراه بود. این تناقض ظاهری درس عملی دارد: اثر به زمینه وابسته است. این مقاله همان شرایط را باز میکند.
پاسخ کوتاه
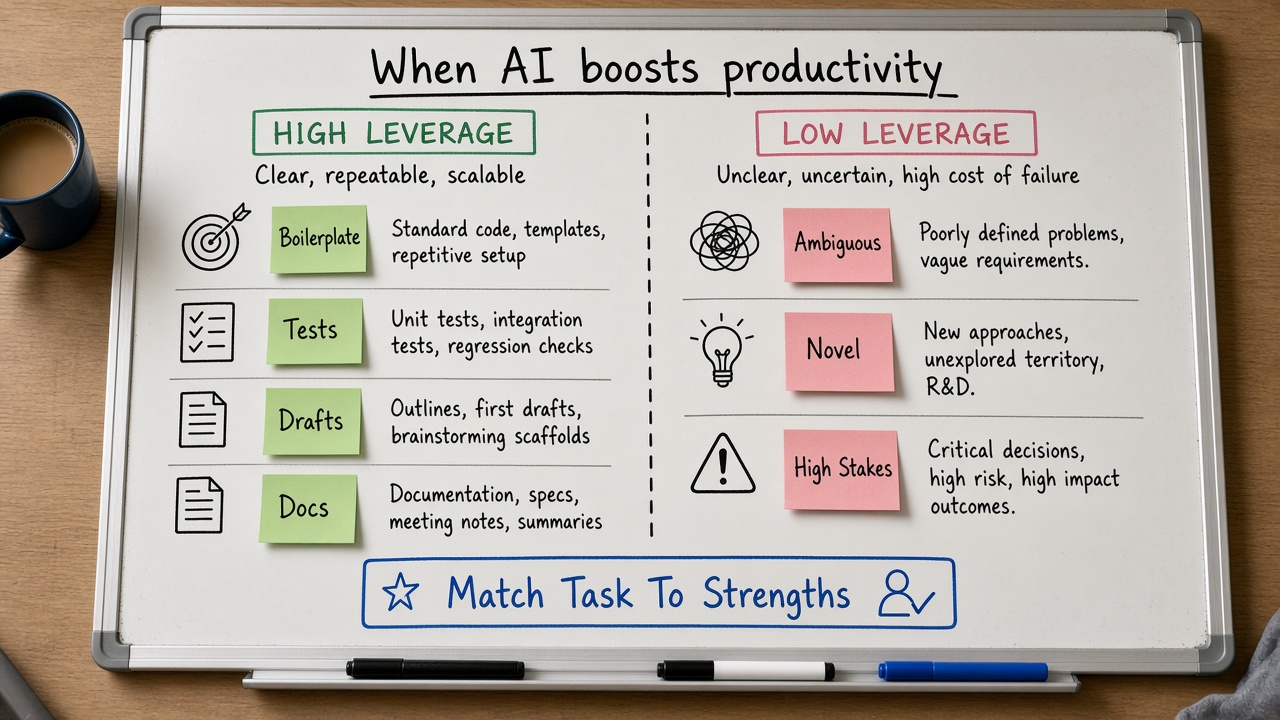
AI معمولاً وقتی بهرهوری را بالا میبرد که کار محدود و تکراری باشد، مسئله از قبل روشن باشد، خروجی قابلتست باشد، و تیم ظرفیت Review واقعی داشته باشد. وقتی کار نیازمند درک عمیق معماری ناشناخته، استاندارد کیفیت سخت، یا تصمیم پرمخاطره است و Review گلوگاه میشود، «تولید بیشتر» میتواند سرعت تحویل مفید را پایین بیاورد. حس سرعت را با شاهد (تست، Diff خواندهشده، چرخهٔ تحویل) جایگزین کنید.
بهرهوری یعنی ارزش تحویلشده در زمان؛ نه تعداد توکن تولیدشده.
بهرهوری چیست؟ سه تعریف که قاطی نکنید
قبل از قضاوت دربارهٔ AI، واحد اندازهگیری را مشخص کنید:
- سرعت نوشتن پیشنویس: زمان تا اولین نسخهٔ قابلخواندن.
- سرعت تحویل مفید: زمان تا تغییر ادغامشده، پایدار، و قابلنگهداری.
- تجربهٔ توسعهدهنده: بار ذهنی، جریان کار (flow)، و رضایت از کار تکراری.
ابزار GenAI اغلب روی تعریف اول قوی است. تعریف دوم به تست، Review، و کیفیت وابسته است. تعریف سوم در نظرسنجیها دیده میشود حتی وقتی متریک commit تغییر چشمگیری نشان ندهد. اگر فقط تعداد خطوط یا پیامهای چت را ببینید، خودتان را گمراه میکنید.
شواهد پژوهشی: چرا نتایج فرق میکنند؟
آزمایشهای GitHub روی وظایف مشخص
علاوه بر گزارشهای وبلاگ GitHub، مقالهٔ کنترلشدهٔ Peng و همکاران (arXiv:2302.06590) روی ۹۵ برنامهنویس نشان داد گروه با Copilot تسک استاندارد HTTP server را حدود ۵۵٫۸٪ سریعتر تمام کرد (فاصله اطمینان ۹۵٪ حدود ۲۱–۸۹٪). در ترکیب سه آزمایش میدانی Cui و همکاران روی حدود ۴٬۸۶۷ توسعهدهنده در Microsoft، Accenture و یک شرکت Fortune 100، افزایش حدود ۲۶٫۰۸٪ (SE حدود ۱۰٫۳٪) در شاخص کار هفتگی مرتبط با ابزار گزارش شد. این اعداد را به همهٔ کارها تعمیم ندهید؛ محدودهٔ تسک و متریک را بخوانید.
GitHub در پژوهشهای منتشرشدهٔ خود گزارش کرده که در یک آزمایش کنترلشده، توسعهدهندگانی که از Copilot استفاده میکردند وظیفهٔ مشخصی را بهطور معناداری سریعتر تمام کردند؛ همچنین در نظرسنجیها احساس حفظ flow و کاهش تلاش ذهنی روی کارهای تکراری گزارش شده است. پژوهشهای بعدی GitHub روی کیفیت نیز ادعا میکنند که در شرایط آزمایش، کارکردپذیری و برخی ابعاد کیفیت قابلاندازهگیری بهبود داشته است. نکتهٔ روششناختی: این نتایج به طراحی آزمایش، نوع وظیفه، و جمعیت شرکتکننده وابستهاند — نه حکم کلی برای هر مخزن production.
RCT منتشرشدهٔ METR روی کار واقعی مخزن
METR در مطالعهٔ early-2025 روی توسعهدهندگان باتجربهٔ متنباز که روی issueهای واقعی مخازن خود کار میکردند، گزارش کرد که وقتی استفاده از ابزارهای AI مجاز بود، زمان تکمیل نسبت به حالت بدون AI بیشتر شد؛ در حالی که خود توسعهدهندگان پیشبینی و حتی پسبرآورد سرعت بالاتر داشتند. این فاصلهٔ ادراک و اندازه، هشدار مدیریتی است: احساس سرعت را با زمان واقعی و کیفیت ادغام اشتباه نگیرید.
جمعبندی شواهد، نه انتخاب یک طرف
هیچکدام از این منابع را برای «اثبات همیشگی» یا «رد همیشگی» استفاده نکنید. الگوی مشترک این است: روی کار محدود و آشنا با معیار موفقیت روشن، شانس سود بیشتر است؛ روی کار پیچیده در زمینهٔ بزرگ با استاندارد سخت، هزینهٔ هماهنگی و اشتباه میتواند سود نوشتن را ببلعد.
شرایطی که احتمال سود واقعی بالاست
۱) کار تکراری با الگوی شناختهشده
تست واحد برای توابع خالص، boilerplate اسکیما، تبدیل فرمت، اسکلت CRUD، و بازنویسی لحن مستند داخلی. مدل در فضای پرتکرار آموزشدیده قویتر عمل میکند و شما سریعتر میتوانید درستی را بسنجید.
۲) مسئله قبل از پرامپت شکافته شده
اگر ورودی، خروجی، محدودیت و معیار پذیرش روشن باشد (مقالهٔ ۱۳۸)، مدل کمتر حدس میزند و شما کمتر دور باطل میزنید. پرامپت مبهم، تولید پرسرعتِ اشتباه میسازد.
۳) حلقهٔ بازخورد کوتاه
کامپایل، تست، typecheck، یا پیشنمایش UI در چند ثانیه. هر چه فاصلهٔ «پیشنهاد → شاهد» کوتاهتر باشد، مدل بیشتر شبیه شتابدهنده است تا منبع بدهی.
۴) Review ظرفیت دارد
اگر هر PR را کسی میخواند که دامنه را میشناسد، سرعت نوشتن به سرعت تحویل تبدیل میشود. اگر صف Review پر است، تولید بیشتر فقط صف را طولانیتر میکند.
۵) دامنه برای انسان آشنا است
وقتی شما میتوانید غلط را ببینید، AI کمک است. وقتی دامنه برای Reviewer هم جدید است، خطاهای مطمئننما خطرناکتر میشوند (مقالهٔ ۱۲۶ و ۱۳۹).
شرایطی که «سرعت» اغلب توهم است
- کار روی هستهٔ معماری ناشناخته بدون نقشه: مدل پر میکند؛ شما بعداً باز میکنید.
- تغییرات امنیتی، پرداخت، هویت، یا مهاجرت داده بدون تست هدفمند.
- Agent با دسترسی وسیع بدون حداقل دسترسی و شاهد میانی.
- فشردن سهمیهٔ «چند برابر PR» بدون معیار کیفیت و پایداری.
- استفاده روی کد مشتری/اسرار در ابزار نامناسب (مقالهٔ ۱۴۰) — سرعت کوتاهمدت، حادثهٔ بلندمدت.
نشانهٔ هشدار: زمان تا اولین Diff کم شده، اما زمان تا merge پایدار و تعداد rollback یا hotfix بالا رفته است.
جدول تصمیم: این کار را به AI بدهیم؟
| سؤال | اگر بله | اگر خیر |
|---|---|---|
| آیا معیار پذیرش در یک پاراگراف نوشته میشود؟ | شروع با AI مناسبتر است | اول مسئله را بشکنید |
| آیا در کمتر از چند دقیقه میتوانم غلط را ببینم؟ | حلقهٔ کوتاه؛ سود محتمل | اول harness تست/شاهد بسازید |
| آیا Reviewer دامنه را میشناسد؟ | میتوان تولید را افزایش داد | تولید بیشتر = ریسک پنهان |
| آیا کار تکراری/الگویی است؟ | اولویت بالا برای کمک AI | نقشه و طراحی انسانی اول |
| آیا شکست گران است؟ | AI فقط با verification سخت | بدون دروازه پیش نروید |
گلوگاه را جابهجا نکنید
در بسیاری از تیمها گلوگاه واقعی «تایپ کردن» نیست؛ فهم مسئله، هماهنگی، Review، و استقرار است. اگر AI فقط مرحلهٔ تایپ را متورم کند:
- حجم Diff بالا میرود و Review سطحی میشود.
- باگهای شبیه-درست دیرتر دیده میشوند.
- بدهی نامگذاری و تکرار الگو در مخزن پخش میشود.
- احساس شلوغی جایگزین پیشرفت واقعی میشود.
راهحل: سهمیهٔ تولید را با سهمیهٔ Review و تست همتراز کنید. مثلاً قبل از تولید انبوه، قرارداد تست دود و مالک Review را مشخص کنید. مقالهٔ ۱۲۹ و ۱۳۰ را به فرایند بچسبانید؛ نه به اسلاید.
متریکهای مفید در برابر متریکهای گمراهکننده
مفیدتر
- زمان چرخه از شروع کار تا merge پایدار.
- نسبت تغییرات برگشتی / hotfix مرتبط با PRهای AI-assisted.
- پوشش مسیرهای حساس با تست، نه فقط تعداد تست.
- زمان تا درک Diff توسط Reviewer (تقریبی با نظرسنجی کوتاه).
- کاهش کارهای تکراری خوداظهاری — در کنار متریک تحویل.
گمراهکنندهتر اگر تنها ملاک باشند
- تعداد خطوط تولیدشده یا قبولشده از پیشنهاد.
- تعداد پیام چت با مدل.
- تعداد PR بدون نگاه به اندازه و کیفیت.
- «حس سرعت» بدون نمونهٔ زمانی.
پذیرش پیشنهاد (acceptance rate) میتواند نشانهٔ سودمندی نسبی باشد، اما بهتنهایی کیفیت یا ارزش کسبوکار را ثابت نمیکند.
الگوی کاری که معمولاً سود میدهد
- مسئله را بنویسید: هدف، غیرهدف، محدودیت، مثال ورودی/خروجی.
- حداقل شاهد را آماده کنید: یک تست، یک اسکریپت دود، یا چکلیست دستی.
- از مدل پیشنویس بخواهید — نه تصمیم نهایی معماری.
- Diff را مثل کد شخص ثالث بخوانید؛ اسرار و PII را جداگانه چک کنید.
- شاهد را اجرا کنید؛ شکست را به پرامپت بعدی یا اصلاح دستی بدهید.
- فقط پس از Review ادغام کنید؛ الگوی شکست را در یادداشت تیم ثبت کنید.
این حلقه همان چیزی است که سرعت نوشتن را به سرعت تحویل وصل میکند. بدون گام ۱ و ۲، مدل جای خالی را با اعتماد پر میکند.
نقش تجربهٔ فرد و بلوغ مخزن
توسعهدهندهٔ تازهکار ممکن است روی boilerplate سود سریع ببیند، اما بدون Review قوی ریسک یادگیری غلط و کپی الگوی بد بالاست. توسعهدهندهٔ باتجربه روی مخزن آشنا ممکن است در کارهای ساده سود ببرد و در کارهای ظریف هسته، مدل را بیشتر برای پیشنهاد جایگزین یا توضیح بهکار بگیرد تا تولید کور. مخزن با تست و CI قوی، زمین حاصلخیزتری برای کمک AI است تا مخزن بدون شاهد.
پس «AI برای همه یکسان» غلط است. Onboarding ابزار باید با سطح فرد و سلامت مهندسی مخزن تنظیم شود.
مدیران: از شعار چندبرابری به فرضیهٔ قابلآزمایش
بهجای اعلام «از این ماه دو برابر خروجی»، یک فرضیه بنویسید: «روی کلاس کار X، با فرایند Review Y، چرخهٔ Z باید کوتاهتر شود بدون افزایش hotfix.» دو هفته اندازه بگیرید. اگر چرخه کوتاه نشد، ابزار را ملامت یا تقدیس نکنید؛ شرط را عوض کنید: آموزش مسئلهنویسی، قالب پرامپت، یا ظرفیت Review.
NIST در نمایهٔ Generative AI برای AI RMF بر مدیریت ریسکهایی مثل confabulation و اتکای نادرست تأکید دارد. بهرهوری سازمانی بدون مدیریت این ریسکها، فقط بدهی را جابهجا میکند.
اشتباههای رایج دربارهٔ بهرهوری AI
- معادل دانستن «پاسخ سریع» با «کار تمامشده».
- حذف تست چون مدل «مطمئن» نوشته است.
- اجبار همهٔ کارها به مسیر Agent وقتی مسئله هنوز مبهم است.
- نادیده گرفتن هزینهٔ زمینهٔ بزرگ و سوییچ مدل بدون ارزیابی.
- مقایسهٔ تیم با آمار بازاریابی بدون همان روششناسی.
نمونههای کوتاه
سود واضح
ساخت ۲۰ تست پارامتری برای تابع خالص با جدول ورودی آماده. مدل اسکلت را مینویسد؛ شما جدول و assertion را مالک میشوید؛ CI در کمتر از یک دقیقه جواب میدهد.
سود مشروط
پیادهسازی endpoint جدید روی الگوی موجود. اگر قرارداد API و تست قرارداد دارید، سرعت بالا میرود. اگر احراز هویت و مجوزها شکننده باشند، بدون Review امنیتی فقط بدهی میسازید.
زیان محتمل
«این ماژول قدیمی را با Agent بازنویسی کن» بدون تست طلایی و بدون مالک دامنه. Diff عظیم، Review خسته، و رفتارهای لبهای گمشده — کلاسیکِ سرعت دروغین.
ارتباط با مقالات سری
سوالات متداول
اگر فقط حس میکنم سریعتر شدهام کافی است؟
برای رفاه فردی مهم است، اما برای تصمیم سازمانی کافی نیست. حس را ثبت کنید و کنار زمان چرخه و کیفیت بگذارید. مطالعهٔ METR نشان داد ادراک میتواند با زمان اندازهگیریشده فاصله داشته باشد.
آیا باید آمار GitHub را روی تیم خود کپی کنیم؟
خیر بهعنوان هدف اجباری. آن اعداد در شرایط پژوهش خاص بهدست آمدهاند. از روش الهام بگیرید: وظیفهٔ مشخص، گروه مقایسه، و معیار از پیشتعریفشده — نه کپی کردن عدد روی اسلاید OKR.
Agent همیشه بهرهورتر از چت نیست؟
Agent وقتی شاهد میانی و دسترسی محدود دارد میتواند کارهای چندمرحلهای را جمع کند؛ وقتی بدون ترمز در مخزن میچرخد، هزینهٔ پاکسازی بالا میرود. انتخاب ابزار را به کلاس کار گره بزنید.
از کجا بفهمیم Review گلوگاه شده؟
صف PR طولانی، Reviewهای یکخطی روی Diffهای بزرگ، و افزایش نقص بعد از merge. در این حالت تولید بیشتر با AI را متوقف یا سهمیهبندی کنید تا ظرفیت Review برسد.
چکلیست هفتگی تیم
- کدام کلاس کارها این هفته با AI انجام شد؟
- کدامها واقعاً زودتر merge پایدار شدند؟
- کجا Diff بدون شاهد کافی ادغام شد؟
- آیا صف Review بدتر شد؟
- یک الگوی شکست را به قالب پرامپت یا تست تبدیل کردیم؟
جمعبندی برای فرد و Tech Lead
اگر فردید: AI را روی کارهای الگویی با شاهد کوتاه به کار بگیرید؛ برای هستهٔ حساس، اول بفهمید بعد بخواهید. اگر Tech Leadید: ابزار را با فرضیه و متریک چرخه مدیریت کنید، ظرفیت Review را همزمان بسازید، و از شعار چندبرابری بدون تعریف بهرهوری بپرهیزید. امنیت داده (۱۴۰) و verification (۱۳۹) بخشی از بهرهوریاند؛ چون یک حادثه میتواند ماهها «سرعت» را پاک کند.
بهرهوری فردی در برابر بهرهوری سیستم
ممکن است یک مهندس سریعتر پیشنهاد بگیرد، اما صف Review، محیط شکننده، یا نبود تست، گلوگاه سیستم را جابهجا کند نه حذف. در نتیجه زمان چرخهٔ سراسری ثابت میماند و فقط WIP زیاد میشود. قبل از جشن گرفتن Accept rate، به زمان چرخهٔ end-to-end و نرخ برگشت از QA نگاه کنید.
مدیران خوب سؤال میکنند: آیا کار بیشتری به دست مشتری رسید یا فقط شاخههای بیشتری باز شد؟ مطالعات میدانی روی PR مفیدند چون به خروجی جریان نزدیکترند؛ با این حال کیفیت ادغام و ارزش محصول را جداگانه بسنجید.
نقش آموزش و پذیرش
در آزمایشهای میدانی، نرخ پذیرش ابزار بین شرکتها فرق داشت و آموزش میتوانست شروع را سریعتر کند. ابزار بدون عادت تیمی مثل IDE نصبشدهٔ بلااستفاده است. بودجهٔ آموزش را بخشی از هزینهٔ مالکیت بدانید نه هزینهٔ اختیاری.
آموزش مؤثر کوتاه است: سه سناریوی واقعی تیم، دو ضدالگو، و یک قالب پرامپت. دورهٔ طولانی تئوری کمتر از تمرین روی باگ واقعی اثر دارد.
هزینهٔ پنهان: بازکاری، مجوز، و پراکندگی ابزار
- بازکاری روی پیشنهادهای نادرست یا ناامن.
- زمان مقایسهٔ چند ابزار همزمان بدون استاندارد.
- هزینهٔ مجوز و سایهٔ حسابهای شخصی.
- سربار امنیتی و حقوقی برای داده.
ROI را فقط با سرعت کدنویسی حساب نکنید. تفاضل زمان ذخیرهشده منهای بازکاری و حوادث، به حقیقت نزدیکتر است. اگر عددی برای حوادث ندارید، حداقل یک سقف ریسک کیفی در پایلوت بگذارید.
چه چیزی را نباید از مطالعات موجود نتیجهگیری کرد
نباید نتیجه گرفت که همهٔ نقشها همان درصد را میبینند، که کیفیت خودکار بهتر میشود، یا که Agentهای خودمختار همان اثر Copilot را دارند. مطالعات یادشده عمدتاً روی پیشنهاد کد در جریان توسعهاند. برای خلاصهسازی دانش یا پشتیبانی مشتری، آزمایش جدا طراحی کنید.
همچنین نباید عدد را برای همیشه ثابت فرض کرد. مدلها، قیمت، و عادت تیم عوض میشوند؛ متریک را دورهای بازسنجید.
اتصال به استراتژی AI-first
مقالهٔ ۱۳۵ دربارهٔ AI-first در برابر توسعه سنتی است. بهرهوری واقعی معمولاً در میانه است: جریان سنتی با نقاط اتوماسیون انتخابی، نه شعار جایگزینی کامل و نه رد کردن ابزار. وقتی Use Caseها بالغ شدند، میتوانید دامنه را گستردهتر کنید.
اگر استراتژی فقط «همه باید از AI استفاده کنند» باشد بدون مسئله و متریک، هیاهو بر اتوماسیون میچربد.
خلاصه
AI وقتی بهرهوری را بالا میبرد که مسئله روشن، کار تا حدی الگویی، حلقهٔ شاهد کوتاه، و Review واقعی باشد. پژوهشهای GitHub سود روی وظایف مشخص را نشان دادهاند؛ مطالعهٔ METR یادآوری میکند که در کار واقعی مخزن، ادراک سرعت همیشه با زمان تکمیل یکی نیست. بهرهوری را با ارزش تحویلشده اندازه بگیرید — نه با حجم تولید مدل.
منابع و مراجع
- Peng et al. — The Impact of AI on Developer Productivity: Evidence from GitHub Copilot — https://arxiv.org/abs/2302.06590
- Cui et al. — The Effects of Generative AI on High-Skilled Work (field experiments) — https://doi.org/10.1287/mnsc.2025.00535
- GitHub Blog — Research: quantifying GitHub Copilot’s impact on developer productivity and happiness — https://github.blog/news-insights/research/research-quantifying-github-copilots-impact-on-developer-productivity-and-happiness/
- GitHub Blog — Research: Quantifying GitHub Copilot’s impact in the enterprise with Accenture — https://github.blog/news-insights/research/research-quantifying-github-copilots-impact-in-the-enterprise-with-accenture/
- GitHub Blog — Does GitHub Copilot improve code quality? Here’s what the data says — https://github.blog/news-insights/research/does-github-copilot-improve-code-quality-heres-what-the-data-says/
- METR — Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity — https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- NIST — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1) — https://doi.org/10.6028/NIST.AI.600-1
- OWASP — Top 10 for Large Language Model Applications (project hub) — https://owasp.org/www-project-top-10-for-large-language-model-applications/
نویسنده
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
اگر در انتخاب معماری یا مسیر توسعه مطمئن نیستید، میتوانید درباره پروژه صحبت کنیم.
مسئله و محدودیت را بنویسید. اگر تطابق داشته باشیم، برای گفتگو هماهنگ میکنیم.