رفع مشکل ایندکس سایت: sitemap، canonical و robots.txt
7 دقیقه مطالعه
راهنمای رفع مشکل ایندکس: نقش robots.txt، noindex، canonical و sitemap، تعارضهای رایج و ترتیب عیبیابی بر پایهٔ مستندات رسمی Google.
«صفحهام ایندکس نمیشود» یا «Google صفحهٔ اشتباه را نشان میدهد» از رایجترین مشکلهای سایتهای شرکتی است و اغلب ریشهاش یک سوءتفاهم بین سه ابزار است: sitemap، canonical و robots.txt. هر کدام کار متفاوتی میکنند و ترکیب نادرستشان یکدیگر را خنثی میکند. این مقاله بر پایهٔ مستندات رسمی Google Search Central (خواندهشده ۱۹ اکتبر ۲۰۲۶) نقش هر ابزار، تعارضهای رایج و روش عیبیابی را شرح میدهد. درخت تصمیم و ترتیب عیبیابی جمعبندی نویسنده است و تضمین ایندکس نمیدهد؛ حتی راهنمای رسمی میگوید sitemap ایندکس شدن همهٔ URLها را تضمین نمیکند. برای تصویر کلی سئو SEO در سال ۲۰۲۶ را ببینید.
نقش هر ابزار
| ابزار | کار اصلی | کاری که نمیکند |
|---|---|---|
| robots.txt | مدیریت ترافیک خزش: کدام URLها خزیده شوند | از نتایج حذف نمیکند |
| noindex | حذف صفحه از نتایج Google وقتی خزنده آن را ببیند | خزش را متوقف نمیکند و با robots.txt بستهشده کار نمیکند |
| canonical | انتخاب URL ترجیحی بین نسخههای تکراری یا مشابه | الزامآور نیست؛ سیگنال است |
| sitemap | معرفی URLهایی که مهم میدانید و زمان بهروزرسانی | تضمین خزش یا ایندکس نمیدهد |
robots.txt: خزش، نه حذف
راهنمای رسمی میگوید robots.txt عمدتاً برای پرهیز از فشار بیش از حد به سرور است و راهی برای دور نگهداشتن صفحه از Google نیست. صفحهٔ مسدودشده با robots.txt ممکن است همچنان در نتایج ظاهر شود (بدون توضیح) اگر صفحههای دیگر به آن لینک بدهند. برای حذف از نتایج باید از noindex یا رمز استفاده کرد. همچنین این فایل الزامآور نیست؛ خزندههای محترم از آن پیروی میکنند ولی همه چنین نیستند. نکتهٔ فنی مهم: مسدودکردن فایلهای ضروری رندر (مثل script و style) ممکن است باعث شود Google صفحه را درست نفهمد.
noindex و تعارض با robots.txt
noindex با meta robots یا هدر X-Robots-Tag پیاده میشود و پس از خزش، صفحه را کامل از نتایج حذف میکند. اما راهنما تأکید میکند: صفحه نباید با robots.txt مسدود باشد، وگرنه خزنده قاعدهٔ noindex را نمیبیند. noindex داخل خود robots.txt پشتیبانی نمیشود. پس خطای کلاسیک این است: مدیر سایت برای حذف صفحه هم noindex میگذارد و هم آن را در robots.txt مسدود میکند؛ نتیجه برعکس میشود. همچنین بعد از افزودن noindex ممکن است تا بازدید مجدد Googlebot مدتی طول بکشد (راهنما از احتمال ماهها برای صفحههای کماهمیت میگوید) و برای بررسی میتوان از URL Inspection و گزارش Page Indexing استفاده کرد.
canonical: انتخاب نسخهٔ ترجیحی
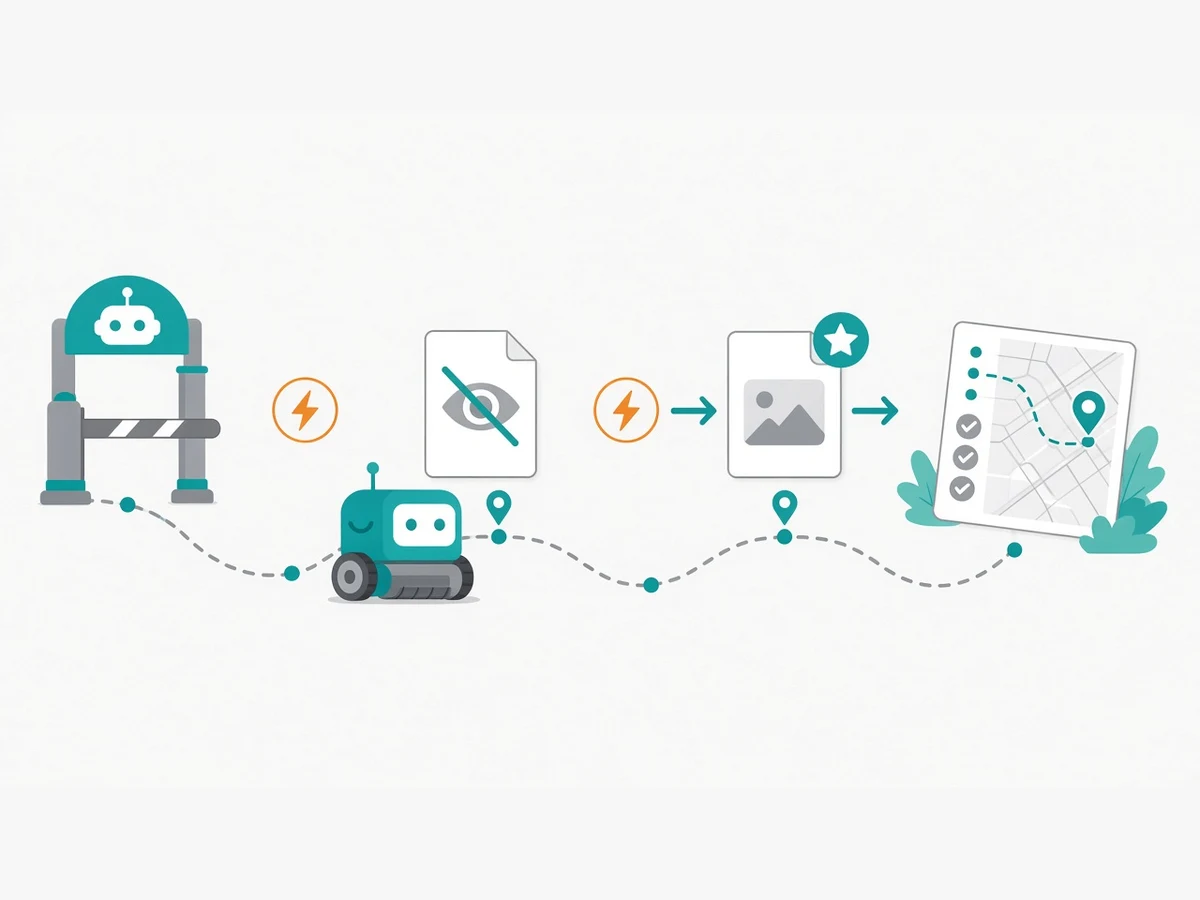
راهنما سه روش را به ترتیب قدرت میآورد: ریدایرکت (سیگنال قوی)، rel="canonical" (سیگنال قوی) و قرار دادن در sitemap (سیگنال ضعیف). روشها قابل ترکیباند و ترکیبشان شانس انتخاب URL ترجیحی را بیشتر میکند. هیچکدام اجباری نیست و اگر مشخص نکنید Google خودش بهترین نسخه را انتخاب میکند. نکات عملی از راهنما:
- برای canonical از robots.txt استفاده نکنید.
- برای یک صفحه در sitemap یک URL و در rel=canonical URL دیگری نگذارید.
- روی خود صفحهٔ اصلی canonical خودارجاع بگذارید.
- از URL مطلق استفاده کنید و تکه (fragment) را canonical نکنید.
- برای کنار گذاشتن نسخهٔ تکراری در همان سایت noindex توصیه نمیشود، چون صفحه را کامل از نتایج حذف میکند؛ rel=canonical روش ترجیحی است.
- در سایت با رندر سمت کلاینت، canonical را در HTML منبع بگذارید و جاوااسکریپت آن را تغییر ندهد.
- در لینکدهی داخلی به URL canonical لینک بدهید.
Google در حالت پیشفرض HTTPS را ترجیح میدهد، مگر گواهی نامعتبر، وابستگی ناامن، ریدایرکت از HTTPS به HTTP یا canonical به نسخهٔ HTTP وجود داشته باشد.
sitemap: فهرست آنچه مهم میدانید
sitemap به کشف URLها کمک میکند ولی راهنما میگوید همهٔ موارد آن خزیده یا ایندکس نمیشوند. سایت کوچک (حدود ۵۰۰ صفحهٔ مهم یا کمتر) که لینکدهی داخلی کامل دارد شاید به آن نیاز نداشته باشد؛ سایت بزرگ، جدید یا رسانهمحور بیشتر نیاز دارد. همه URLهای داخل sitemap بهعنوان پیشنهاد canonical دیده میشوند؛ پس URLهای noindex، ریدایرکتشده یا غیر canonical را در آن نگذارید. این جمعبندی منطقی از قاعدهٔ «همهٔ URLهای sitemap پیشنهاد canonicalاند» است.
ترتیب عیبیابی (پیشنهاد نویسنده)
- URL را با URL Inspection بررسی کنید: آخرین خزش، HTML دریافتی و وضعیت ایندکس.
- پاسخ HTTP: آیا ۲۰۰ است؟ ریدایرکت یا خطا نیست؟
- robots.txt: آیا URL مسدود است؟ اگر هست و میخواهید ایندکس شود، مسدودسازی را بردارید.
- noindex: در meta و هدر X-Robots-Tag هست؟ عمدی است؟
- canonical: به خودش اشاره میکند یا به URL دیگر؟ با sitemap هماهنگ است؟
- لینک داخلی و sitemap: آیا صفحه لینک ورودی دارد و در sitemap است؟
- محتوا: آیا صفحه واقعاً چیز تازهای نسبت به صفحهٔ مشابه دارد؟
هر مرحله پاسخ مشخصی دارد؛ به مرحلهٔ بعد وقتی بروید که مرحلهٔ قبل را رد کردهاید.
مثال ساختگی
سایت فرضی صفحهٔ «/guide» را noindex کرده بود و برای اطمینان آن را در robots.txt هم مسدود کرد. صفحه هنوز در نتایج دیده میشد، بدون توضیح. تیم مسدودسازی را برداشت تا Googlebot بتواند noindex را ببیند. در مثال دیگر، دو نسخهٔ HTTP و HTTPS هر دو در sitemap بودند؛ تیم فقط نسخهٔ HTTPS را در sitemap نگه داشت و ریدایرکت دائمی گذاشت. این مثالها ساختگیاند و نتیجهٔ زماندار تضمین نمیکنند.
اشتباهات رایج
- استفاده از robots.txt برای حذف صفحه از نتایج.
- noindex همراه با مسدودسازی robots.txt.
- نوشتن noindex داخل robots.txt.
- URLهای متضاد در sitemap و canonical.
- URLهای ریدایرکت یا noindex در sitemap.
- canonical نسبی یا تغییر canonical با جاوااسکریپت.
- انتظار ایندکس فوری یا تضمینشده پس از ارسال sitemap.
سناریوهای رایج و تصمیم
برای اینکه جدول نقشها به تصمیم تبدیل شود، چند سناریوی رایج را مرور کنید. اینها تفسیر نویسندهاند و بر اصول بالا تکیه دارند.
- صفحهای که نباید در نتایج باشد، مثل صفحهٔ تشکر یا پیشنمایش: noindex بگذارید و مطمئن شوید خزش آن مسدود نیست. اگر محتوا واقعاً خصوصی است، رمز یا کنترل دسترسی لازم است، نه فقط noindex یا robots.txt.
- دو آدرس با محتوای یکسان، مثل نسخه با پارامتر پیگیری و بدون آن: canonical به نسخهٔ ترجیحی و لینکدهی داخلی به همان نسخه؛ اگر نسخهٔ تکراری باید برچیده شود، ریدایرکت دائمی.
- بخش بزرگی از سایت که ارزش جستوجو ندارد و فشار خزش ایجاد میکند: مدیریت با robots.txt منطقی است، به شرط اینکه منابع لازم رندر مسدود نشوند و توجه داشته باشید که این روش حذف از نتایج نیست.
- صفحهٔ جدید که پس از چند روز دیده نشده: ابتدا لینک داخلی و حضور در sitemap، سپس URL Inspection؛ ایندکس زمانبر است و ثابتبودن زمان وعده داده نمیشود.
- مهاجرت دامنه یا ساختار URL: ریدایرکت دائمی از آدرس قدیم به جدید، بهروزرسانی canonical و sitemap و لینکهای داخلی، و پایش گزارشها بعد از مهاجرت.
یک قاعدهٔ ساده برای همهٔ سناریوها: هر سه سیگنال (لینک داخلی، canonical، sitemap) باید به همان URL اشاره کنند. تعارض بین آنها منبع بیشتر مشکلهای ایندکس است. پس از اصلاح، تغییر را با تاریخ ثبت کنید تا اگر وضعیت عوض شد بتوانید رابطهٔ زمانی را ببینید.
چکلیست
- robots.txt فقط برای مدیریت خزش استفاده میشود، نه حذف از نتایج.
- صفحههای noindex در robots.txt مسدود نیستند.
- هر صفحهٔ مهم canonical خودارجاع و مطلق دارد.
- sitemap فقط URLهای canonical و قابل ایندکس را دارد.
- لینکهای داخلی به URL canonical اشاره میکنند.
- عیبیابی با URL Inspection و گزارش Page Indexing انجام میشود.
منابع و مراجع
- Robots.txt Introduction and Guide — Google Search Central، 2026-10-19.
- Block Search indexing with noindex — Google Search Central، 2026-10-19.
- How to specify a canonical URL with rel="canonical" and other methods — Google Search Central، 2026-10-19.
- Learn about sitemaps — Google Search Central، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.