دیتابیس چیست؟ راهنمای ساده پایگاه داده برای افراد فنی و غیرفنی
دیتابیس (پایگاه داده) چیست، چرا اپلیکیشن به منبع حقیقت نیاز دارد، و تفاوت persistence با فایل و spreadsheet — با مثال فروشگاه Users/Products/Orders/Payments.
سا
12 دقیقه مطالعهسهیل ابراهیمپور
بنیانگذار و مهندس محصول
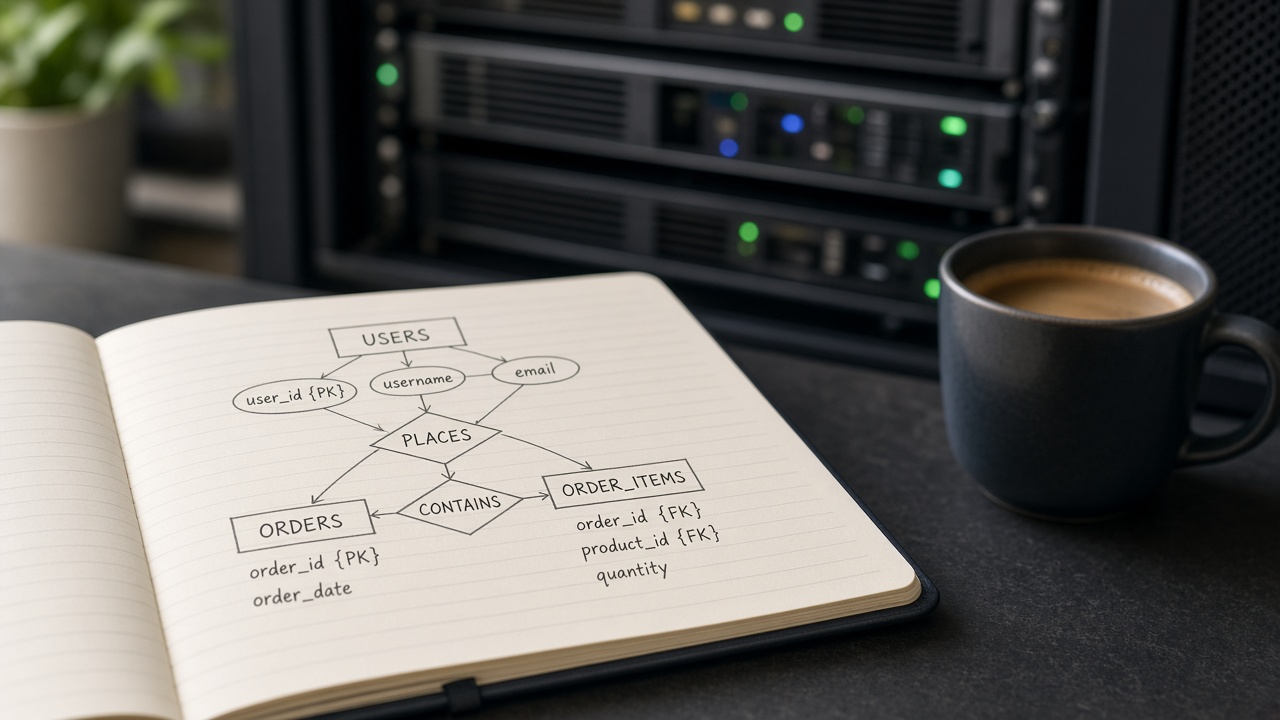
وقتی یک فروشگاه آنلاین سفارش میگیرد، اطلاعات باید جایی بماند که بعد از بستن مرورگر، ریاستارت سرور، یا حتی خرابی موقت برنامه، دوباره قابلاعتماد باشد. آن «جا» معمولاً دیتابیس (Database) یا همان پایگاه داده است — مجموعهای ساختیافته از داده بههمراه نرمافزاری که اضافه، خواندن، بهروزرسانی و حذف را کنترل میکند.
این متن برای مخاطب ترکیبی نوشته شده: مالک کسبوکار که میخواهد بداند چرا تیم فنی مدام از «دیتابیس» حرف میزند، مدیر محصول که باید بین spreadsheet موقت و معماری پایدار تمایز بگذارد، و برنامهنویس تازهکار که هنوز تفاوت فایل، حافظهٔ RAM و پایگاه داده را روشن نکرده است. هدف، رتبهبندی «بهترین دیتابیس» نیست؛ فهمیدن نقش پایگاه داده بهعنوان منبع حقیقت (source of truth) است.
تعاریف مفهومی را از مستندات رسمی موتورهایی مثل PostgreSQL، MySQL و SQLite میگیریم — چون هر سه صریحاً میگویند پایگاه داده مجموعهای ساختیافته از داده است و برای کار با آن به سامانهٔ مدیریت پایگاه داده (DBMS) نیاز دارید.
پاسخ کوتاه
دیتابیس یک مخزن ساختیافته برای داده است که برنامه بتواند آن را با قواعد مشخص ذخیره، جستوجو و تغییر دهد؛ و بعد از خاموش شدن برنامه همچنان در دسترس بماند (persistence).
- فایل یا spreadsheet برای شروع یا گزارش دستی مفیدند؛ برای همزمانی کاربران، یکپارچگی سفارش/پرداخت و منبع حقیقت اپلیکیشن معمولاً کافی نیستند.
- در یک فروشگاه، Users، Products، Orders و Payments هر کدام ساختار و چرخهٔ عمر متفاوت دارند؛ جدا کردنشان اشتباه نیست — طراحی است.
- DBMS (مثل PostgreSQL، MySQL، SQLite) قوانین، تراکنش، ایندکس و دسترسی را مدیریت میکند؛ خودِ «دادهٔ خام روی دیسک» بهتنهایی کافی نیست.
اپلیکیشن بدون منبع حقیقت پایدار، هر بار که ریستارت شود یا دو کاربر همزمان بنویسند، داستان متفاوتی از واقعیت میسازد.
دیتابیس دقیقاً چه چیزی است؟
طبق مستند MySQL، پایگاه داده یک مجموعهٔ ساختیافته از داده است — از یک فهرست خرید ساده تا گالری تصویر یا اطلاعات عظیم سازمانی. برای افزودن، دسترسی و پردازش آن داده روی رایانه، به یک سامانهٔ مدیریت پایگاه داده مثل MySQL Server نیاز دارید. همان صفحه تأکید میکند رایانه در مدیریت حجم زیاد داده قوی است؛ به همین دلیل DBMS در مرکز بسیاری از سیستمها قرار میگیرد.
PostgreSQL خود را یک object-relational DBMS معرفی میکند که بخش بزرگی از استاندارد SQL را پشتیبانی میکند و قابلیتهایی مثل پرسوجوی پیچیده، کلید خارجی، تریگر، یکپارچگی تراکنشی و کنترل همزمانی چندنسخهای دارد. SQLite هم خودش را موتور SQL تراکنشی، خودکفا و بدون سرور جداگانه توصیف میکند که یک پایگاه کامل را داخل یک فایل دیسک نگه میدارد — و صریحاً میگوید فکر کنید جایگزین fopen است نه جایگزین Oracle.
جمع این سه تعریف رسمی یک تصویر مشترک میسازد: داده ساختیافته است؛ موتور مدیریتی وجود دارد؛ و هدف، ذخیره و بازیابی قابلاعتماد است — نه فقط «ریختن متن در یک پوشه».
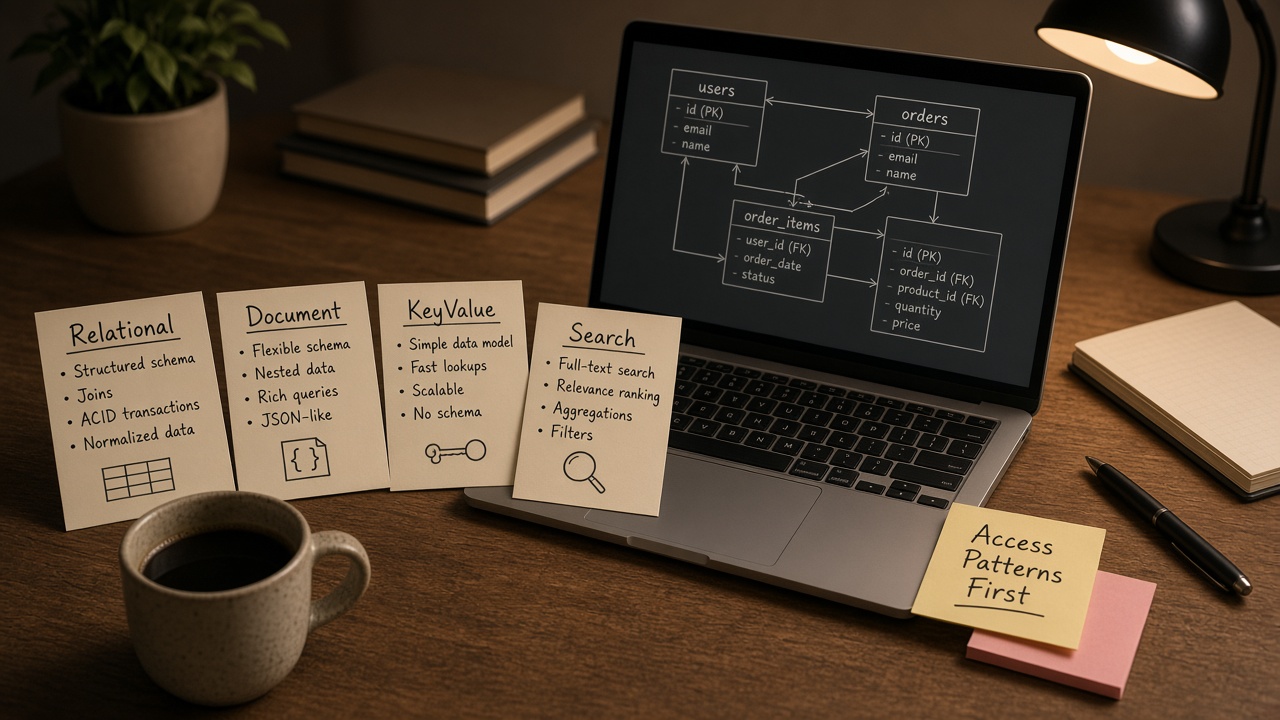
مثال فروشگاه: Users، Products، Orders، Payments
فرض کنید یک فروشگاه کوچک آنلاین دارید. اگر همه چیز را در یک جدول غولپیکر اکسل بریزید — نام مشتری کنار نام کالا کنار مبلغ پرداخت کنار وضعیت ارسال — خیلی زود با تکرار، تناقض و ترس از «کدام ردیف درست است؟» روبهرو میشوید. جدا کردن موجودیتها به همین دلیل است.
Users (کاربران)
کاربر هویت پایدار دارد: ایمیل، رمز هششده، نشانی، تاریخ عضویت. این داده بارها خوانده میشود، کمتر عوض میشود، و نباید با هر سفارش کپی تکراری بسازد. اگر نشانی عوض شد، باید یک جا بهروز شود تا همهٔ سفارشهای بعدی درست ببینند — نه ده ردیف پراکنده.
Products (محصولات)
محصول قیمت، موجودی، شرح و دسته دارد. موجودی با هر فروش کم میشود؛ قیمت ممکن است تغییر کند بدون اینکه تاریخچهٔ سفارشهای قبلی خراب شود. ساختار محصول با ساختار کاربر یکی نیست: یکی موجودیت کاتالوگ است، دیگری هویت انسان.
Orders (سفارشها)
سفارش پیوند بین کاربر و اقلام است: چه کسی، چه چیزی، چند عدد، در چه زمانی، با چه وضعیتی. سفارش یک رویداد کسبوکار است؛ نباید با ویرایش بعدی قیمت کاتالوگ بازنویسی شود. معمولاً اسنپشات قیمت در لحظهٔ خرید نگه داشته میشود.
Payments (پرداختها)
پرداخت چرخهٔ خودش را دارد: در انتظار، موفق، ناموفق، بازگشت وجه. ممکن است برای یک سفارش چند تلاش پرداخت ثبت شود. مخلوط کردن وضعیت پرداخت داخل همان سلول «توضیحات سفارش» در spreadsheet دقیقاً جایی است که حسابداری و پشتیبانی از هم جدا میشوند.
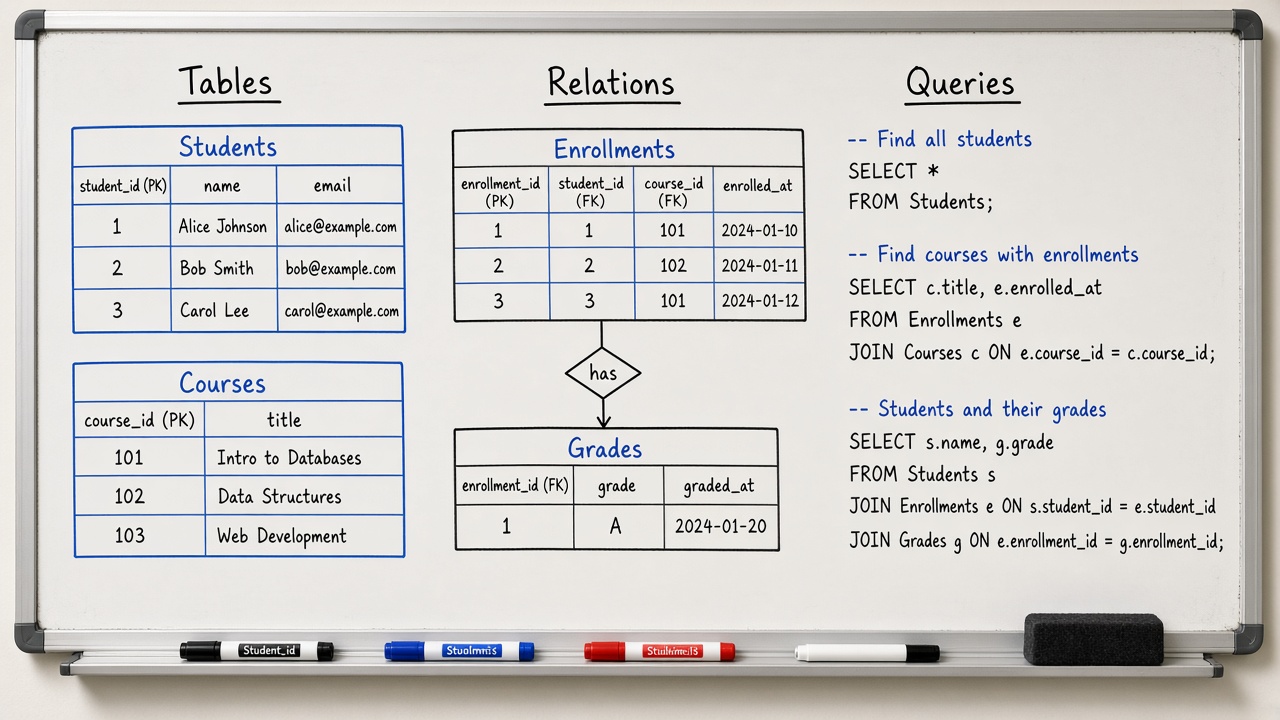
MySQL در بخش رابطهای بودن توضیح میدهد داده در جدولهای جدا ذخیره میشود نه در یک انبار بزرگ واحد؛ و قواعد رابطه (یکبهیک، یکبهچند، یکتا بودن و مانند آن) را خود پایگاه enforce میکند تا برنامه دادهٔ ناسازگار، یتیم یا تکراری نبیند. مثال فروشگاه همان ایده را به زبان کسبوکار میگوید.
| موجودیت | چرا ساختار جدا میخواهد | اگر قاطی شود چه میشود |
|---|---|---|
| Users | هویت و دسترسی؛ یک منبع برای پروفایل | ایمیل تکراری، نشانی متناقض بین سفارشها |
| Products | کاتالوگ و موجودی؛ تغییر قیمت بدون خراب کردن تاریخچه | موجودی منفی یا قیمت اشتباه روی فاکتور قدیم |
| Orders | رویداد خرید و وضعیت ارسال | نمیدانید سفارش مال کدام کاربر است |
| Payments | وضعیت مالی جدا از لجستیک | پول گرفتهاید ولی سیستم «پرداخت نشده» نشان میدهد |
Persistence: ماندگاری در برابر حافظهٔ موقت
برنامه وقتی اجرا میشود، بخش زیادی از حالتش در RAM است. RAM سریع است و با قطع برق یا ریاستارت از بین میرود. Persistence یعنی داده بعد از پایان فرایند برنامه روی ذخیرهساز پایدار (دیسک و مشابه آن) بماند تا اجرای بعدی همان حقیقت را ببیند.
SQLite در About خودش تأکید میکند تراکنشهای ACID دارد — حتی بعد از قطع برق — و فرمت فایل پایدار و بادوام است. PostgreSQL هم یکپارچگی تراکنشی را جزو قابلیتهای اصلی میآورد. این زبان رسمی همان چیزی است که در محصول بهصورت «سفارش ثبتشده نباید با کرش سرور غیب شود» حس میشود.
بدون persistence، سبد خرید، موجودی و پرداخت فقط تا وقتی سرور زنده است معنا دارند. برای دموی یکروزه شاید قابلتحمل باشد؛ برای کسبوکار واقعی نه.
دیتابیس در برابر فایل معمولی
میتوانید سفارشها را در فایلهای JSON یا CSV بنویسید. برای ابزار کوچک تککاربره گاهی کافی است. مشکل از جایی شروع میشود که:
- دو درخواست همزمان یک فایل را مینویسند و یکی دیگری را خراب میکند.
- برای پیدا کردن «همهٔ سفارشهای کاربر ۱۲۳ در ماه قبل» باید کل فایل را بخوانید.
- قواعدی مثل «مبلغ پرداخت نباید منفی باشد» فقط در کد پراکندهاند و یک مسیر فراموششده آنها را دور میزند.
- پشتیبانگیری سازگار در میانهٔ نوشتن سخت میشود.
SQLite جملهٔ معروفی دارد: آن را جایگزین fopen ببینید. یعنی حتی وقتی «فقط یک فایل» میخواهید، موتور پایگاه میتواند ایندکس، تراکنش و SQL بدهد و از بسیاری از دردسرهای I/O خام جلو بزند. فایل خام بد نیست؛ برای همزمانی و پرسوجو معمولاً ناقص است.
دیتابیس در برابر spreadsheet
Spreadsheet عالی است برای تحلیل دستی، بودجهبندی و اشتراکگذاری سریع با غیرفنیها. ضعفش وقتی معلوم میشود که همان شیت را بهعنوان backend محصول قرار میدهید:
- کنترل دسترسی ردیفبهستون برای هزار کاربر وب طراحی نشده است.
- تاریخچهٔ دقیق تغییر و حسابرسی سختتر از DBMS بالغ است.
- ارجاع بین شیتها بهاندازهٔ کلید خارجی و تراکنش، یکپارچگی را تضمین نمیکند.
- اتوماسیون APIمحور روی spreadsheet ممکن است، ولی معمولاً محدودیت نرخ، قفل و شکنندگی دارد.
قاعدهٔ عملی: spreadsheet را برای تصمیم انسانی و گزارش موقت نگه دارید؛ منبع حقیقت اپلیکیشن آنلاین را روی دیتابیس بگذارید. اگر تیم فقط با شیت زندگی میکند، حداقل بدانید چه زمانی باید مهاجرت کنید — معمولاً با اولین پرداخت واقعی یا اولین کاربر همزمان.
چرا اپلیکیشن به منبع حقیقت (source of truth) نیاز دارد؟
در سیستمهای واقعی داده در چند جا کپی میشود: کش، لاگ، ایندکس جستوجو، انبار داده، پیام در صف. اگر همهٔ اینها خود را «حقیقت نهایی» بدانند، بهمحض اختلاف نمیدانید کدام را اصلاح کنید. Source of truth همان جایی است که در اختلاف، بقیه باید خود را با آن همتراز کنند.
برای فروشگاه، معمولاً پایگاه سفارش/پرداخت همان مرجع است: اگر کش گفت موجودی ۱۰ و دیتابیس گفت ۰، باید موجودی دیتابیس را باور کنید و کش را تازه کنید — نه برعکس. گزارشگیری، حسابرسی مالی و پشتیبانی مشتری همه به یک روایت پایدار وابستهاند.
DBMS با تراکنش کمک میکند چند تغییر مرتبط با هم commit یا rollback شوند. مثال کلاسیک: کم کردن موجودی و ثبت سفارش باید با هم موفق شوند یا با هم بیاثر؛ نیمهکاره رها شدن یعنی کالا فروختهشده بدون سفارش، یا سفارش بدون کاهش موجودی.
DBMS چه کارهایی از دوش برنامه برمیدارد؟
برنامه میتواند همه چیز را خودش در فایل پیاده کند؛ ولی DBMS معمولاً این لایهها را آماده دارد:
- مدل منطقی: جدول/سند/کلید و رابطه.
- ایندکس برای جستوجوی سریعتر روی فیلدهای پرتکرار.
- کنترل همزمانی تا خواندن/نوشتن موازی همدیگر را خراب نکنند.
- پشتیبانگیری و بازیابی در سطح موتور.
- امنیت دسترسی در سطح کاربر/نقش (بسته به محصول).
- زبان پرسوجو — در خانوادهٔ رابطهای معمولاً SQL.
PostgreSQL فهرست قابلیتهایی مثل foreign keys، views قابلبهروزرسانی و گسترشپذیری با نوعداده و تابع جدید را برجسته میکند. MySQL روی مدل رابطهای، سرعت و نقش مرکزی DBMS در کاربردها تأکید دارد. SQLite روی تعبیهشدن داخل فرایند، صفرپیکربندی و استقرار میلیاردی تمرکز میکند. انتخاب بین آنها موضوع مقالهٔ انواع و انتخاب است؛ اینجا کافی است بفهمید «دیتابیس» فقط پوشهٔ داده نیست.
چه چیزهایی دیتابیس نیستند — ولی با آن اشتباه گرفته میشوند؟
- کش (Cache): برای سرعت؛ میتواند عمداً کهنه یا قابلحذف باشد.
- صف پیام: برای انتقال رویداد؛ آرشیو بلندمدت کسبوکار نیست مگر طراحی جداگانه.
- لاگ فایل: برای عیبیابی؛ مدل پرسوجوی کسبوکار ندارد.
- جستوجوی متن کامل جداگانه: عالی برای پیدا کردن؛ لزوماً سیستم ثبت سفارش نیست.
اشتباه رایج محصول این است که چون Redis یا لایهٔ جستوجو سریع است، همان را منبع حقیقت مالی کنند. سرعت جایگزین یکپارچگی نمیشود؛ مکمل آن است.
نشانههایی که وقت جدی گرفتن دیتابیس رسیده
- بیش از یک نفر همزمان داده وارد میکند.
- پول، موجودی، نوبت، یا دسترسی کاربر در میان است.
- باید بگویید «هفتهٔ پیش دقیقاً چه اتفاقی افتاد».
- گزارشها با دادهٔ عملیاتی اختلاف دارند و کسی نمیداند کدام درست است.
- پشتیبانگیری دستی فایلها را فراموش میکنید یا نمیتوانید restore را تمرین کنید.
اگر هنوز در مرحلهٔ ایده روی کاغذید، حتی SQLite توکار میتواند عادت مدلسازی را زود Reminder کند بدون اینکه زیرساخت سنگین بخواهید. مهم این است که موجودیتها و منبع حقیقت را از روز اول نامگذاری کنید.
تراکنش به زبان غیرفنی
تراکنش یعنی چند تغییر مرتبط را بهصورت یک بستهٔ «یا همه یا هیچ» اعمال کنید. در پرداخت فروشگاه: ثبت ردیف Payment موفق، کم کردن موجودی Product، و بهروز کردن وضعیت Order باید با هم دیده شوند. اگر سرور بین مرحلهٔ دوم و سوم خاموش شود، DBMS سالم بسته را rollback میکند تا دنیا نیمهکاره نماند.
PostgreSQL یکپارچگی تراکنشی را در فهرست قابلیتهای اصلیاش میآورد؛ SQLite هم ACID را حتی پس از قطع برق وعده میدهد. برای مالک محصول، ترجمه ساده است: کمتر شدن سفارشهای شبح و موجودیهای دروغین.
بدون تراکنش، تیم مجبور میشود جبرانیهای دستی بنویسد — اسکریپتهای «اگر سفارش بدون پرداخت ماند، فلان کن» — که خود منبع باگ و هزینهٔ پشتیبانی میشوند.
مدل ذهنی برای جلسه با تیم فنی
اگر غیرفنی هستید و با تیم فنی جلسه دارید، این سه سؤال گفتوگو را از شعار به تصمیم میبرد:
- منبع حقیقت سفارش و پرداخت کجاست و اگر کش با آن اختلاف داشت کدام برنده است؟
- برای Users/Products/Orders/Payments چه قیودی در خود دیتابیس enforce میشود؟
- پشتیبانگیری و تمرین restore آخرین بار کی انجام شده؟
اگر جوابها مبهم بود، مشکل لزوماً «موتور غلط» نیست؛ مشکل شفاف نبودن مرز persistence و مسئولیت داده است. اول مرز را بکشید، بعد برند را انتخاب کنید.
برای توسعهدهندهٔ جونیور هم همین مدل مفید است: قبل از انتخاب ORM یا فریمورک، موجودیتها و چرخهٔ عمرشان را روی کاغذ بکشید. بسیاری از باگهای بعدی از درهمریختن Order و Payment در یک جدول عجولانه میآید.
مسیر یادگیری کوتاه بعد از این مقاله
اگر مفهوم را گرفتید، ترتیب پیشنهادی مطالعه در همین سری این است: انواع پایگاه را در ۰۳۴ ببینید تا برچسب SQL/NoSQL گمراهتان نکند؛ SQL را در ۰۳۵ بهعنوان زبان — نه برند — بشناسید؛ و وقتی نیاز پروژه روشن شد، ۱۱۸ را برای انتخاب موتور بخوانید. مقالهٔ قدیمیتر ۰۰۵ هم نمای کلی دیگری از انواع و انتخاب دارد، ولی این سه مقالهٔ سری ۲ را طوری نوشتهایم که از پایه تا تصمیم لایهبندی شوند.
تمرین عملی ۳۰ دقیقهای: یک فروشگاه خیالی را در SQLite یا حتی روی کاغذ به چهار جدول Users، Products، Orders، Payments بشکنید و سه سؤال گزارش بنویسید. اگر نتوانستید سؤال را بدون تکرار داده یا ابهام وضعیت جواب دهید، همانجا جای طراحی را پیدا کردهاید.
جمعبندی
دیتابیس مخزن ساختیافتهٔ داده بههمراه موتوری است که ماندگاری، قواعد و پرسوجو را مدیریت میکند. در مثال فروشگاه، جدا کردن Users، Products، Orders و Payments بهخاطر سلیقهٔ برنامهنویس نیست؛ بهخاطر چرخهٔ عمر و صحت کسبوکار است. فایل و spreadsheet ابزارند، ولی بهتنهایی جایگزین منبع حقیقت اپلیکیشن چندکاربره نیستند.
قدم بعدی منطقی: شناخت انواع پایگاه (رابطهای، سند، کلید-مقدار، گراف، سری زمانی) و سپس زبان SQL بهعنوان واسط رایج با دنیای رابطهای. برای انتخاب عملی موتور، مقالهٔ راهنمای انتخاب را بعد از شفاف شدن نیاز بخوانید.
منابع و مراجع
- PostgreSQL Documentation — What Is PostgreSQL?: https://www.postgresql.org/docs/current/intro-whatis.html
- MySQL 8.4 Reference Manual — What is MySQL?: https://dev.mysql.com/doc/refman/8.4/en/what-is-mysql.html
- SQLite — About SQLite: https://www.sqlite.org/about.html
اگر میخواهید ببینید همین مفهوم چگونه به انتخاب نوع موتور و زبان پرسوجو وصل میشود، ۰۳۴ و ۰۳۵ را ادامه دهید.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.