خروجی ساختاریافته JSON از LLM
6 دقیقه مطالعه
چطور از LLM خروجی JSON معتبر بگیریم؟ schema، اعتبارسنجی، refusal، max_tokens، ترمیم محدود و تست بر پایهٔ مستندات رسمی.
وقتی خروجی مدل زبانی به کد شما میرود (ایجاد تیکت، پر کردن فرم، فراخوانی API)، «متنی که شبیه JSON است» کافی نیست. باید JSON معتبر، با کلیدهای درست و مقدارهای مجاز داشته باشید، و برای موارد خراب، مسیر خطا. این مقاله بر پایهٔ مستندات رسمی OpenAI و Anthropic نشان میدهد چطور schema تعریف کنیم، خروجی را اعتبارسنجی کنیم، رد کنیم و تست کنیم.
منابع و تاریخ: مستندات «Structured outputs» در OpenAI و Anthropic، خواندهشده در ۱۹ اکتبر ۲۰۲۶. جزئیات این قابلیت (مدلهای پشتیبانیشده، محدودیتها) تغییر میکند؛ نام مدل را نمیآوریم و شما باید فهرست روز را از صفحهٔ ارائهدهنده بخوانید. مثالها ساختگیاند و روی API واقعی آزموده نشدهاند. نگاه طراحی «پیشنهاد» نویسنده است مگر به منبع نسبت داده شده باشد. برای قرارداد API REST API چیست را ببینید.
سه سطح اطمینان
| سطح | چه میدهد؟ | کافی است؟ |
|---|---|---|
| درخواست متنی «JSON بده» | متن که شاید JSON باشد | خیر؛ نیاز به parse و ترمیم |
| JSON mode | JSON معتبر، بدون تضمین schema (OpenAI) | فقط برای کار ساده |
| Structured Outputs با schema | پایبندی به schema در بیشتر حالتها | برای ساختار بله؛ برای محتوا خیر |
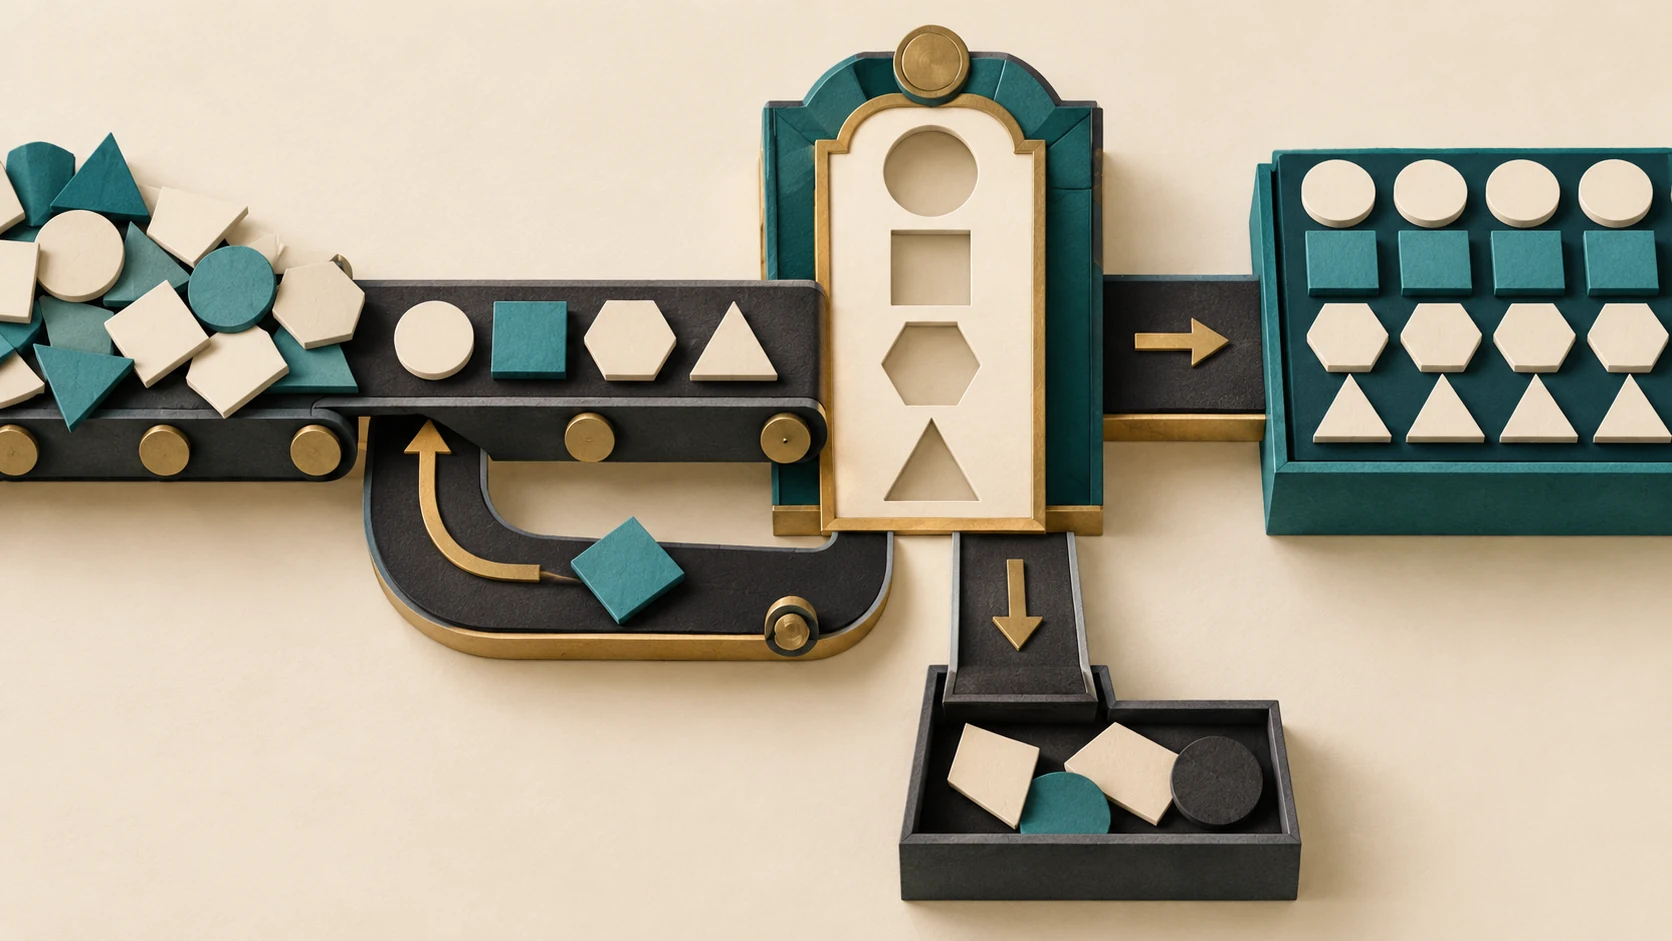
OpenAI میگوید Structured Outputs تضمین میکند پاسخ با JSON Schema شما سازگار باشد (کلید لازم حذف نمیشود و مقدار enum نامعتبر ساخته نمیشود) و تفاوتش با JSON mode این است که JSON mode فقط JSON معتبر میدهد، نه پایبندی به schema؛ توصیهاش هم این است که در صورت امکان همیشه Structured Outputs بهکار رود. اما هر دو منبع صریحاند که «سازگاری با schema» یعنی ساختار، نه درستی محتوا.
طراحی schema
توصیههای رسمی OpenAI: نام کلیدها را روشن و بدیهی بگذارید، برای کلیدهای مهم عنوان و توضیح بنویسید و با eval بهترین ساختار را پیدا کنید. محدودیتها را بشناسید: در OpenAI همهٔ فیلدها باید required باشند و additionalProperties باید false باشد؛ فیلد اختیاری را با نوع «مقدار یا null» مدل میکنند. سقف ۵۰۰۰ ویژگی و ۱۰ سطح تودرتویی دارد و ترتیب خروجی مطابق ترتیب کلیدهای schema است. در Anthropic قیدهایی مثل minimum، maximum، minLength و maxLength پشتیبانی نمیشوند و درخواست با ویژگی پشتیبانینشده خطای ۴۰۰ میدهد؛ helperهای SDK میتوانند این قیدها را به توضیح فیلد منتقل کنند و اگر پاسخ را در کد خودتان اعتبارسنجی کنید، قید اصلی هنوز اجرا میشود.
مثال ساختگی schema برای دستهبندی تیکت:
{
  "type": "object",
  "properties": {
    "category": {"type": "string", "enum": ["payment", "delivery", "account", "other"]},
    "priority": {"type": "string", "enum": ["low", "normal", "high"]},
    "summary": {"type": "string"},
    "needs_human": {"type": "boolean"}
  },
  "required": ["category", "priority", "summary", "needs_human"],
  "additionalProperties": false
}
یک enum با حالت «other» و فیلد needs_human به مدل راه شرافتمندانه برای «نمیدانم» میدهد؛ در غیر این صورت OpenAI هشدار میدهد برای ورودی نامرتبط مدل باز هم میکوشد schema را رعایت کند و ممکن است hallucination کند.
اعتبارسنجی در کد خودتان
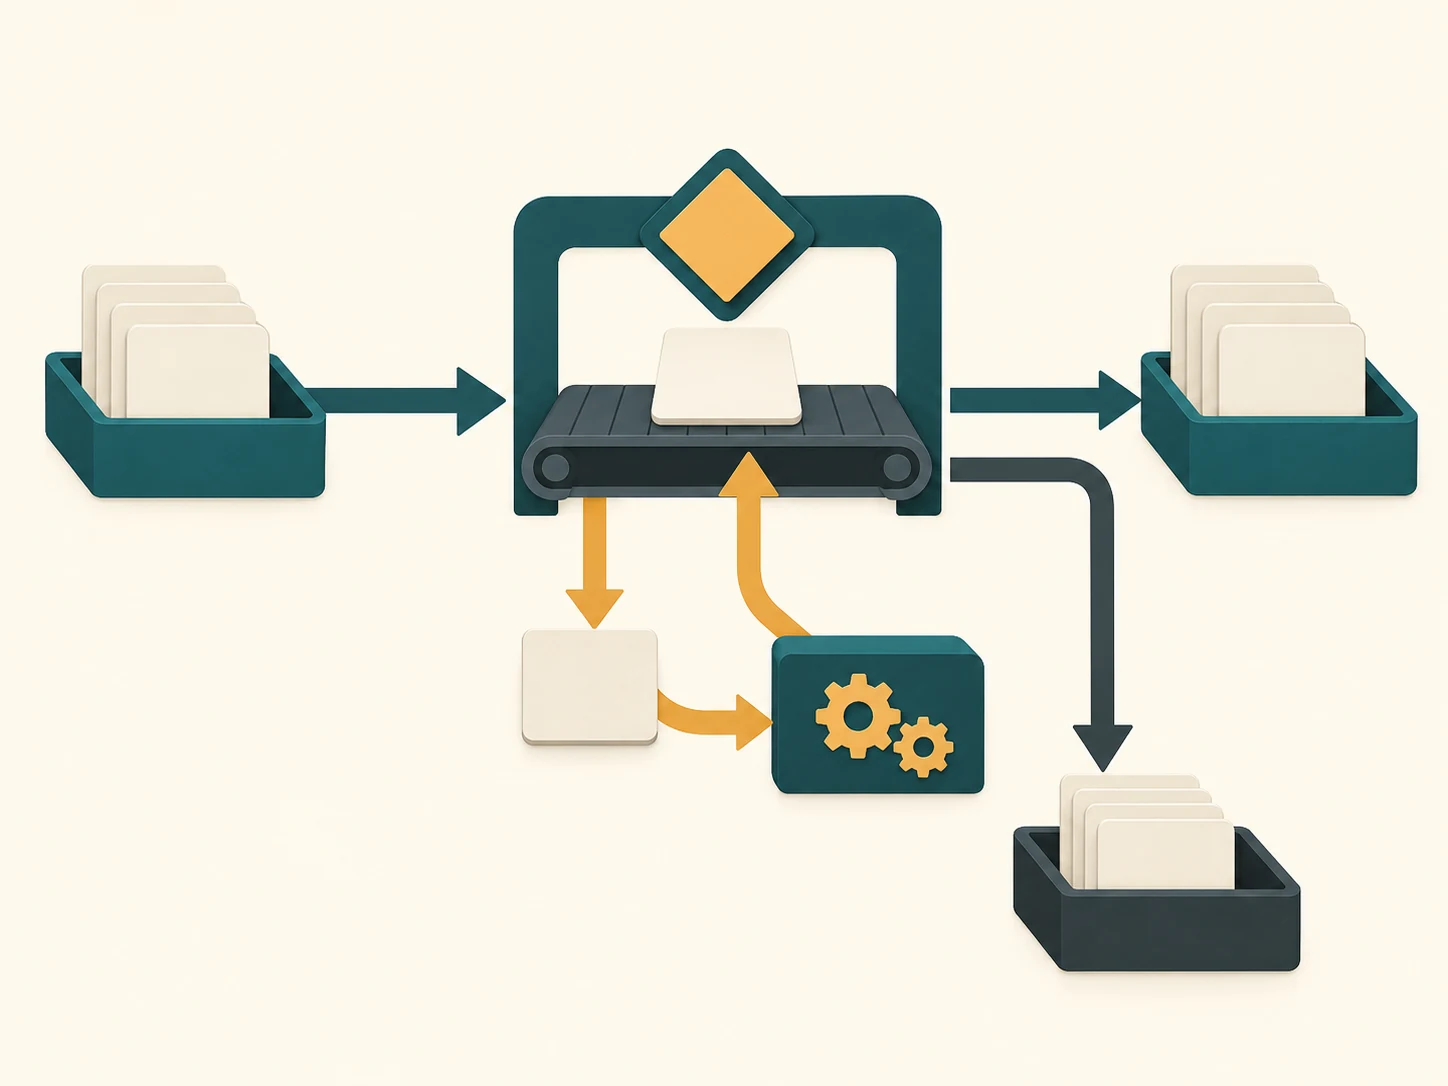
حتی با تضمین ارائهدهنده، مرز اعتماد شما کد خودتان است:
- خروجی را parse کنید؛ اگر شکست خورد، مسیر خطا.
- با schema کامل خودتان (شامل قیدهایی که ارائهدهنده پشتیبانی نمیکند، مثل بازه یا طول) اعتبارسنجی کنید.
- مقدارهای enum را بدون حساسیت به حروف مقایسه کنید: Anthropic هشدار میدهد حروف enum و const تضمین نمیشود و ممکن است پاسخ فقط در حروف با schema فرق داشته باشد.
- قواعد کسبوکار را جدا بررسی کنید (مثلاً دسته مجاز برای آن مشتری، وجود شناسه در پایگاه داده).
- schema و نوعهای کد را همگام نگه دارید: OpenAI توصیه میکند از helperهای SDK یا مرحلهٔ CI برای جلوگیری از واگرایی استفاده شود.
در UI، فرمهای خوب خطا را روشن نشان میدهند؛ همین اصل برای رد خروجی مدل هم صادق است (طراحی فرم).
مسیر خطا و رد کردن
سه شکست ویژه که منابع شرح میدهند:
- Refusal: OpenAI میگوید refusalهای ایمنی قابلتشخیصاند. در Anthropic،
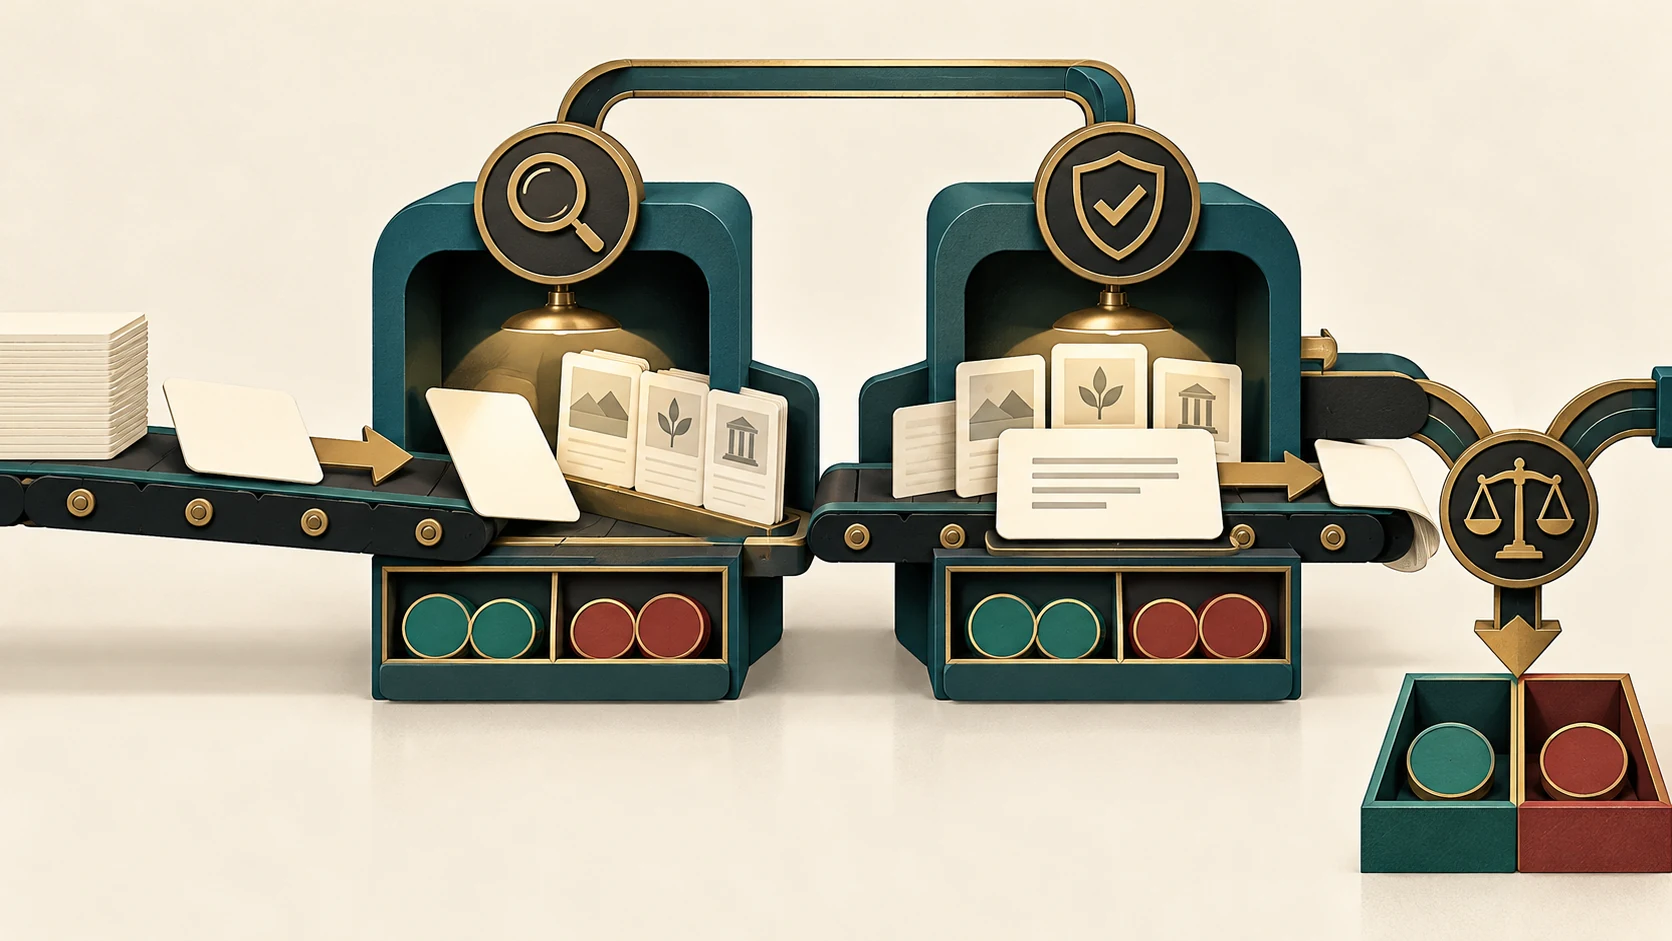
stop_reason: "refusal"با وضعیت ۲۰۰ میآید، توکنها صورتحساب میشوند و خروجی ممکن است با schema نخواند. پس همیشه قبل از parse، دلیل توقف را بررسی کنید. - رسیدن به سقف توکن: در Anthropic
stop_reason: "max_tokens"یعنی JSON ممکن است ناقص باشد؛ راه، تلاش دوباره با max_tokens بزرگتر است. حد خروجی را از اندازهٔ بیشینهٔ schema تخمین بزنید. - ورودی نامرتبط: OpenAI میگوید مدل میکوشد schema را رعایت کند و میتواند hallucination کند؛ پس در prompt بگویید اگر ورودی مناسب نیست مقدار خالی یا مقدار مشخص بدهد.
ترمیم محدود
(توصیهٔ نویسنده) ترمیم خودکار را محدود کنید: یک بار تلاش دوباره با پیام خطای اعتبارسنجی و بس. تلاشهای متعدد هزینه و تأخیر میسازند و میتواند خروجی مسیر نادرست را «تمیز» کند. پس از دو شکست، رد کنید و به مسیر انسانی یا پیشفرض امن بروید.
«schema درست» همان «پاسخ درست» نیست
OpenAI صریح میگوید Structured Outputs هنوز میتواند اشتباه داشته باشد؛ راهحلها: تغییر دستورها، دادن مثال در prompt سیستم، و شکستن کار به زیرکارهای سادهتر. مثلاً category: "payment" از نظر schema درست است حتی اگر تیکت دربارهٔ ارسال باشد. بنابراین کیفیت را جدا با مجموعهٔ نمونه و eval بسنجید، و تصمیمهای پرریسک را با انسان تأیید کنید.
هزینه و تأخیر
Anthropic میگوید کامپایل schema به گرامر تأخیر اضافه میکند، گرامر کامپایلشده ۲۴ ساعت از آخرین استفاده کش میشود و تغییر ساختار schema کش را باطل میکند. تغییر فقط در نام یا توضیح فیلد کش را باطل نمیکند. همچنین prompt اضافهای برای توضیح قالب به ورودی افزوده میشود و توکن ورودی کمی بیشتر میشود. پس schema را پایدار نگه دارید و آن را در هر درخواست تغییر ندهید. قابلیت با citations و prefill سازگار نیست (Anthropic) و هر ارائهدهنده محدودیتهای خود را دارد.
تست
- مجموعهای از ورودیهای واقعی، مبهم و بیربط (حتماً «ورودی بیربط» و «ورودی خالی»).
- تست قرارداد: schema و نوع کد با هم همگام باشند.
- تست شکست: refusal، max_tokens کم، خروجی ناقص شبیهسازیشده.
- تست enum و حروف.
- تست رگرسیون با تغییر مدل یا schema؛ نسخهٔ مدل و تاریخ را ثبت کنید.
- پایش نرخ رد و شکست در تولید (پایش سیستم).
اشتباهات رایج
- اعتماد به «JSON بده» در prompt و parse با regex.
- باور اینکه schema درست یعنی محتوای درست.
- نبودن گزینهٔ «نامشخص» در enum.
- نادیده گرفتن refusal و max_tokens.
- ترمیم بیپایان بهجای رد.
- تغییر schema در هر درخواست و از دست دادن کش.
- مقایسهٔ حساس به حروف برای enum.
چکلیست
- از Structured Outputs یا معادل رسمی ارائهدهنده با schema استفاده میکنیم، نه فقط prompt.
- همهٔ فیلدها required، additionalProperties:false و enum با «other/unknown» داریم.
- قبل از parse، stop_reason یا refusal بررسی میشود.
- خروجی در کد با قیدهای کامل و قواعد کسبوکار اعتبارسنجی میشود.
- ترمیم حداکثر یک بار است و بعد رد میشود.
- schema و نوعهای کد همگاماند و در CI بررسی میشوند.
- مجموعهتست شامل ورودی بیربط و شکستهاست.
- نسخهٔ مدل و تاریخ مستندات ثبت شده است.
منابع و مراجع
- Structured model outputs — OpenAI API Docs، 2026-10-19.
- Structured outputs — Anthropic (Claude Platform Docs)، 2026-10-19.
نویسنده
سا
سهیل ابراهیمپور بنیانگذار FutureForge است. روی طراحی محصول، معماری و استقرار نرمافزار سفارشی کار میکند.
یادداشتهای مرتبط
برای انتخاب مسیر فنی پروژهتان کمک میخواهید؟
از مسئله و محدودیتهایتان بگویید؛ اگر بتوانیم همراهیتان کنیم، برای گفتوگو هماهنگ میکنیم.